Kategori: Popüler Kültürü Kodluyorum

  • Monopoly’de En Değerli Kareler: Monte Carlo Simülasyonu

    Monopoly’de En Değerli Kareler: Monte Carlo Simülasyonu

    Monopoly oynarken herkesin bir teorisi vardır: “Laciverti al, oyun biter.” “Demiryolları sağlam para.” “Kahverengi sadece başlangıç için.” Peki bu teoriler ne kadar doğru?

    Bir arsanın değerli olması için önce oyuncuların ona basması gerekiyor. Bu yazıda tek bir soruya cevap arıyoruz: Monopoly tahtasında en çok hangi karelere basılıyor? Cevabı formülle değil, oyunu bilgisayara bir milyon tur oynatarak bulacağız.
    Tüm kodlar Colab’da, tek tıkla açılıyor: Colab’da aç

    Monte Carlo nedir?

    Bir şeyin ihtimalini hesaplamak zorsa, onu çok kez rastgele deneyip sonuçları sayabilirsin. Buna Monte Carlo simülasyonu deniyor. Adını Monaco’daki ünlü kumarhane semtinden alıyor; rastgelelik ve şans üzerine kurulu bir yöntem için yerinde bir isim.

    Önce cevabını bildiğimiz bir soruyla deneyelim: İki zar atınca toplamın 7 gelme ihtimali kaç? Matematikle cevap 6/36, yani yaklaşık yüzde 16,67.

    import random
    from collections import Counter
    def zar_toplami_dene(atis_sayisi, tohum=1):
    rnd = random.Random(tohum)
    sayac = Counter(rnd.randint(1, 6) + rnd.randint(1, 6) for _ in range(atis_sayisi))
    return sayac[7] / atis_sayisi * 100
    for n in [100, 10_000, 1_000_000]:
    print(f"{n:>9,} atış -> 7 gelme oranı: %{zar_toplami_dene(n):.2f}")
          100 atış -> 7 gelme oranı: %20.00
       10,000 atış -> 7 gelme oranı: %16.75
    1,000,000 atış -> 7 gelme oranı: %16.65

    100 atışta sonuç %20 çıkıyor, epey sapmış. Bir milyon atışta gerçek değere neredeyse yapışıyor. Monte Carlo’nun bütün fikri bu: Yeterince çok denersen rastgelelik dengelenir.

    Monopoly’de kartlar, hapis ve çift zar kuralları yüzünden formül çok karışık. Ama simülasyonun mantığı aynı kalıyor.

    Tahtayı ve kuralları koda dökmek

    Tahtada 40 kare var. Klasik ABD tahtasının kare adlarını bir listeye yazıyoruz; listenin sırası tahtadaki sıra. Simülasyona koyduğumuz kurallar:

    • İki zar atılır, toplam kadar ilerlenir.
    • Çift atan bir daha atar; üst üste üçüncü çift hapse gönderir.
    • Hapse Gir karesine gelen hapse gider.
    • 16 Şans kartından 10’u oyuncuyu bir yere gönderir: Başlangıç, Illinois Ave, St. Charles Place, Reading Demiryolu, Boardwalk, hapis, en yakın şirket, iki kez en yakın demiryolu ve 3 kare geri.
    • 16 Kamu Fonu kartından 2’si oyuncuyu gönderir: Başlangıç ve hapis.
    • Kartlar karıştırılır, çekilen kart destenin altına gider.

    Kartları birer metin listesi olarak tutuyoruz. Bir kart çekmek, listenin başındaki elemanı alıp sona koymak demek:

    k = sans.pop(0)
    sans.append(k)
    konum = sans_karti(k, konum)

    Simülasyonun kalbi olan simule() fonksiyonu yaklaşık 30 satır. Her turda zar atıyor, kuralları uyguluyor ve piyonun durduğu kareyi bir Counter‘a yazıyor. Kodun tamamı not defterinde; burada sonuçlara bakalım.

    Bir milyon tur sonra

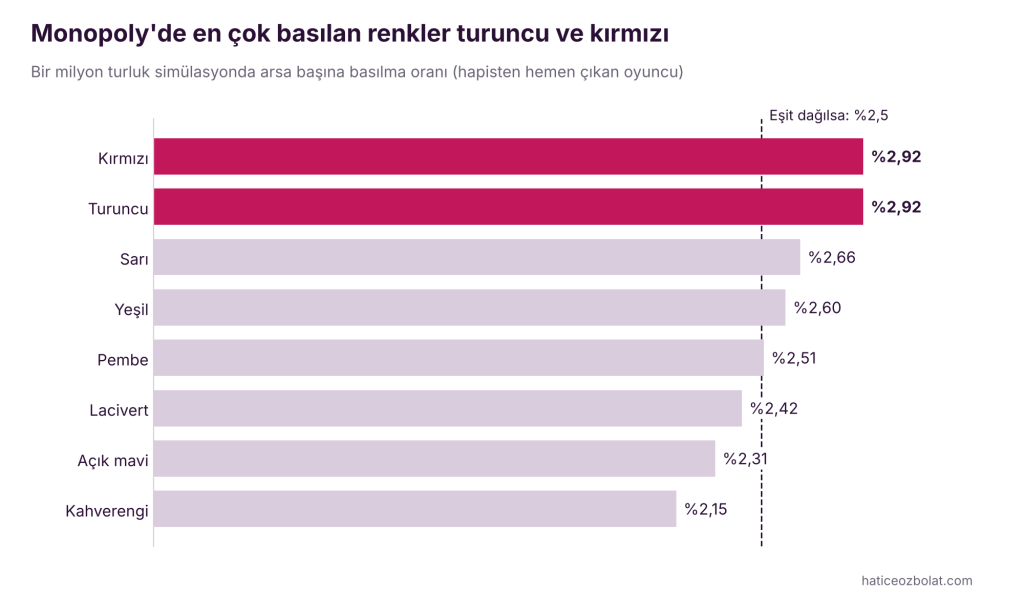
    Eşit ihtimal olsaydı her kareye yüzde 2,5 düşerdi. Ama tahta hiç de eşit değil. Hapisten hemen çıkan bir oyuncu için en çok basılan 10 kare:

    SıraKareBasılma oranı
    1Hapis%6,15
    2Illinois Ave%3,19
    3Başlangıç%3,09
    4New York Ave%3,06
    5B&O Demiryolu%3,06
    6Reading Demiryolu%2,97
    7Pennsylvania Demiryolu%2,93
    8Tennessee Ave%2,92
    9Ücretsiz Otopark%2,91
    10Su İdaresi%2,83

    Bu tablodan üç şey çıkıyor:

    • Hapis açık ara birinci. Oraya giden üç yol var: Hapse Gir karesi, Şans ve Kamu Fonu kartları, üst üste üç çift. Başka hiçbir kare bu kadar “trafik” almıyor.
    • Illinois Ave en çok basılan arsa. Şans destesindeki kartlardan biri doğrudan oraya gönderiyor.
    • Demiryolları listede üç kez var. İki Şans kartı “en yakın demiryoluna git” diyor.

    Listenin en altında ise Şans kareleri var: Buraya gelen oyuncuların çoğu çektiği kartla başka yere gidiyor. Hapse Gir karesinin oranı ise sıfır, çünkü oraya gelen piyon anında hapse taşınıyor.

    Renk grupları: hangisi önde?

    Monopoly’de asıl para, bir renk grubunun tamamını alıp ev kurmaktan geliyor. Grupların kare sayısı farklı (2 ya da 3), o yüzden adil karşılaştırma için arsa başına oranı hesaplıyoruz:

    GRUPLAR = {
    "Kahverengi": [1, 3], "Açık mavi": [6, 8, 9], "Pembe": [11, 13, 14], "Turuncu": [16, 18, 19],
    "Kırmızı": [21, 23, 24], "Sarı": [26, 27, 29], "Yeşil": [31, 32, 34], "Lacivert": [37, 39],
    }
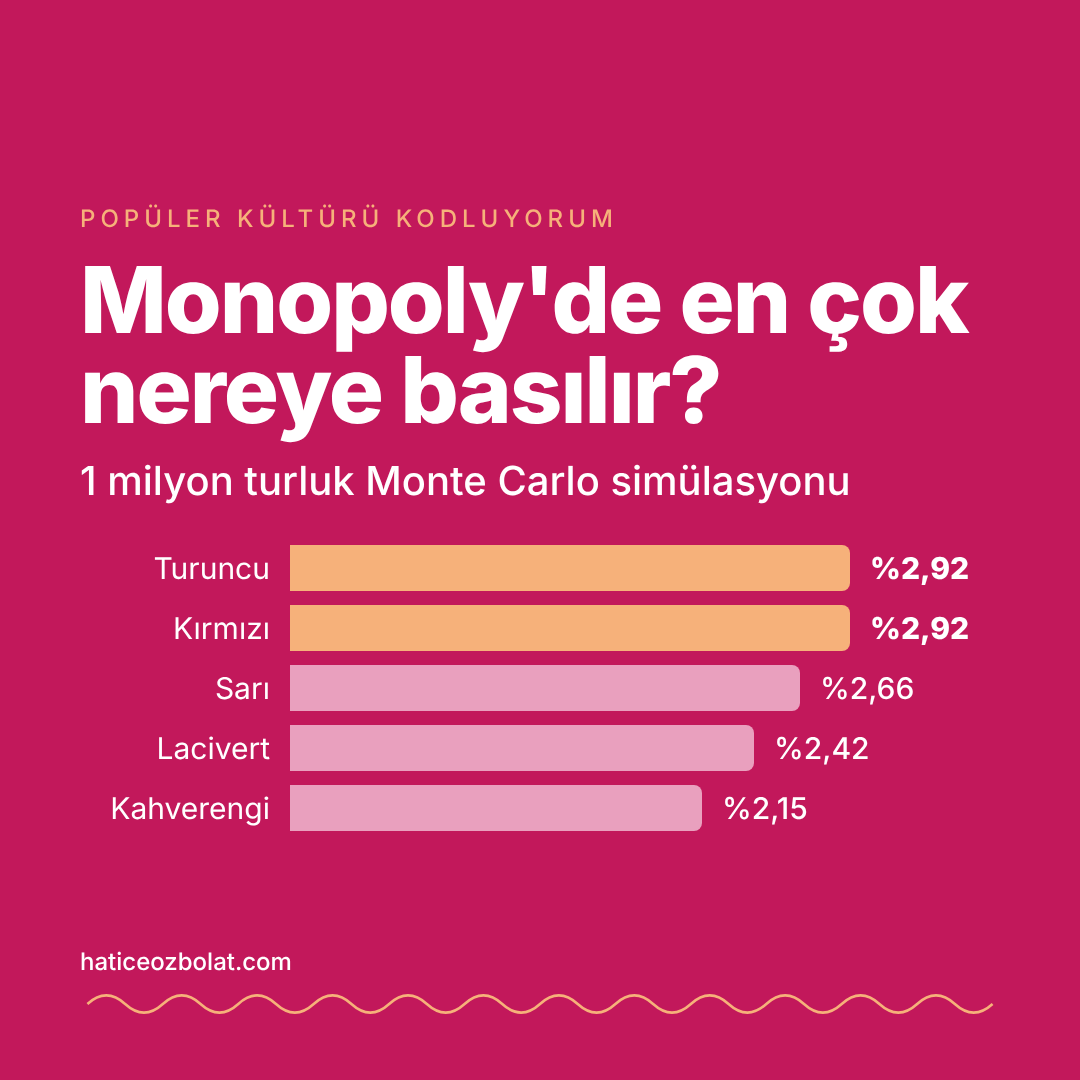
    Monopoly renk gruplarında arsa başına basılma oranı. Turuncu ve kırmızı %2,92 ile başta; sonra sarı %2,66, yeşil %2,60, pembe %2,51, lacivert %2,42, açık mavi %2,31 ve kahverengi %2,15. Eşit dağılımda oran %2,5 olurdu.

    Turuncu ve kırmızı başa baş önde, kahverengi en geride. Asıl sürpriz lacivert: Oyunun en pahalı grubu, ama arsa başına basılma oranı ortalamanın altında. Boardwalk’ı bir Şans kartı kurtarıyor; Park Place ise kendi başına kalıyor.

    Turuncunun sırrı: hapisten çıkış

    Hapis tahtada 10. kare ve oyuncular oraya çok sık gidiyor. Hapisten çıkan oyuncu iki zar atıyor. Turuncu kareler hapisten tam 6, 8 ve 9 kare ileride.

    İki zarda hangi toplamın kaç farklı yolla gelebildiğine bakalım:

     2: █  1/36
     3: ██  2/36
     4: ███  3/36
     5: ████  4/36
     6: █████  5/36
     7: ██████  6/36
     8: █████  5/36
     9: ████  4/36
    10: ███  3/36
    11: ██  2/36
    12: █  1/36

    6, 8 ve 9 toplamları en sık gelenlerden. Toplarsak: (5 + 5 + 4) / 36, yani hapisten çıkan bir oyuncunun tek atışta turuncu bir kareye basma ihtimali yüzde 38,9. Hapis ne kadar kalabalıksa turuncu o kadar kazanıyor.

    Kırmızının arkasındaki güç ise Şans destesi: Illinois Ave kartı.

    Hapiste beklersen ne değişir?

    Oyunun sonlarına doğru oyuncular genelde hapiste kalmayı tercih eder. Tahta evlerle dolmuştur ve dolaşmak pahalıdır; hapiste otururken kira ödemezsin ama kira toplamaya devam edersin. Aynı simülasyonu “çift atana kadar bekle” stratejisiyle çalıştırdığımızda:

    • Hapis karesinin payı yüzde 6,15’ten yüzde 11,50’ye çıkıyor.
    • Turuncu arsa başına yüzde 2,77 ile kırmızının (yüzde 2,73) önüne geçiyor.

    Yani oyun ilerledikçe turuncunun avantajı büyüyor. “Turuncuyu al” tavsiyesinin arkasındaki matematik bu.

    Sınırlar

    Bu simülasyon sadece basılma ihtimalini ölçüyor. Bir grubun gerçekten ne kadar kârlı olduğu arsanın fiyatına, ev maliyetine ve kiraya da bağlı; bunları modele katmadık. Kuralların da klasik sürümünü kullandık, evdeki özel kurallar (Ücretsiz Otopark’ta para toplamak gibi) sonucu değiştirmiyor ama farklı bir tahta sürümü değiştirebilir.

    Yine de basılmayan bir arsadan kira alamazsın. O yüzden bu tablo iyi bir başlangıç noktası.

    Devamını oku: Netflix’te Ne İzlesem? Basit Bir Öneri Sistemi Yazmak

    Kendin dene

    1. TUR değerini 1.000’e indir. Sonuçlar ne kadar oynuyor? Kaç turdan sonra sıralama oturuyor?
    2. Şans destesinden Illinois kartını çıkar. Illinois Ave hâlâ en çok basılan arsa mı?
    3. Demiryollarını bir grup olarak ekle ([5, 15, 25, 35]). Arsa başına oranları nasıl?
    4. Hapiste en fazla bir tur beklenebilsin. Turuncunun avantajına ne oluyor?

    Devamını oku: Futbol Veri Projesi 1: Maç Verisini Toplamak ve Temizlemek

    Monopoly, Hasbro’nun tescilli markasıdır. Bu yazı oyunla resmî bir bağlantı taşımıyor; kare adları klasik ABD tahtasından, görseller kendi grafiklerimiz.
  • Netflix’te Ne İzlesem? Basit Bir Öneri Sistemi Yazmak

    Netflix’te Ne İzlesem? Basit Bir Öneri Sistemi Yazmak

    Bir diziyi bitirdin, ekranın altında hemen “Bunu sevdiysen bunları da izle” listesi beliriyor. Bu listeyi hazırlayan şey bir öneri sistemi. Gerçek platformların öneri sistemleri milyonlarca kullanıcının verisiyle çalışıyor ve çok karmaşık. Ama temel fikir, birkaç satır Python’la kurulabilecek kadar sade.

    Bu yazıda 20 dizilik küçük bir katalogla kendi öneri sistemimizi yazıyoruz. Python Dersi 12’de öğrendiğimiz kümeler burada ana malzeme olacak.

    Kodların hepsi Colab’da hazır: Colab’da Aç

    Veri hakkında: Katalogdaki dizi adları gerçek, ama etiketleri ben verdim; öznel ve eksik olabilirler. Netflix’in verisi, görselleri ya da logosu kullanılmıyor. Bu sistem Netflix’in kendi öneri sistemini taklit etmiyor, sadece öneri sistemlerinin temel fikrini gösteriyor.

    Öneri sistemleri nasıl çalışır?

    İki temel yaklaşım var:

    • İçerik tabanlı öneri: “Bu dizi bilim kurgu ve gizem, sen de bilim kurgu ve gizem seviyorsun, o zaman bunu da seversin.” İçeriğin özelliklerine bakıyor.
    • İşbirlikçi filtreleme: “Seninle benzer şeyleri izleyen kişiler şunu da izledi.” İçeriğe hiç bakmadan, kullanıcıların davranışlarına bakıyor.

    Büyük platformlar ikisini ve daha fazlasını birlikte kullanıyor. Bizim elimizde kullanıcı verisi olmadığı için birincisini kuracağız.

    1. Katalog: her dizi bir etiket kümesi

    Her diziyi birkaç etiketten oluşan bir küme olarak tanımlayalım. Toplam 20 dizi var; birkaçını gösterelim:

    KATALOG = {
    "Stranger Things": {"bilim kurgu", "korku", "gençlik", "80'ler", "gizem"},
    "Dark": {"bilim kurgu", "gizem", "zaman yolculuğu", "aile", "Almanya"},
    "Black Mirror": {"bilim kurgu", "teknoloji", "antoloji", "distopya"},
    "Squid Game": {"gerilim", "hayatta kalma", "Kore", "distopya"},
    "The Crown": {"drama", "tarih", "biyografi", "gerçek hikâye"},
    # ... toplam 20 dizi, tam liste not defterinde
    }

    Neden liste değil de küme? Çünkü birazdan iki dizinin ortak etiketlerini bulacağız, bu da tam olarak bir küme kesişimi.

    2. İki dizi ne kadar benziyor? Jaccard benzerliği

    Dark ile Stranger Things’i karşılaştıralım:

    • Ortak etiketler (&, kesişim): bilim kurgu, gizem → 2
    • İkisindeki bütün farklı etiketler (|, birleşim): 8

    İki sayıyı birbirine bölünce 2 / 8 = 0,25 çıkıyor. Bu orana Jaccard benzerliği deniyor. 0 hiç ortak etiket yok, 1 tamamen aynı demek.

    def jaccard(a, b):
    """İki kümenin ortak eleman sayısının, toplam farklı eleman sayısına oranı."""
    return len(a & b) / len(a | b)
    print(jaccard(KATALOG["Dark"], KATALOG["Stranger Things"])) # 0.25

    Neden sadece ortak etiket sayısına bakmıyoruz da birleşime bölüyoruz? Çünkü çok etiketi olan bir dizi, sadece etiketi çok diye her şeye “benzer” çıkmasın. Bölme işlemi bunu dengeliyor.

    3. “Bunu sevdiysen” önerileri

    Bir diziyi katalogdaki diğer bütün dizilerle karşılaştırıp en benzer beşini sıralayalım:

    def benzerleri(dizi, n=5):
    hedef = KATALOG[dizi]
    puanlar = {d: jaccard(hedef, etiket) for d, etiket in KATALOG.items() if d != dizi}
    return sorted(puanlar.items(), key=lambda x: -x[1])[:n]
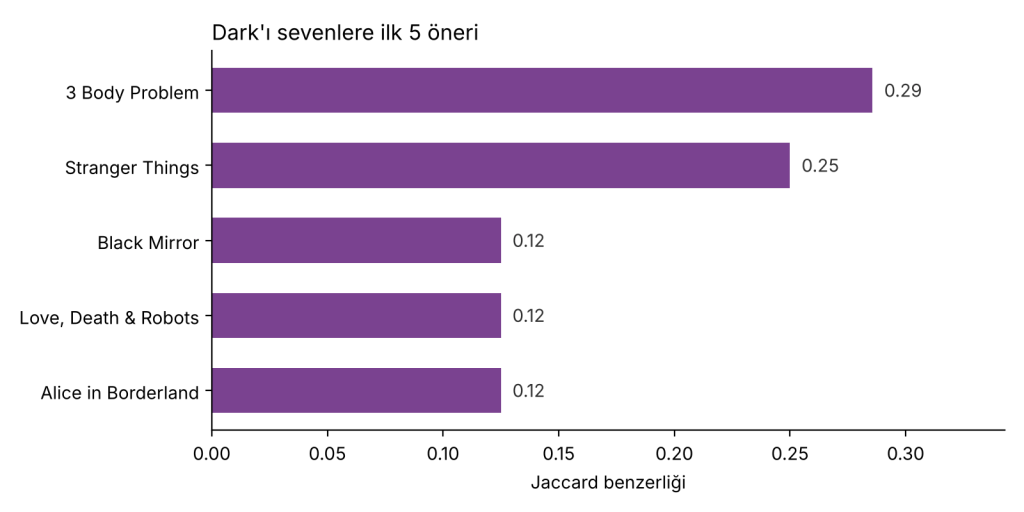
    for ad, puan in benzerleri("Dark"):
    print(f"{ad:<22} {puan:.2f}")
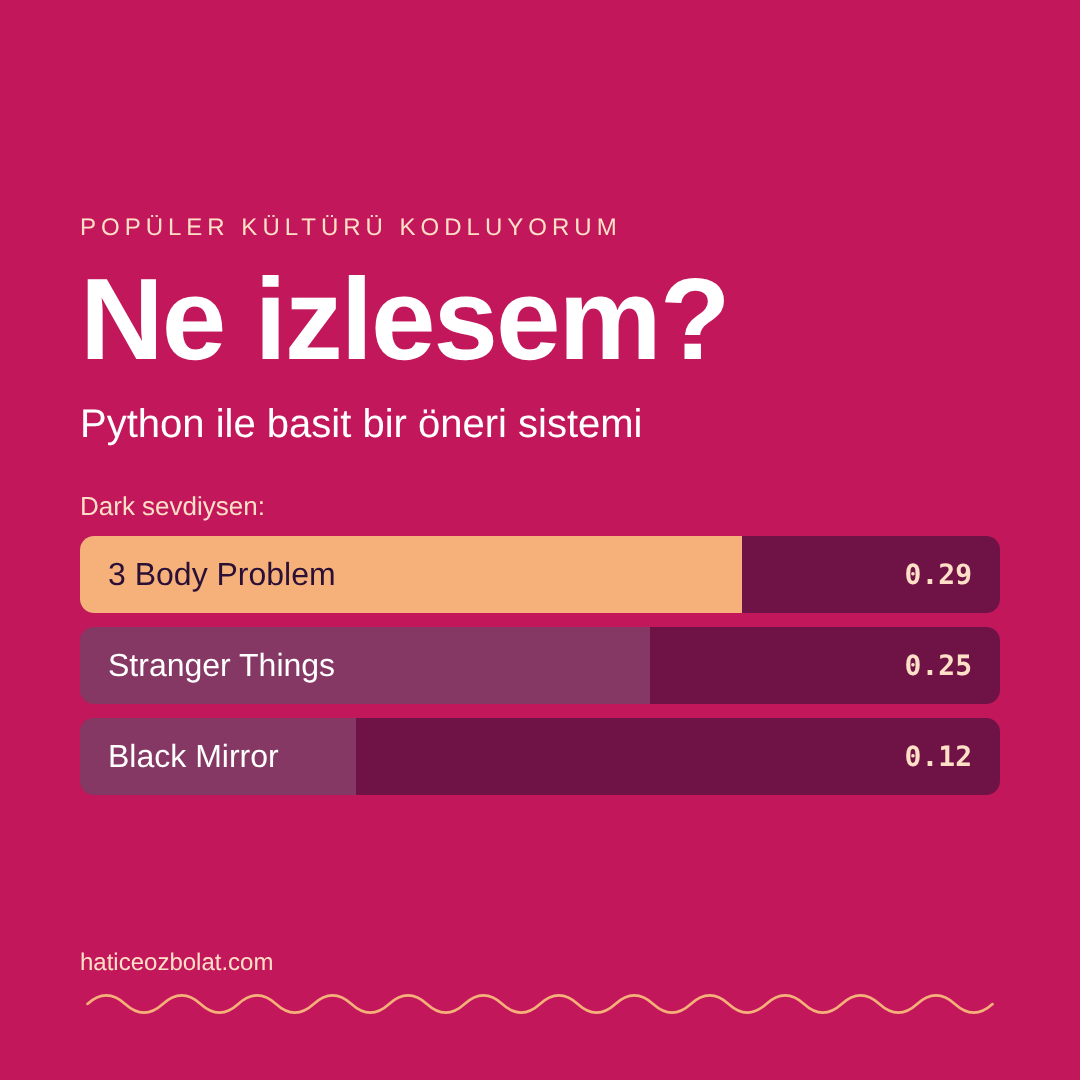
    3 Body Problem 0.29
    Stranger Things 0.25
    Black Mirror 0.12
    Love, Death & Robots 0.12
    Alice in Borderland 0.12

    Sözlük üreteci (Ders 12) her diziye bir puan veriyor; sorted ve key=lambda x: -x[1] de puana göre büyükten küçüğe sıralıyor. Squid Game için ilk sırada Alice in Borderland (0,33), The Crown için Narcos (0,60) çıkıyor.

    4. Birden fazla diziden zevk profili çıkarmak

    Tek bir diziye bakmak yerine sevdiğin birkaç diziden bir zevk profili çıkaralım. Kod Kartı #07’deki Counter burada işe yarıyor: Sevdiğin dizilerin etiketlerini sayıyoruz, sonra her diziye etiketlerinin bu profildeki toplam ağırlığına göre puan veriyoruz.

    from collections import Counter
    def profil_oner(begenilenler, n=5):
    profil = Counter()
    for dizi in begenilenler:
    profil.update(KATALOG[dizi])
    puanlar = {
    d: sum(profil[e] for e in etiket) / len(etiket)
    for d, etiket in KATALOG.items() if d not in begenilenler
    }
    return profil, sorted(puanlar.items(), key=lambda x: -x[1])[:n]
    profil, oneriler = profil_oner(["Dark", "Black Mirror", "Mindhunter"])
    Love, Death & Robots 1.00
    3 Body Problem 0.75
    Ozark 0.75
    Stranger Things 0.60
    Squid Game 0.50

    Bu üç dizide “bilim kurgu” iki kez geçtiği için profilde en ağır etiket o. Love, Death & Robots’un dört etiketinden üçü (bilim kurgu, teknoloji, antoloji) profilde var ve ilk sıraya yerleşiyor.

    Sistemimiz nerede yanılıyor?

    Sonuçlara dikkatli bakınca sistemin zayıf yanları hemen görünüyor. Bunlar gerçek öneri sistemlerinin de uğraştığı sorunlar:

    • Etiketler kaba. The Crown’ı sevene ilk öneri Narcos, çünkü ikisi de “drama, biyografi, gerçek hikâye”. Ama bir kraliyet ailesi dramını seven herkes uyuşturucu kartellerini anlatan bir diziyi sevmeyebilir. İçerik tabanlı bir sistem, verdiğin etiketler kadar akıllı.
    • Tek bir etiket fazla ağır basabiliyor. Profil örneğinde Ozark üçüncü sırada; sebeplerinden biri Dark’tan gelen “aile” etiketi. Oysa Dark’ı sevmemizin sebebi muhtemelen aile değil, zaman yolculuğu.
    • Eşitlikler. Dark için üç dizi aynı puanda (0,12). Aralarındaki sırayı sadece katalogdaki yazım sırası belirliyor.
    • Hep aynı şeyler. Sadece benzer içerik öneren bir sistem, seni bilim kurgu dışına hiç çıkarmayabilir. Buna filtre balonu deniyor.
    • Yeni dizi sorunu. Henüz etiketlenmemiş bir dizi hiç önerilmez. İşbirlikçi filtrelemede de benzer bir sorun var: Kimsenin izlemediği yeni bir dizi için davranış verisi yok. Buna soğuk başlangıç (cold start) sorunu deniyor.

    Kendin dene

    1. Kataloğa sevdiğin üç diziyi kendi etiketleriyle ekle ve profil_oner ile kendine öneri al.
    2. The Crown için Narcos neden en benzer çıkıyor? Etiketleri değiştirerek bunu düzelt.
    3. profil_oner içinde etiket sayısına bölmeyi kaldır. Sonuçlar nasıl değişiyor, neden?
    4. Jaccard yerine sadece ortak etiket sayısını (len(a & b)) kullan ve sonuçları karşılaştır.

    Bu projede ne öğrendik?

    • Öneri sistemlerinin iki temel yaklaşımı: içerik tabanlı ve işbirlikçi filtreleme.
    • Kümelerle iki öğenin benzerliğini Jaccard oranıyla ölçmek.
    • Birden fazla beğeniden Counter ile bir profil çıkarmak.
    • Bir modelin sonuçlarına bakıp zayıf yanlarını bulmak: kaba etiketler, filtre balonu, soğuk başlangıç.

    Devamını oku

  • Harry Potter’ın Seçmen Şapkası: Basit Bir Sınıflandırma Modeli

    Harry Potter’ın Seçmen Şapkası: Basit Bir Sınıflandırma Modeli

    Hogwarts’a gelen her öğrenci başına eski bir şapka takıyor ve şapka birkaç saniye içinde karar veriyor: Gryffindor, Ravenclaw, Hufflepuff ya da Slytherin. Bir veri bilimci gözüyle bakınca Seçmen Şapkası aslında bir sınıflandırma modeli: girdi olarak bir öğrenciyi alıyor, çıktı olarak dört etiketten birini veriyor.

    Bu yazıda kendi şapkamızı iki kez kuracağız. Önce elle yazılmış kurallarla, sonra örneklerden öğrenen bir karar ağacıyla. Yolda makine öğreniminin üç temel fikrine değeceğiz: eğitim ve test verisi, modelin nerede yanıldığını görmek ve aşırı öğrenme.

    Hogwarts Legacy oyununda şapka beni Ravenclaw’a göndermişti. Bu yazı için de aklımdaki soru şuydu: Bu kararı bir model verseydi, neye bakarak verirdi?

    Kodların hepsi Colab’da hazır, kurulum gerekmiyor: Colab’da Aç

    Veri hakkında: Yazıdaki öğrencilerin hepsi hayali. Veriyi kod kendisi üretiyor; kitaplardan ya da filmlerden hiçbir karakter, metin veya görsel kullanmıyoruz.

    Şapkaya ne soruyoruz?

    Her öğrenciyi dört özellikle tarif edelim ve her birine 0 ile 10 arasında puan verelim: cesaret, zeka, sadakat ve hırs. Her binanın öne çıkardığı bir özellik var: Gryffindor cesareti, Ravenclaw zekayı, Hufflepuff sadakati, Slytherin hırsı.

    Makine öğrenimi dilinde bu dört puan öznitelik (feature), bina adı ise etiket (label). Modelin işi özniteliklere bakıp etiketi tahmin etmek.

    1. Kural tabanlı şapka

    En akla yatkın kural: öğrencinin en yüksek özelliğine bak, o özelliğin binasına gönder.

    OZELLIKLER = ["cesaret", "zeka", "sadakat", "hirs"]
    BINALAR = {"Gryffindor": "cesaret", "Ravenclaw": "zeka",
    "Hufflepuff": "sadakat", "Slytherin": "hirs"}
    def kural_sapka(ogrenci):
    """En yüksek puanlı özelliğe bakıp binayı seçer."""
    en_guclu = max(OZELLIKLER, key=lambda o: ogrenci[o])
    for bina, ozellik in BINALAR.items():
    if ozellik == en_guclu:
    return bina
    print(kural_sapka({"cesaret": 9, "zeka": 6, "sadakat": 7, "hirs": 4}))
    # Gryffindor
    print(kural_sapka({"cesaret": 5.2, "zeka": 5.4, "sadakat": 5.1, "hirs": 5.3}))
    # Ravenclaw

    İlk öğrencide sorun yok. İkincisine bak: dört özelliği de neredeyse eşit, zekası sadece 0,1 puan önde diye Ravenclaw’a gidiyor. Kuralın bu öğrenci hakkında “emin değilim” deme imkanı yok. İnsan eliyle yazılan kuralların genel derdi bu: düşündüğün durumlarda çalışıyor, düşünmediğin durumlarda sessizce yanılıyor.

    max satırındaki key=lambda o: ogrenci[o] ifadesi, “özellik adlarını karşılaştırırken her birinin puanına bak” demek. Fonksiyonları bugünkü Python Dersi 9’da anlattım; lambda ise tek satırlık, isimsiz bir fonksiyon.

    2. Hayali öğrenciler üretmek

    Model örneklerden öğreneceği için bize etiketli veri lazım. Her binadan 60, toplam 240 hayali öğrenci üretelim. Gryffindor, Ravenclaw ve Slytherin öğrencilerinde binanın özelliği belirgin şekilde yüksek olsun.

    Hufflepuff’a bir büküm ekleyelim. Hufflepuff, kapısını herkese açan bina olarak bilinir. Bu yüzden öğrencilerin yarısında sadakat yüksek, diğer yarısında ise hiçbir özellik öne çıkmıyor. Kural tabanlı şapka bu ikinci grubu bilmiyor; bakalım model fark edebilecek mi?

    import numpy as np
    import pandas as pd
    rng = np.random.default_rng(42)
    satirlar = []
    for bina, baskin in BINALAR.items():
    for i in range(60):
    if bina == "Hufflepuff" and i % 2 == 1:
    # Dengeli öğrenci: hiçbir özellik öne çıkmıyor
    ogr = {o: rng.normal(5, 0.7) for o in OZELLIKLER}
    ogr["sadakat"] = rng.normal(5.5, 0.7)
    else:
    ogr = {o: rng.normal(4.5, 1.2) for o in OZELLIKLER}
    ogr[baskin] = rng.normal(8, 1)
    ogr = {o: float(np.clip(round(v, 1), 0, 10)) for o, v in ogr.items()}
    ogr["bina"] = bina
    satirlar.append(ogr)
    df = pd.DataFrame(satirlar)
    print(df.groupby("bina")[OZELLIKLER].mean().round(1))
                cesaret  zeka  sadakat  hirs
    bina
    Gryffindor      7.8   4.4      4.5   4.6
    Hufflepuff      4.8   4.9      6.5   4.4
    Ravenclaw       4.3   8.1      4.6   4.3
    Slytherin       4.6   4.6      4.5   7.8

    rng.normal(8, 1), ortalaması 8 olan ve çoğunlukla 7 ile 9 arasına düşen rastgele bir sayı üretiyor. np.clip puanları 0 ile 10 arasında tutuyor. default_rng(42) içindeki 42 sayesinde kodu her çalıştırdığında aynı öğrenciler üretiliyor, böylece sen de yazıdaki sonuçların aynısını görüyorsun.

    3. Eğitim ve test verisi

    Bir modeli, öğrendiği örneklerle sınamak sınavdan önce cevap anahtarını vermeye benzer. Bu yüzden veriyi ikiye ayırıyoruz: model 180 öğrenciden öğrenecek, hiç görmediği 60 öğrenciyle sınanacak.

    from sklearn.model_selection import train_test_split
    from sklearn.metrics import accuracy_score
    X = df[OZELLIKLER]
    y = df["bina"]
    X_egitim, X_test, y_egitim, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
    )
    kural_tahmin = [kural_sapka(ogr) for ogr in X_test.to_dict("records")]
    print(f"Kural tabanlı şapkanın doğruluğu: {accuracy_score(y_test, kural_tahmin):.0%}")
    # Kural tabanlı şapkanın doğruluğu: 83%

    stratify=y, test grubunda her binadan eşit sayıda (15’er) öğrenci olmasını sağlıyor. Kural tabanlı şapka 60 test öğrencisinin 50’sini doğru yerleştirdi. Kötü değil; şimdi bunu geçmeye çalışalım.

    4. Karar ağacı: şapkaya örneklerden öğretmek

    Karar ağacı, veriye bakıp kendi evet-hayır sorularını oluşturan bir model. “Zeka 6,35’ten büyük mü?” diye sorar, cevaba göre bir dala geçer, sonra yeni bir soru sorar. Yani yaptığı şey bizim if-else kuralımıza çok benziyor; farkı, kuralları bizim yerimize veriden çıkarması.

    from sklearn.tree import DecisionTreeClassifier, export_text
    model = DecisionTreeClassifier(max_depth=3, random_state=42)
    model.fit(X_egitim, y_egitim)
    tahmin = model.predict(X_test)
    print(f"Karar ağacının doğruluğu: {accuracy_score(y_test, tahmin):.0%}")
    # Karar ağacının doğruluğu: 88%

    max_depth=3, ağacın en fazla üç soru üst üste sorabileceği anlamına geliyor. fit öğrenme adımı, predict tahmin adımı. Ağaç 60 öğrencinin 53’ünü doğru yerleştirdi.

    Karar ağacının güzel tarafı, öğrendiği kuralları okuyabilmemiz:

    print(export_text(model, feature_names=OZELLIKLER))
    |--- zeka <= 6.35
    | |--- hirs <= 6.45
    | | |--- cesaret <= 5.85
    | | | |--- class: Hufflepuff
    | | |--- cesaret > 5.85
    | | | |--- class: Gryffindor
    | |--- hirs > 6.45
    | | |--- cesaret <= 8.30
    | | | |--- class: Slytherin
    | | |--- cesaret > 8.30
    | | | |--- class: Gryffindor
    |--- zeka > 6.35
    | |--- hirs <= 7.30
    | | |--- cesaret <= 7.50
    | | | |--- class: Ravenclaw
    | | |--- cesaret > 7.50
    | | | |--- class: Gryffindor
    | |--- hirs > 7.30
    | | |--- class: Slytherin

    Bu çıktıdaki en ilginç detay şu: ağaç sadakati hiç sormuyor. Hufflepuff’ı “zekası, hırsı ve cesareti yüksek olmayan öğrenci” diye tarif ediyor. Biz veriyi üretirken Hufflepuff’ın yarısını dengeli öğrencilerden oluşturmuştuk; model de bunu bulmuş ve öteki üç binaya girmeyenleri Hufflepuff’a gönderen bir kural çıkarmış. Kural tabanlı şapkanın bilmediği şeyi örneklerden öğrendi.

    5. Şapka nerede yanılıyor?

    Doğruluk tek bir sayı; hangi binaların karıştığını söylemiyor. Bunun için karışıklık matrisine (confusion matrix) bakıyoruz. Satırlar gerçek binayı, sütunlar modelin tahminini gösteriyor:

    Gerçek \ TahminGryffindorRavenclawHufflepuffSlytherin
    Gryffindor14001
    Ravenclaw11400
    Hufflepuff13110
    Slytherin00114

    Köşegendeki sayılar doğru tahminler. Hataların çoğu Hufflepuff satırında: 15 Hufflepuff öğrencisinin 3’ü Ravenclaw’a gitmiş. Bunlar büyük ihtimalle zekası biraz yüksek çıkan dengeli öğrenciler. Gerçek bir projede bir sonraki adım bu örneklere tek tek bakmak olurdu.

    6. Ağacı büyütmek her zaman iyi mi?

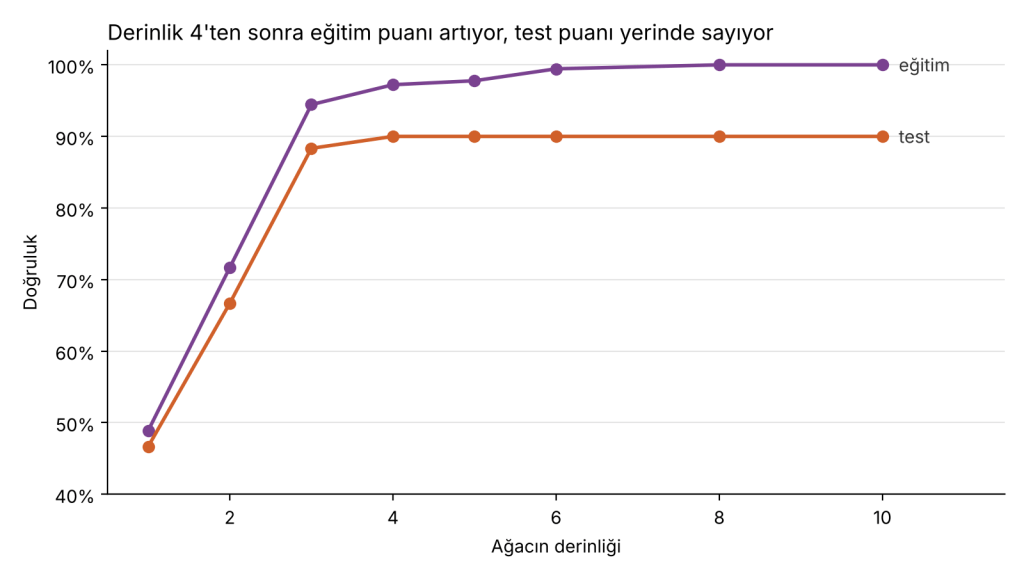
    Derinlik 3 yerine 10 olsa daha mı iyi olur? Farklı derinlikleri deneyip hem eğitim hem test doğruluğuna bakalım:

    for d in [1, 2, 3, 4, 5, 6, 8, 10]:
    m = DecisionTreeClassifier(max_depth=d, random_state=42).fit(X_egitim, y_egitim)
    egitim = accuracy_score(y_egitim, m.predict(X_egitim))
    test = accuracy_score(y_test, m.predict(X_test))
    print(f"derinlik {d:>2}: eğitim {egitim:.0%}, test {test:.0%}")
    derinlik 1: eğitim 49%, test 47%
    derinlik 2: eğitim 72%, test 67%
    derinlik 3: eğitim 94%, test 88%
    derinlik 4: eğitim 97%, test 90%
    derinlik 5: eğitim 98%, test 90%
    derinlik 6: eğitim 99%, test 90%
    derinlik 8: eğitim 100%, test 90%
    derinlik 10: eğitim 100%, test 90%

    Derinlik 8’de ağaç eğitim verisindeki her öğrenciyi doğru yerleştiriyor, ama yeni öğrencilerde derinlik 4’ten hiç daha iyi değil. Ekstra sorular genel bir kural öğrenmiyor, eğitimdeki tek tek öğrencileri ezberliyor. Buna aşırı öğrenme (overfitting) deniyor ve makine öğreniminde eğitim puanına tek başına güvenmememizin sebebi bu. Bizim örneğimizde zararı yok gibi görünüyor; daha gürültülü gerçek verilerde ise ezberleyen model test puanını da düşürebilir. Derinlik 3 de 4’e çok yakın sonuç veriyor ve kuralları bir bakışta okunabiliyor; yazıda bu yüzden onu seçtim.

    7. Berabere kalınca ne olur?

    Model, tahminin yanında her bina için bir olasılık da veriyor. Bunu bir fonksiyona saralım:

    def sapka(cesaret, zeka, sadakat, hirs):
    ogr = pd.DataFrame([{"cesaret": cesaret, "zeka": zeka, "sadakat": sadakat, "hirs": hirs}])
    olasiliklar = model.predict_proba(ogr)[0]
    for bina, p in sorted(zip(model.classes_, olasiliklar), key=lambda x: -x[1]):
    if p > 0:
    print(f"{bina:<11} {p:.0%}")
    print("Şapkanın kararı:", model.predict(ogr)[0])
    sapka(cesaret=9, zeka=5, sadakat=4, hirs=5)
    Gryffindor 89%
    Hufflepuff 9%
    Slytherin 2%
    Şapkanın kararı: Gryffindor

    Şimdi cesareti ve hırsı tam olarak eşit bir öğrenci deneyelim:

    berabere = {"cesaret": 8, "zeka": 5, "sadakat": 5, "hirs": 8}
    print("Kural tabanlı şapka:", kural_sapka(berabere))
    sapka(**berabere)
    Kural tabanlı şapka: Gryffindor
    Slytherin 98%
    Hufflepuff 2%
    Şapkanın kararı: Slytherin

    İki şapka iki farklı binayı seçti ve ikisinin de sebebi ilginç. Kural tabanlı şapka Gryffindor diyor, çünkü max eşitlikte listede önce gelen özelliği seçiyor. Yani kararı öğrenci değil, benim listeyi yazma sıram verdi. Karar ağacı ise %98 eminlikle Slytherin diyor, çünkü kurallarından biri “hırs yüksekse ve cesaret 8,30’u geçmiyorsa Slytherin”.

    Buradan çıkacak ders şu: Modelin %98 demesi gerçekten bu kadar emin olduğu anlamına gelmiyor. Karar ağacı olasılığı, öğrencinin düştüğü yapraktaki eğitim örneklerinin oranından hesaplıyor. O yaprakta neredeyse hep Slytherin öğrencileri olduğu için sayı yüksek çıkıyor. Tam sınırdaki bir öğrenci için bile. Olasılık çıktısını okurken bunu akılda tutmak gerekiyor.

    8. Kendi şapkanı tak

    Not defterinin sonunda dört soruluk küçük bir test var. Her özelliğe kendine 0 ile 10 arası puan veriyorsun, şapka da kararını ve olasılıkları yazıyor:

    puanlar = {}
    for o in OZELLIKLER:
    puanlar[o] = float(input(f"{o} (0-10): "))
    sapka(**puanlar)

    sapka(**puanlar) satırındaki iki yıldız, sözlükteki anahtarları isimli argümanlara çeviriyor. Yani sapka(cesaret=..., zeka=..., ...) yazmakla aynı şey.

    Bu projede ne öğrendik?

    • Sınıflandırma: özniteliklere bakıp bir etiket tahmin etmek.
    • Kural tabanlı sistemler düşündüğün durumlarda çalışır; örneklerden öğrenen model, senin görmediğin kalıpları bulabilir.
    • Modeli her zaman görmediği verilerle sına.
    • Karışıklık matrisi, hatanın nerede olduğunu gösterir.
    • Eğitim puanı yüzde 100 olan model iyi bir model olmayabilir; aşırı öğrenmeye dikkat.
    • Olasılık çıktısı her zaman gerçek bir eminlik ölçüsü değil.

    Kendin dene

    1. max_depth değerini 2 ve 5 yapıp kuralların nasıl değiştiğine bak.
    2. default_rng(42) içindeki 42’yi değiştir. Sonuçlar ne kadar oynuyor?
    3. Veriye beşinci bir özellik ekle (örneğin merak) ve hangi binada yüksek olacağına sen karar ver.
    4. Karar ağacı yerine KNeighborsClassifier(n_neighbors=5) dene ve olasılıkların nasıl değiştiğini karşılaştır.

    Devamını oku

  • Black Mirror’daki Teknolojiler: Hangileri Gerçek Oldu?

    Black Mirror’daki Teknolojiler: Hangileri Gerçek Oldu?

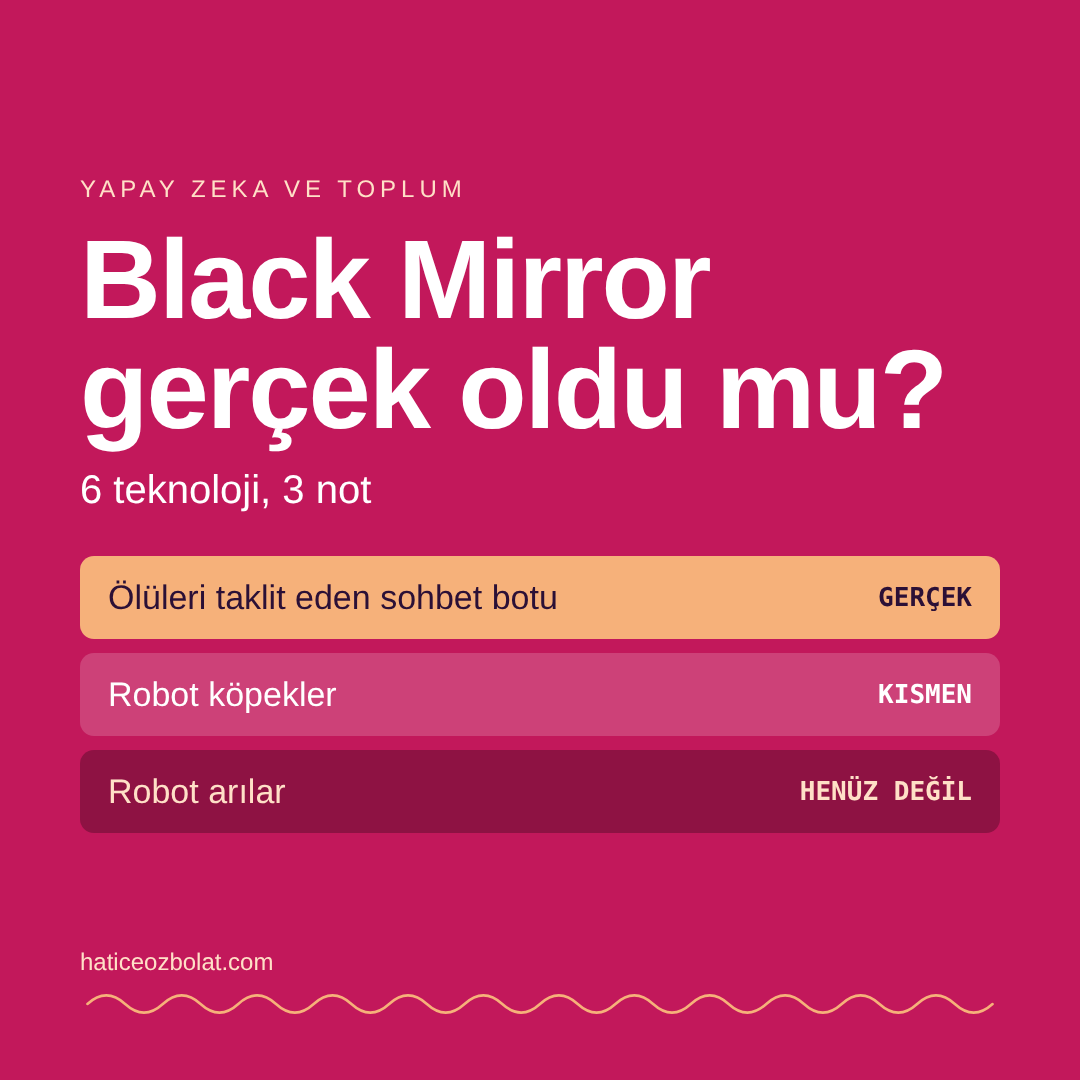
    Black Mirror’ın her bölümü aynı soruyla biter: “Bu teknoloji gerçek olsa ne olurdu?” Dizinin ilk bölümlerinin üzerinden on yıldan fazla geçti ve bu sorunun cevabı bazı bölümler için artık bir tahmin değil, haber başlığı. Bu yazıda dizinin altı teknolojisini gerçek dünyadaki karşılıklarıyla yan yana koydum ve her birine bir not verdim: gerçek oldu, kısmen gerçek ya da henüz değil.

    Spoiler uyarısı: Bölümlerin ana fikirlerinden bahsediyorum ama sonlarını anlatmıyorum.

    1. Ölen birini yapay zekâyla geri getirmek (“Be Right Back”)

    Dizide: Sevgilisini kaybeden bir kadın, onun sosyal medya paylaşımlarından ve mesajlarından öğrenen bir yazılımla konuşmaya başlıyor.

    Gerçekte: Yazılımcı Eugenia Kuyda, yakın arkadaşı Roman bir trafik kazasında hayatını kaybettikten sonra, onunla yaptığı mesajlaşmaları bir yapay zekâ programına verdi ve onun konuşma tarzını taklit eden bir sohbet botu yaptı. Bu deneyim, bugün milyonlarca kullanıcısı olan sohbet arkadaşı uygulaması Replika’nın başlangıç noktası oldu. Büyük dil modelleriyle birlikte “kaybettiğin kişiyle konuş” iddiasındaki uygulamalar da çoğaldı.

    Not: Gerçek oldu. Teknik olarak dizideki sohbet aşaması bugün mümkün. Ama bölümün asıl sorduğu soru, yani bunun yas sürecine iyi mi geleceği yoksa onu uzatacağı mı, hâlâ cevapsız.

    2. Robot köpekler (“Metalhead”)

    Dizide: İnsanları durmaksızın takip eden dört bacaklı robotlar.

    Gerçekte: Dizinin yaratıcısı Charlie Brooker, bölümün Boston Dynamics’in robot köpeklerinden etkilendiğini söyledi. Aynı şirketin Spot adlı robotu bugün fabrikalarda, enerji tesislerinde ve tehlikeli alanlarda denetim için kullanılıyor. New York polisi 2020’de “Digidog” adını verdiği bir Spot kiraladı; ama robotun bir rehine olayında ve bir gözaltıda kullanılması büyük tepki çekti ve sözleşme Nisan 2021’de erken bitirildi.

    Not: Kısmen gerçek. Robot köpekler var ve gerçek işlerde kullanılıyor. Dizideki gibi kendi başına avlanan, silahlı bir robot ise yok. New York örneği, toplumun bu çizgiyi ne kadar hassas bulduğunu gösteriyor.

    3. Robot arılar (“Hated in the Nation”)

    Dizide: Arı nüfusu çöktüğü için tozlaşmayı yapan küçük dronlar.

    Gerçekte: Harvard’daki araştırmacılar yıllardır RoboBee adını verdikleri böcek boyutunda uçan robotlar üzerinde çalışıyor. 2018’de perakende devi Walmart’ın “insansız araçlarla tarım ürünlerini tozlaştırma” için patent başvurusu yaptığı ortaya çıktı.

    Not: Henüz değil. Patent başvurusu ve laboratuvar prototipleri var ama tarlada çalışan robot arı sürüleri yok. Gerçek arıların yaptığı işi bu ölçekte taklit etmek hâlâ çok zor.

    4. Her şeyi kaydeden gözler (“The Entire History of You”)

    Dizide: Kulağın arkasına takılan bir çip, yaşadığın her anı kaydediyor; istediğin anı geri sarıp tekrar izleyebiliyorsun.

    Gerçekte: Beyne takılan bir hafıza çipi yok. Ama kamera ve mikrofonlu akıllı gözlükler artık bir tüketici ürünü: gözlüğünle gördüğünü kaydedip paylaşabiliyorsun. Telefonundaki fotoğraf arşivi de yıllarını tarih ve yere göre geri sarmanı sağlıyor.

    Not: Kısmen gerçek. Kayıt kısmı büyük ölçüde var; vücuda yerleştirilmiş ve her şeyi sürekli kaydeden kısım değil. Bölümün uyardığı şey, yani her tartışmada “kayda bakalım” demenin ilişkilere etkisi, artık çok daha tanıdık geliyor.

    5. Puanlanan hayatlar (“Nosedive”)

    Dizide: Herkes karşılaştığı herkese 1’den 5’e kadar puan veriyor. Puanın düşükse ev kiralayamıyor, uçağa binemiyorsun.

    Gerçekte: Bu bölüm sık sık Çin’in sosyal kredi sistemiyle karşılaştırılıyor. Ama bu karşılaştırmanın abartılı olduğunu söyleyen pek çok analiz var: Gerçekteki sistem, dizideki gibi herkesin herkese puan verdiği tek bir uygulama değil; farklı kurumların ve şirketlerin kendi kayıtlarından oluşan, parçalı ve tartışmalı bir yapı. Öte yandan günlük hayatımızda puanlar her yerde: sürücüler yolcuya, ev sahipleri misafire, satıcılar alıcıya puan veriyor.

    Not: Kısmen gerçek. Tek bir süper puan yok; ama birbirine puan verdiğimiz düzinelerce küçük sistem var. Bölümün asıl eleştirdiği şey, puan için rol yapmak, belki de en gerçek olan kısmı.

    6. Bilinci dijital dünyaya taşımak (“San Junipero”)

    Dizide: İnsanların bilinci, ölümden sonra da yaşayabilecekleri bir sanal dünyaya aktarılıyor.

    Gerçekte: Sanal gerçeklik gözlükleri ve sanal dünyalar var. Ama bir insanın bilincini kopyalayıp bilgisayara aktarmak, bugünün bilimiyle mümkün değil; bilincin ne olduğunu bile tam olarak bilmiyoruz.

    Not: Henüz değil. Ve belki de hiç olmayacak. Ama bölüm teknolojiden çok bir aşk hikâyesi olduğu için bu, onu daha az etkileyici yapmıyor.

    Özet

    BölümTeknolojiDurum
    Be Right BackÖlen birini taklit eden sohbet botuGerçek oldu
    MetalheadRobot köpeklerKısmen gerçek
    The Entire History of YouHer şeyi kaydeden cihazKısmen gerçek
    NosediveHerkesin herkese puan verdiği dünyaKısmen gerçek
    Hated in the NationTozlaşma yapan robot arılarHenüz değil
    San JuniperoBilinci dijital dünyaya aktarmakHenüz değil

    Asıl mesele teknoloji değil

    Bu listeyi yaparken fark ettiğim şey şu oldu: Black Mirror’ın korkutucu tarafı hiçbir zaman teknolojinin kendisi değildi. Bir sohbet botu, bir robot ya da bir puanlama sistemi tek başına iyi ya da kötü değil. Dizinin asıl sorduğu şey, insanların bu araçlarla ne yaptığı. Teknolojiyi üreten taraftaysan bu soru daha da önemli hale geliyor: Bir ürünü yaparken sadece “yapabilir miyiz?” diye değil, “yapmalı mıyız?” diye de sormak gerekiyor.

    Benim yorumum

    Black Mirror’ı izlerken her bölümde hem şaşırıyorum hem de içimden “Ben de bu teknolojilerin bir parçası olayım” diyorum. Dizi ne kadar karanlık olursa olsun, ekranda gördüğüm her yeni fikir beni heyecanlandırıyor. Bu listeyi hazırlarken de bir kez daha seçtiğim meslekle gurur duydum: Bu teknolojileri izleyen değil, onları üreten tarafta olmak; üstelik yukarıdaki “yapmalı mıyız?” sorusunu da sorabilen biri olarak.

  • Netflix İzleme Geçmişi Panosu 2: Streamlit ile Panoya Dönüştürmek

    Netflix İzleme Geçmişi Panosu 2: Streamlit ile Panoya Dönüştürmek

    İlk bölümde Netflix izleme geçmişimi indirip temizledim ve not defterinde ona sorular sordum: En çok hangi diziyi izlemişim, hangi günler daha çok izliyorum, maraton günüm hangisi? Ama not defteri, cevabı görmek için her seferinde kod çalıştırmayı gerektiriyor. Bu bölümde aynı kodu, tıklayıp filtreleyebileceğin bir web panosuna çeviriyoruz. Hem de HTML ya da JavaScript bilmeden, sadece Python ile.

    Uygulamanın tüm kodu GitHub’da: pop-kultur-kodluyorum / netflix-pano.

    Streamlit nedir?

    Streamlit, Python koduyla web uygulaması yapmayı sağlayan açık kaynak bir kütüphane. Veri bilimcilerin en sevdiği araçlardan biri, çünkü mantığı çok basit: Bir Python dosyası yazıyorsun, st.title("Merhaba") dersen sayfada başlık, st.bar_chart(veri) dersen grafik çıkıyor. Biri bir düğmeye bastığında ya da bir filtreyi değiştirdiğinde Streamlit dosyayı yukarıdan aşağı yeniden çalıştırır ve sayfayı günceller.

    Bu “her etkileşimde yeniden çalıştır” fikri başta garip gelebilir, ama işi çok kolaylaştırıyor: Kodu not defterinde yazar gibi yukarıdan aşağı yazıyorsun, gerisini Streamlit hallediyor.

    Kurulum

    Streamlit kendi bilgisayarında çalışır (Colab’da doğrudan çalışmaz). Terminalde:

    pip install streamlit pandas altair

    Kurulumu denemek için streamlit hello yazabilirsin; tarayıcında bir örnek uygulama açılır.

    Uygulamanın parçaları

    Uygulama tek bir dosya: app.py. Altı bölümden oluşuyor. Tamamı GitHub’da; burada her bölümün önemli satırlarını anlatıyorum.

    1. Temizleme fonksiyonları: ilk bölümden aynen

    Tarihleri çözen tarihi_coz ve diziyi filmden ayıran ayir fonksiyonlarını ilk bölümden hiç değiştirmeden taşıdım. Hepsini tek bir fonksiyonda topladım:

    @st.cache_data
    def veriyi_hazirla(ham):
    df = ham.rename(columns={"Title": "baslik", "Date": "tarih"})
    df["tarih"] = tarihi_coz(df["tarih"])
    df = df.dropna(subset=["tarih"])
    df[["isim", "tur"]] = df["baslik"].apply(lambda b: pd.Series(ayir(b)))
    # ... ikinci adım: tekrar eden ön ekleri dizi say
    return df

    @st.cache_data satırı bir dekoratör: fonksiyonun üstüne yapışan bir etiket gibi düşün. Streamlit’e “bu fonksiyonu aynı veriyle tekrar çağırırlarsa baştan hesaplama, önceki sonucu ver” diyor. Her filtre değişikliğinde dosya yeniden çalıştığı için bu önemli; yoksa binlerce satırı her tıklamada yeniden temizlerdik.

    2. Dosyayı almak

    dosya = st.file_uploader("NetflixViewingHistory.csv dosyanı yükle", type="csv")
    if dosya is None:
    st.info("Henüz dosya yüklemedin. Aşağıda hayali bir örnek veriyle gösteriyorum.")
    df = veriyi_hazirla(ornek_veri())
    else:
    df = veriyi_hazirla(pd.read_csv(dosya))

    st.file_uploader sayfaya bir dosya yükleme kutusu koyar. Kullanıcı henüz dosya seçmediyse None döner; o zaman pano boş kalmasın diye hayali bir örnek veri gösteriyoruz. Bu örnek veri tamamen uydurma dizi isimlerinden oluşuyor.

    3. Filtreler: kenar çubuğu

    with st.sidebar:
    yillar = sorted(df["tarih"].dt.year.unique())
    secilen_yillar = st.multiselect("Yıl", yillar, default=yillar)
    tur = st.radio("Tür", ["Hepsi", "Dizi", "Film"], horizontal=True)
    f = df[df["tarih"].dt.year.isin(secilen_yillar)]
    if tur != "Hepsi":
    f = f[f["tur"] == tur]

    with st.sidebar: bloğunun içine yazılan her şey sol taraftaki kenar çubuğuna gider. st.multiselect birden fazla yıl seçmeye, st.radio türlerden birini seçmeye yarıyor. Seçimler sıradan Python değişkenlerine düşüyor; sonra pandas ile tabloyu filtreliyoruz. Sayfanın geri kalanı hep bu filtrelenmiş f tablosunu kullanıyor, böylece bir filtre değişince tüm pano birlikte değişiyor.

    4. Özet kartları

    k1, k2, k3, k4 = st.columns(4)
    k1.metric("Toplam kayıt", len(f))
    k2.metric("Farklı dizi", f.loc[f["tur"] == "Dizi", "isim"].nunique())
    k3.metric("Film", int((f["tur"] == "Film").sum()))
    k4.metric("Maraton günü", f"{gunluk.max()} kayıt")

    st.columns(4) sayfayı dört eşit sütuna böler, metric da her sütuna büyük bir sayı koyar. Panonun en üstündeki özet buradan geliyor.

    5. Grafikler

    Streamlit’in kendi st.bar_chart fonksiyonu hızlı ama günlerin sırasını alfabetik yapıyor (Cuma, Cumartesi, Çarşamba…). Haftanın günlerini doğru sırada göstermek ve renkleri seçmek için Streamlit’le birlikte gelen Altair kütüphanesini kullandım. Aynı çubuk grafiği üç yerde kullanacağım için küçük bir fonksiyon yazdım:

    def cubuk(veri, x, y, renk=BOGURTLEN, sira=None, x_baslik="", y_baslik="Kayıt"):
    return (
    alt.Chart(veri)
    .mark_bar(color=renk, cornerRadiusEnd=4)
    .encode(
    x=alt.X(x, sort=sira, title=x_baslik),
    y=alt.Y(y, title=y_baslik),
    tooltip=[x, y],
    )
    )

    sort=sira parametresine ["Pazartesi", "Salı", ...] listesini verince günler doğru sıraya diziliyor. tooltip da fareyle çubuğun üzerine gelince sayıyı gösteriyor. Grafiği sayfaya koymak için st.altair_chart(grafik) yeterli. (GitHub’daki tam sürümde eksen biçimleri için birkaç ayar daha var.)

    En çok izlenen 10 dizi ise grafik değil tablo: st.dataframe(ilk10, hide_index=True). Uzun dizi isimleri tabloda daha rahat okunuyor.

    6. Bir diziye yakından bak

    diziler = f.loc[f["tur"] == "Dizi", "isim"].value_counts().index.tolist()
    secilen = st.selectbox("Dizi seç", diziler)
    d = f[f["isim"] == secilen]

    st.selectbox bir açılır menü koyar. Liste en çok izlenenden en aza doğru sıralı. Bir dizi seçince ilk ve son izleme tarihini ve o dizinin aylara göre grafiğini gösteriyoruz. Bir diziyi birkaç haftada bitirip bitirmediğini ya da yıllara yayıp yaymadığını bu grafikte görebiliyorsun.

    Çalıştırmak

    1. GitHub’dan netflix-pano klasörünü indir (ya da depoyu klonla).
    2. Terminalde o klasöre gir ve pip install -r requirements.txt yaz.
    3. streamlit run app.py yaz. Tarayıcında pano açılır.
    4. Netflix’ten indirdiğin NetflixViewingHistory.csv dosyasını yükleme kutusuna sürükle.

    Dosyayı Netflix’ten nasıl indireceğini ilk bölümde adım adım anlattım.

    Panoyu internete koymak

    Panoyu arkadaşlarınla paylaşmak istersen Streamlit Community Cloud’u kullanabilirsin: GitHub hesabınla giriş yapıp deponu ve app.py dosyasını seçiyorsun, uygulama birkaç dakika içinde bir web adresinde yayına giriyor. Uygulama kimsenin verisini kendi içinde taşımıyor; her ziyaretçi kendi dosyasını yüklüyor.

    Gizlilik notu: Uygulama yüklenen dosyayı hiçbir yere kaydetmiyor, sadece açık olan oturumda işliyor. Yine de ham CSV dosyanı GitHub gibi herkese açık bir yere koyma. İzleme geçmişi, ne zaman uyanık olduğuna kadar çok şey anlatır. Paylaşırken sadece toplamları ve grafikleri paylaş; ben de bu yazıda öyle yaptım.

    Panoda ne gördüm?

    Kendi verimi yükleyince pano şunları gösterdi:

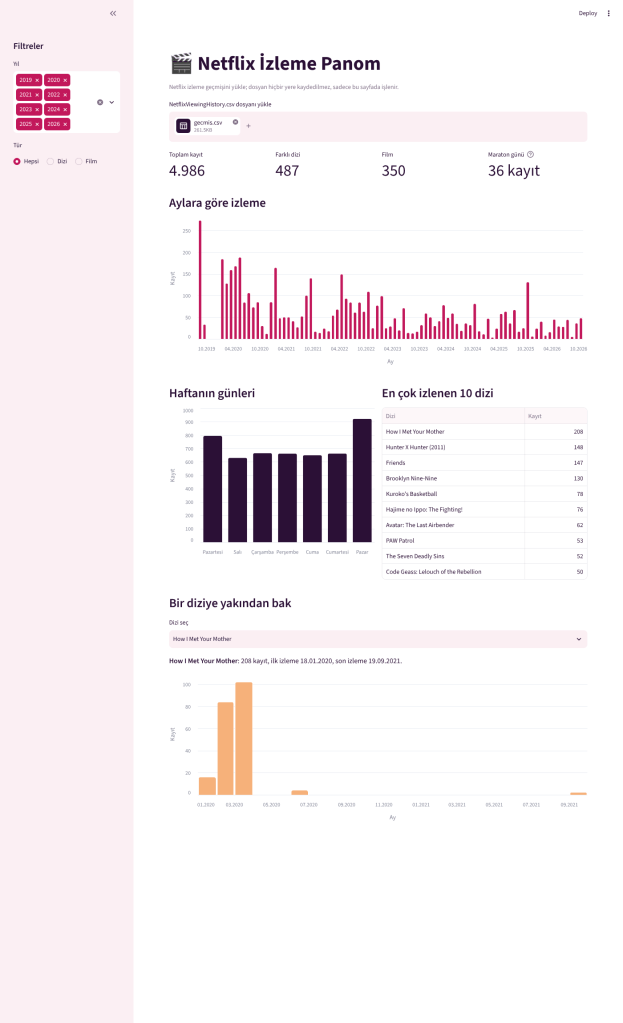
    • Ağustos 2019’dan bu yana toplam 4.986 kayıt, 487 farklı dizi ve 350 film.
    • Haftanın en çok izlediğim günü Pazar, ikinci sırada Pazartesi. Hafta içinin diğer günleri birbirine çok yakın.
    • Maraton günümde 36 kayıt var.

    Kendin dene

    • Kenar çubuğuna bir saat filtresi ekleyemezsin, çünkü Netflix dosyasında saat yok. Ama bir ay filtresi ekleyebilirsin: st.slider ile 1-12 arası seçim yap.
    • “En çok izlenen 10 dizi” yerine kullanıcının kaç dizi görmek istediğini seçmesini sağla: st.number_input("Kaç dizi?", 5, 30, 10).
    • Bir arkadaşınla karşılaştır: İki dosya yükletip iki kişinin haftalık çubuklarını yan yana göster.

    Bir sonraki pop kültür projesinde Netflix verisini bir adım daha ileri taşıyıp basit bir öneri sistemi yazacağız: “Netflix’te Ne İzlesem?”

  • Matrix Yağmurunu Terminalde Kodlamak

    Matrix Yağmurunu Terminalde Kodlamak

    Siyah ekran, yukarıdan aşağıya akan yeşil karakterler, her sütunun başında parlayan bir harf. 1999’da vizyona giren The Matrix’in bu “dijital yağmur” sahnesi, bilgisayar dünyasının en tanınan görüntülerinden biri oldu. Bu yazıda aynı efekti 50 satırlık bir Python koduyla kendi terminalinde yaratıyoruz. Hiçbir kütüphane kurmadan, sadece Python’un kendi araçlarıyla.

    Kodlar hazır bir not defterinde: Colab’da Aç. Not defterinde Colab’da çalışan bir sürüm de var.

    Efekt aslında nasıl çalışıyor?

    Görüntü karmaşık ama arkasındaki fikir basit. Ekranı sütunlara böl ve her sütunda bir “damla” düşün:

    1. Her sütunun bir damlası var ve damlanın başı belirli bir satırda duruyor.
    2. Her karede damla bir satır aşağı iniyor. Yeni yerine parlak beyaz rastgele bir karakter yazılıyor; bir önceki yer yeşile dönüyor.
    3. Damlanın belirli bir uzunlukta kuyruğu var. Kuyruğun ucundaki karakter silinerek boşluk bırakılıyor.
    4. Damla ekranın altından çıkınca, rastgele bir yükseklikten yeniden başlıyor.

    Bütün sütunlar aynı kuralı izliyor; farklı yüksekliklerden başladıkları için de yağmur rastgele ve canlı görünüyor. Yani ekranda gördüğün “sihir”, Python Dersi 6’daki döngüler ve Python Dersi 7’deki listelerle yapılan küçük bir simülasyon.

    Terminale renk ve konum söylemek: ANSI kaçış kodları

    Normalde print yazıyı imlecin olduğu yere, sırayla yazar. Biz ise ekranın istediğimiz noktasına, istediğimiz renkte yazmak istiyoruz. Bunun için terminallerin anladığı özel komutlar var: ANSI kaçış kodları.

    Hepsi \033[ ile başlar (çoğu yerde “ESC [” diye yazılır). Terminal bunları ekrana yazmaz, komut olarak uygular:

    KodNe yapar?
    \033[32mYazı rengini yeşil yapar
    \033[97mYazı rengini parlak beyaz yapar
    \033[0mRenkleri sıfırlar
    \033[2JEkranı temizler
    \033[5;10Hİmleci 5. satır, 10. sütuna götürür
    \033[?25l / \033[?25hİmleci gizler / gösterir

    Kendin denemek için terminalde şunu çalıştır:

    print("\033[32mBu yazı yeşil\033[0m, bu yazı normal.")

    Kod

    import os
    import random
    import sys
    import time
    KARAKTERLER = "アイウエオカキクケコサシスセソタチツテトナニヌネノハヒフヘホマミムメモ0123456789"
    YESIL = "\033[32m" # yazı rengi: yeşil
    BEYAZ = "\033[97m" # yazı rengi: parlak beyaz
    SIFIRLA = "\033[0m" # renkleri sıfırla
    TEMIZLE = "\033[2J" # ekranı temizle
    IMLEC_GIZLE = "\033[?25l"
    IMLEC_GOSTER = "\033[?25h"
    def yaz(satir, sutun, metin):
    """İmleci (satir, sutun) konumuna götürüp metni oraya yazar."""
    sys.stdout.write(f"\033[{satir};{sutun}H{metin}")
    def yagmur(hiz=0.05, kuyruk=12):
    genislik, yukseklik = os.get_terminal_size()
    yukseklik -= 1 # en alt satıra yazıp ekranı kaydırmayalım
    damlalar = [random.randint(-yukseklik, 0) for _ in range(genislik)]
    sys.stdout.write(TEMIZLE + IMLEC_GIZLE)
    try:
    while True:
    for x in range(genislik):
    y = damlalar[x] # bu sütundaki damlanın başı
    if 1 <= y <= yukseklik:
    yaz(y, x + 1, BEYAZ + random.choice(KARAKTERLER))
    if 1 <= y - 1 <= yukseklik:
    yaz(y - 1, x + 1, YESIL + random.choice(KARAKTERLER))
    if 1 <= y - kuyruk <= yukseklik:
    yaz(y - kuyruk, x + 1, " ") # kuyruğun ucunu sil
    damlalar[x] += 1
    if y - kuyruk > yukseklik: # damla ekranın altından çıktı
    damlalar[x] = random.randint(-yukseklik, 0)
    sys.stdout.flush()
    time.sleep(hiz)
    except KeyboardInterrupt: # Ctrl+C ile çıkış
    pass
    finally:
    sys.stdout.write(SIFIRLA + IMLEC_GOSTER + TEMIZLE + "\033[H")
    if __name__ == "__main__":
    yagmur()

    Kod adım adım

    Karakterler. Filmdeki yağmur, Japon katakana alfabesine benzeyen karakterler ve rakamlardan oluşuyor. Biz de KARAKTERLER metnine yarım genişlikteki katakana harflerini ve rakamları koyduk. “Yarım genişlik” önemli: bu harfler terminalde tam bir sütun kaplar, böylece sütunlar kaymaz. random.choice(KARAKTERLER) her seferinde bu metinden rastgele bir karakter seçiyor.

    Ekran boyutu. os.get_terminal_size() terminal penceresinin kaç sütun genişliğinde ve kaç satır yüksekliğinde olduğunu verir. Yağmur pencereni büyütürsen daha geniş yağar.

    Damlalar listesi. damlalar her sütun için tek bir sayı tutan bir liste: o sütundaki damlanın başı hangi satırda? Başlangıçta hepsi ekranın üstünde, eksi sayılarda; böylece her damla farklı zamanda ekrana girer. Bu tek satırlık liste kurma yazımını (liste üreteci) yarınki kod kartında ayrıntılı anlatacağım.

    Ana döngü. while True sonsuza kadar döner. Her turda tüm sütunlar gezilir ve her sütun için üç iş yapılır: başa beyaz karakter, bir üstüne yeşil karakter, kuyruğun ucuna boşluk. if 1 <= y <= yukseklik kontrolleri, ekranın dışına yazmaya kalkışmamak için.

    Her seferinde tüm ekranı çizmiyoruz. Sadece değişen üç hücreyi güncelliyoruz. Bu yüzden kod geniş bir pencerede bile akıcı çalışıyor. sys.stdout.write ise print gibi, ama sona otomatik satır atlama eklemiyor; flush() da biriken yazıları tek seferde ekrana gönderiyor.

    Temiz çıkış. Ctrl+C’ye basınca Python KeyboardInterrupt hatası fırlatır. try / except bu hatayı yakalıyor, finally bloğu da ne olursa olsun çalışıp renkleri sıfırlıyor, imleci geri getiriyor ve ekranı temizliyor. Bunu yapmasaydık, programdan çıktıktan sonra terminal yeşil ve imleçsiz kalırdı. Hata yönetimini ileride Python Dersi 13’te ayrıntılı göreceğiz.

    Çalıştırmak

    1. Kodu kopyala ve matrix.py adıyla kaydet.
    2. Terminali aç, dosyanın olduğu klasöre git ve python matrix.py yaz (bazı sistemlerde python3 matrix.py).
    3. Yağmuru durdurmak için Ctrl+C.

    Mac ve Linux terminallerinde, Windows’ta da Windows Terminal’de çalışır. Eski Windows komut isteminde (cmd) renkler görünmeyebilir; o zaman Windows Terminal’i dene.

    Colab’da çalıştırmak

    Colab’ın çıktı alanı gerçek bir terminal değil; renkleri gösterir ama imleci istediğimiz yere götüremez. Bu yüzden not defterinde farklı bir yöntem kullandım: Ekranı iç içe bir liste olarak tutuyoruz (her satır bir liste, ekran da satırların listesi) ve her karede ekranı silip baştan yazdırıyoruz:

    izgara = [[" "] * genislik for _ in range(yukseklik)]
    izgara[y][x] = random.choice(KARAKTERLER) # y. satırın x. hücresi

    Sonuç terminaldeki kadar akıcı olmasa da aynı fikir. İki yöntemi karşılaştırmak da bir ders: Aynı görüntüyü “sadece değişeni güncelle” ya da “her şeyi baştan çiz” diye iki farklı algoritmayla üretebiliyoruz.

    Kendin dene

    • yagmur(hiz=0.1) ile yavaş, yagmur(hiz=0.02) ile hızlı bir yağmur.
    • kuyruk=25 ile uzun kuyruklu damlalar.
    • KARAKTERLER metnine kendi adının harflerini ekle.
    • Yeşil yerine mavi bir yağmur için YESIL = "\033[34m".
    • Zor olan: Ekranın ortasında sabit duran bir yazı göster, yağmur onun etrafından aksın.

    Son söz

    Matrix’i ilk izlediğimde lisedeydim. O akan yeşil ekrana hayran kalmıştım. Belki de bilgisayar mühendisliği bana ilk o zaman bu kadar havalı gelmişti. Yıllar sonra aynı yağmuru kendi yazdığım birkaç satır kodla kendi terminalimde görmek ise bambaşka bir duyguydu: O zaman ekranın arkasında bir sihir olduğunu düşünüyordum, şimdi o sihrin döngülerden ve listelerden oluştuğunu biliyorum.

    Bir de tavsiye: Hem görsel olarak hem de sorduğu sorularla çok güzel, felsefi bir film serisi. İzlemediysen mutlaka izle; izlediysen bu yazıdan sonra bir kez daha izlemek isteyebilirsin.

  • Squid Game’deki Cam Köprüyü Python ile Simüle Etmek: Hayatta Kalma Olasılığı

    Squid Game’deki Cam Köprüyü Python ile Simüle Etmek: Hayatta Kalma Olasılığı

    Squid Game’in cam köprü bölümünü izlerken aklımdan geçen ilk soru şuydu: sıranı seçebilseydin kaçıncı olmak isterdin? Bu yazıda bu soruyu Python’la cevaplıyorum. Önce oyunu 100.000 kez simüle edeceğiz, sonra aynı sonucu basit bir olasılık formülüyle doğrulayacağız.

    Kodun tamamı Colab’da hazır: Colab’da Aç

    Squid Game hakkında kısaca

    Squid Game, Hwang Dong-hyuk’un yarattığı, yazdığı ve yönettiği Güney Kore yapımı bir dizi. İlk sezonu 17 Eylül 2021’de Netflix’te dokuz bölüm olarak yayımlandı. Netflix’in açıklamasına göre ilk 28 günde 142 milyondan fazla hanede izlendi ve 1,65 milyar saatlik izlenmeye ulaştı.

    Hikâyede borca batık 456 kişi, büyük bir para ödülü için çocuk oyunlarından oluşan bir yarışmaya katılıyor. Oyunlar tanıdık, kuralları basit; ama kaybedenler elendiğinde hayatını kaybediyor. Dizinin adı da Kore’de çocukların oynadığı bir sokak oyunundan geliyor. Basit kuralların ardına saklı büyük riskler, diziyi olasılık ve oyun teorisi merakları için de ilginç bir malzeme yapıyor.

    Cam köprü oyunu

    Yedinci bölümde (“VIPS”) oyuncular iki sıra cam panelden oluşan bir köprüyü geçmek zorunda. Her adımda biri sağda biri solda iki panel var. Biri temperli cam ve bir insanı taşıyor, diğeri sıradan cam ve kırılıyor. Dışarıdan bakınca ikisi aynı görünüyor.

    Aslında bu bir yazı tura oyunu, ama bir farkla: oyuncular sırayla geçiyor ve arkadakiler öndekilerin bastığı yerleri görüyor. Önden giden biri doğru cama basarsa o adım artık herkes için güvenli. Yanlış cama basarsa düşüyor, ama o adımda diğer camın doğru olduğu da ortaya çıkıyor. Yani her bilinmeyen adım ya bir kişinin şansıyla ya da bir kişinin düşüşüyle çözülüyor.

    Modelin varsayımları

    Matematikçilerin bu oyun için kurduğu modelleri esas aldım (Chalkdust dergisindeki analiz gibi):

    • Köprü 18 adım, oyuncu sayısı 16.
    • Her adımda iki cam eşit olasılıklı: doğruyu seçme şansı %50.
    • Oyuncular camları ayırt edemiyor ve öndekilerin açtığı yolu hatasız hatırlıyor.
    • Süre sınırı, itip kakma ya da ışıkların kapatılması gibi dizideki olaylar modelde yok.

    Bu varsayımlar gerçek dünyayı basitleştiriyor. Bunun bedelini yazının sonunda, dizideki sonuçla karşılaştırırken göreceğiz.

    Simülasyonu yazmak

    Simülasyon, bir olayı bilgisayarda binlerce kez tekrar oynatıp ne sıklıkla ne olduğunu saymak demek. Gerçek hayatta bu oyunu 100.000 kez oynatamayız ama bilgisayarda birkaç saniyede yapabiliriz.

    Tek bir oyunu oynatan fonksiyon şöyle:

    import numpy as np
    def kopruyu_gec(oyuncu=16, adim=18, rng=None):
    """Bir oyunu simüle eder; hayatta kalan oyuncuların sıra numaralarını döndürür."""
    rng = rng or np.random.default_rng()
    bilinen = 0 # öndekilerin açtığı yol buraya kadar güvenli
    kalanlar = []
    for sira in range(1, oyuncu + 1):
    konum = bilinen # bilinen yolu güvenle yürü
    hayatta = True
    while konum < adim:
    konum += 1 # bir sonraki bilinmeyen adıma bas
    if rng.random() >= 0.5: # yazı tura: yanlış cam
    hayatta = False # düştü, ama bu adım artık biliniyor
    break
    bilinen = konum
    if hayatta:
    # bu oyuncu köprüyü bitirdi; arkadakiler de açılan yoldan geçer
    kalanlar = list(range(sira, oyuncu + 1))
    break
    return kalanlar

    Kodun mantığı adım adım:

    1. bilinen değişkeni, önceki oyuncuların çözdüğü son adımı tutuyor. Başta 0, yani hiçbir adım bilinmiyor.
    2. Sıradaki oyuncu bilinen yolu güvenle yürüyüp ilk bilinmeyen adımdan itibaren yazı tura atmaya başlıyor.
    3. Yanlış cama basarsa düşüyor. Ama bastığı adım da artık biliniyor, çünkü kırılan camın yanındaki doğru cam.
    4. Bir oyuncu 18. adımı geçerse köprü tamamen çözülmüş oluyor; ondan sonraki herkes güvenle geçiyor.

    rng.random() 0 ile 1 arasında rastgele bir sayı üretiyor. Sayının 0,5’ten küçük olma ihtimali tam %50, yani bu bir yazı tura.

    100.000 kez oynatmak

    rng = np.random.default_rng(42) # aynı sonucu tekrar alabilmek için tohum
    N = 100_000
    hayatta_kalma = np.zeros(17) # her sıra numarası için kaç kez hayatta kaldı
    kalan_sayilari = []
    for _ in range(N):
    kalanlar = kopruyu_gec(rng=rng)
    kalan_sayilari.append(len(kalanlar))
    for sira in kalanlar:
    hayatta_kalma[sira] += 1
    olasilik = hayatta_kalma[1:] / N # 1'den 16'ya kadar her sıranın hayatta kalma oranı
    print("Ortalama hayatta kalan:", np.mean(kalan_sayilari))

    default_rng(42) içindeki 42 bir “tohum” (seed). Rastgele sayıları her seferinde aynı sırayla üretir, böylece sen de not defterini çalıştırdığında benimle aynı sonucu alırsın.

    Sonuçlar: sıran ne kadar önemli?

    100.000 oyunun sonunda ortalama 7,0 oyuncu köprüyü geçti. Asıl ilginç olan, bu yedi kişinin kim olduğu:

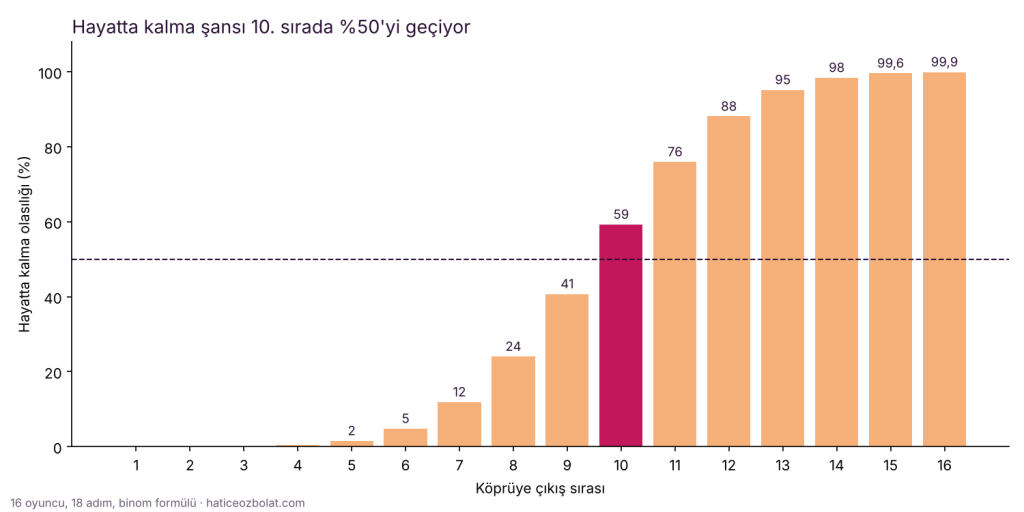
    İlk sıradaki oyuncunun köprüyü geçmesi için 18 yazı turanın hepsini bilmesi gerekiyor: yaklaşık 262.000’de 1. Son sıradaki oyuncu ise neredeyse kesin geçiyor (%99,93). Eğri ortada çok dikleşiyor: 8. sırada %24 olan şans 10. sırada %59’a, 12. sırada %88’e çıkıyor. Yani dizideki gibi sıra numarasını görmeden seçmek, bu oyundaki en büyük kumar.

    Bir de en az bir kişinin köprüyü geçme ihtimali var: simülasyonda 100.000 oyunun %99,94’ünde en az bir kişi karşıya ulaştı.

    Aynı sonucu formülle bulmak

    Simülasyon güzel ama sonucun doğru olduğundan nasıl emin olacağız? Bu oyunun aslında çok basit bir matematiksel yapısı var.

    Şöyle düşün: 18 adımın her biri bir kez, ilk basan kişi tarafından “çözülüyor”. Her çözümde %50 ihtimalle biri düşüyor. Yani köprünün tamamında toplam kaç kişinin düşeceği, 18 kez yazı tura atıp kaç kez tura geldiğini saymakla aynı şey. Bu, olasılıkta binom dağılımı denen yapı.

    k. sıradaki oyuncu, toplamda k’den az kişi düşerse hayatta kalıyor. 18 atışta tam d kez tura gelme olasılığı C(18, d) / 2¹⁸, bunları 0’dan k − 1’e kadar topladığımızda cevabı buluyoruz:

    from math import comb
    def tam_olasilik(oyuncu=16, adim=18):
    """k. oyuncunun hayatta kalma olasılığı: 18 adımda k'den az düşüş olması."""
    return [sum(comb(adim, d) for d in range(k)) / 2 ** adim for k in range(1, oyuncu + 1)]
    olasiliklar = tam_olasilik()
    print(f"Beklenen hayatta kalan: {sum(olasiliklar):.2f}") # 7.00

    comb(18, d), 18 adımın hangi d tanesinde birinin düşeceğini seçmenin kaç yolu olduğunu veriyor. Formülün sonuçları simülasyonla her sırada en fazla 0,3 puan farklı; bu fark da sadece rastgelelikten. Beklenen hayatta kalan sayısı da yine 7.

    Buradan bir sezgi daha çıkıyor: ortalamada 18 adımın yarısında, yani 9 adımda biri düşüyor. 16 kişiden 9’u düşerse geriye 7 kişi kalır.

    Peki dizide neden sadece 3 kişi kaldı?

    Dizide köprüyü yalnızca üç oyuncu tamamlayabiliyor. Modele göre 3 veya daha az kişinin kalma ihtimali sadece %4,8. Peki bu kadar kötü bir sonuç nasıl çıktı?

    Modelimizin dışarıda bıraktığı şeyler dizide yer alıyor. Bölümde ışıkların kapatılması gibi bir avantajın ortadan kaldırılması, oyuncuların birbirine karışması ve süre baskısı var. Bunların her biri, adım başına %50 olan düşme ihtimalini artırıyor ya da bilinen bir adımı tekrar bilinmez hâle getiriyor.

    Bu, her modelin taşıdığı bir uyarı: sonuç, varsayımlar kadar iyi. Matematiğin yanlış olduğunu değil, gerçek dünyanın modelden daha karmaşık olduğunu gösteriyor.

    Diziyi izlerken bu bölümde kalbim kulaklarımdaydı. O sırada aklımdan geçen de şuydu: ben olsam ya ortalardan bir numara ya da 8. sırayı seçerdim. Seçimim tamamen sezgiseldi. Şimdi matematiksel temelini bildiğim için biraz farklı bakıyorum: 8. sırada hayatta kalma şansı %24, sadece iki sıra geride, 10. sırada ise %59. Sezgim beni ortaya yakın bir yere götürmüş ama hesap, birkaç adım daha geride durmanın ne kadar fark yarattığını gösteriyor.

    Kendin dene

    Not defterinde değerleri değiştirip şu soruları cevaplayabilirsin:

    • Köprü 18 değil 30 adım olsaydı kaç kişi kalırdı? (kopruyu_gec(adim=30))
    • Oyuncular camları biraz ayırt edebilseydi, doğruyu bulma şansı %50 yerine %60 olsaydı ne değişirdi? (Fonksiyondaki 0.5‘i değiştir.)
    • 16 oyuncunun kaçının hayatta kaldığının dağılımını histogram olarak çiz. En sık görülen sonuç hangisi?