Kategori: Popüler Kültürü Kodluyorum

  • Netflix İzleme Geçmişi Panosu 1: Veriyi İndirip Temizlemek

    Netflix İzleme Geçmişi Panosu 1: Veriyi İndirip Temizlemek

    Netflix’te ne kadar zaman geçirdiğimi ve bu zamana da neler izlediğimi hep merak ettim. Aslında Netflix’in bunu Spotify gibi bir yıl sonu etkinliğine dönüştürür diye bekledim ama yapmayınca kendim yapmaya karar verdim. Sonunda izleme geçmişimi indirdim ve Python’a verdim. Karşıma çıkan tablo: Ağustos 2019’dan bugüne 4.986 kayıt, 487 farklı dizi ve 350 film.

    Bu yazı iki bölümlük bir serinin ilki. Bugün veriyi indirip temizliyor ve ilk soruları soruyoruz. İkinci bölümde bunları Streamlit ile tıklanabilir bir panoya çevireceğiz. Kodun tamamı hazır bir not defterinde; kendi verini yükleyip aynı analizi yapabilirsin: Colab’da Aç

    1. Adım: İzleme geçmişini indir

    Netflix’in yardım sayfasına göre adımlar şöyle:

    1. Bir tarayıcıdan Netflix’te Hesap sayfasına git.
    2. Profiller‘den kendi profilini seç.
    3. İzleme etkinliği‘ni aç.
    4. Sayfanın en altındaki Tümünü indir bağlantısına bas.

    NetflixViewingHistory.csv adında bir dosya iner. Bu iş yalnızca tarayıcıdan yapılabiliyor ve her profil için ayrı dosya indiriliyor.

    Dosyayı açınca iki sütun görürsün: ne izlediğin (Title) ve ne zaman izlediğin (Date). Hepsi bu kadar; izleme süresi yok. Bu yüzden analiz boyunca “kaç saat” değil “kaç kayıt” sayacağız. Bir de şunu bil: Netflix bir bölümü yarım bırakıp kapatsan da kaydeder.

    2. Adım: Dosyayı Pandas ile oku

    import pandas as pd
    df = pd.read_csv("NetflixViewingHistory.csv")
    df = df.rename(columns={"Title": "baslik", "Date": "tarih"})
    print(len(df), "kayıt")
    print(df.head())

    3. Adım: Tarihleri düzelt

    İlk sürpriz burada çıktı. Benim dosyamda tarihler 10/21/26 biçimindeydi: önce ay, sonra gün, sonra yılın son iki hanesi. Netflix tarihi hesabının diline göre yazdığı için senin dosyanda 21.10.2026 da olabilir. Kod ikisini de tanısın:

    def tarihi_coz(seri):
    # Netflix tarihi hesabın diline göre farklı yazar: 21.10.2026 ya da 10/21/26 gibi.
    ornek = seri.dropna().astype(str)
    if ornek.str.contains(r"\.").any():
    return pd.to_datetime(seri, format="%d.%m.%Y", errors="coerce")
    # Eğik çizgili biçimde ilk sayı 12'den büyükse gün önce gelir
    parca = ornek.str.split("/")
    gun_once = parca.str[0].astype(int).gt(12).any()
    yil_iki_hane = parca.str[-1].str.len().eq(2).all()
    if gun_once:
    bicim = "%d/%m/%y" if yil_iki_hane else "%d/%m/%Y"
    else:
    bicim = "%m/%d/%y" if yil_iki_hane else "%m/%d/%Y"
    return pd.to_datetime(seri, format=bicim, errors="coerce")
    df["tarih"] = tarihi_coz(df["tarih"])
    df = df.dropna(subset=["tarih"])

    errors="coerce" okunamayan bir tarihi hata vermek yerine boş bırakır. Boş kalan satırları sonra dropna ile atabiliriz.

    4. Adım: Diziyi filmden ayır

    Asıl temizlik işi burada. Bir dizinin her bölümü ayrı bir satır olarak geliyor:

    Weak Hero: Class 2: Episode 8
    Meet Me After School: Episode 5
    Harry Potter and the Chamber of Secrets

    “En çok izlediğim dizi” sorusunu cevaplamak için bölüm adını atıp yalnızca dizinin adını tutmamız gerekiyor. İlk denemem basitti: iki noktadan önceki kısmı dizi adı say. Ama bazı dizilerin kendi adında da iki nokta var (örneğin “Avatar: The Last Airbender”). İkinci sorun: benim verimde “Season” kelimesini hiç içermeyen, yalnızca “Episode 5” gibi biten yüzlerce bölüm vardı ve ilk kodum bunların hepsini film sanıyordu.

    Çözüm iki adımlı oldu:

    import re
    SEZON = re.compile(r"^(Sezon|Season|Bölüm|Episode|Kısıtlı Dizi|Limited Series|Mini Dizi|Kitap|Book|Part|Kısım|Volume|Class|Chapter|Collection)\b", re.IGNORECASE)
    def ayir(baslik):
    # "Sezon" gibi bir kelimeyle başlayan ilk parçaya kadar olan kısmı dizi adı say
    parcalar = baslik.split(": ")
    for i, parca in enumerate(parcalar[1:], start=1):
    if SEZON.match(parca):
    return ": ".join(parcalar[:i]), "Dizi"
    return baslik, "Film"
    df[["isim", "tur"]] = df["baslik"].apply(lambda b: pd.Series(ayir(b)))
    # İkinci kontrol: iki noktadan önceki kısım birden fazla kayıtta geçiyorsa bu bir dizidir
    on_ek = df["baslik"].str.split(": ").str[0].str.strip()
    tekrar = on_ek.map(on_ek.value_counts())
    dizi_mi = (df["tur"] == "Film") & df["baslik"].str.contains(": ") & (tekrar >= 2)
    df.loc[dizi_mi, "isim"] = on_ek[dizi_mi]
    df.loc[dizi_mi, "tur"] = "Dizi"

    İlk denemem 2.145 film buldu. Kelime listesini genişletince bu sayı 918’e, ikinci kontrolden sonra da 350’ye indi. Yani başta gerçek film sayımın altı katından fazlasını film sanıyordum. Veri temizliğinde en önemli alışkanlık bu: sonucu görünce “bu mantıklı mı?” diye sor, mantıksız duruyorsa ham veriye geri dön. Kural yine de kusursuz değil; tek bir bölümünü izlediğin bir dizi hâlâ film sayılabilir. Ama genel tabloyu değiştirecek kadar büyük bir hata bırakmıyor.

    5. Adım: Veriye ilk soruları sor

    Veri temizlendikten sonra her soru birkaç satırlık bir koda dönüşüyor. Aşağıdaki sonuçların hepsi benim verimden.

    En çok izlediğim diziler

    diziler = df[df["tur"] == "Dizi"]
    print(diziler["isim"].value_counts().head(5))
    SıraDiziKayıt
    1How I Met Your Mother208
    2Hunter X Hunter (2011)148
    3Friends147
    4Brooklyn Nine-Nine130
    5Kuroko’s Basketball78

    İlk üçün ikisi uzun soluklu sitcom. Arka planda açık bırakılıp tekrar tekrar izlenen diziler sayıda öne geçiyor; bu liste “en sevdiğim diziler” ile birebir aynı şey değil. [BURAYA: Bu listeye dair kısa yorumun. Örneğin hangisini tekrar tekrar izliyorsun?]

    Yıllara göre

    print(df["tarih"].dt.year.value_counts().sort_index())
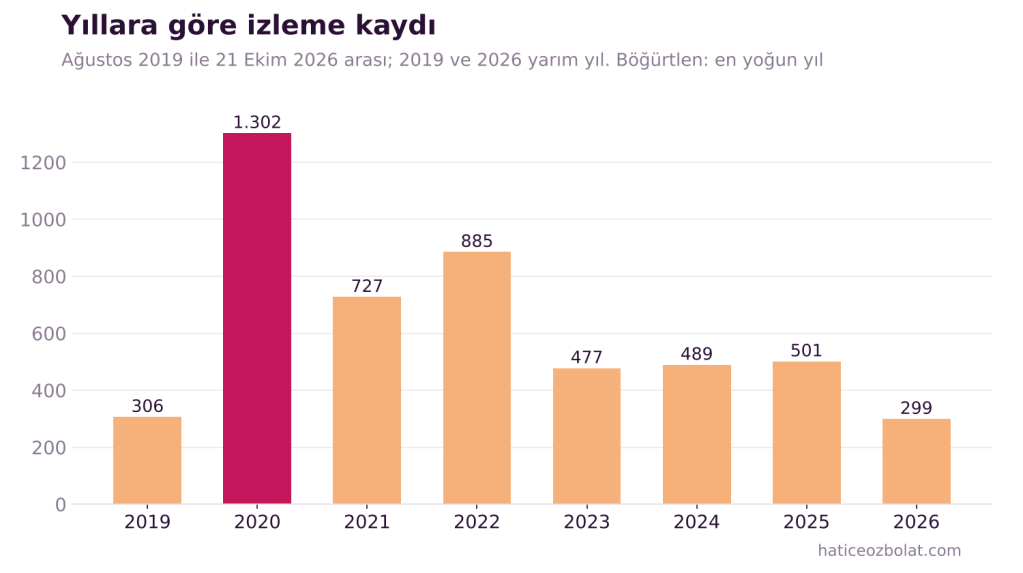
    Zirve yıl 1.302 kayıtla 2020. 2019 ve 2026 yarım yıllar; 2019 Ağustos’ta başlıyor, 2026 ise henüz bitmedi. Pandemi etksini burada görüyoruz.

    Haftanın günlerine göre

    sira = ["Pazartesi", "Salı", "Çarşamba", "Perşembe", "Cuma", "Cumartesi", "Pazar"]
    df["gun"] = df["tarih"].dt.dayofweek.map(lambda i: sira[i])
    print(df["gun"].value_counts().reindex(sira))
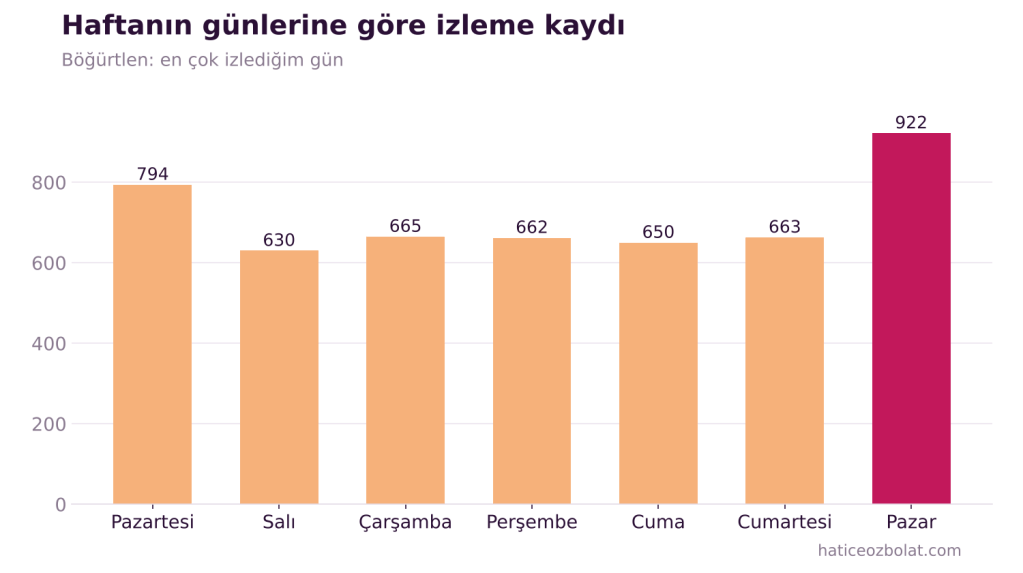
    En çok izlediğim gün 922 kayıtla Pazar, en az izlediğim gün 630 kayıtla Salı. Burada reindex(sira) önemli: o olmadan Pandas günleri sayıya göre sıralar ve grafik Pazartesi’den Pazar’a okunmaz.

    Aylara göre: çok izlediğim ve hiç izlemediğim dönemler

    aylik = df.groupby(df["tarih"].dt.to_period("M")).size()
    # Hiç kayıt olmayan ayları da 0 olarak göster
    tum_aylar = pd.period_range(aylik.index.min(), aylik.index.max(), freq="M")
    aylik = aylik.reindex(tum_aylar, fill_value=0)
    print(aylik.idxmax(), aylik.max())
    print((aylik == 0).sum(), "ay hiç izlenmemiş")
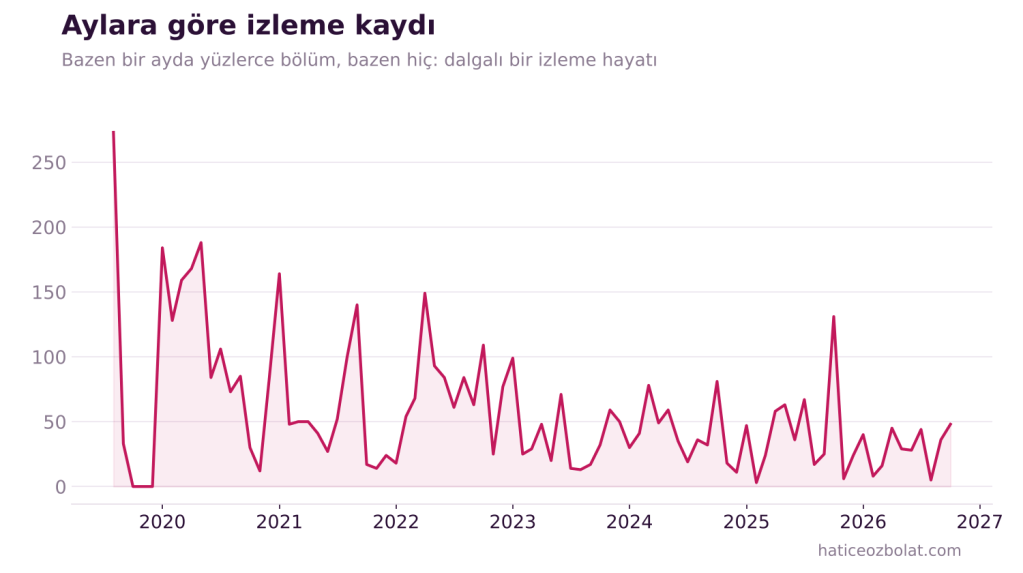
    Bu grafik benim için en dürüst olanı. Hiç kayıt olmayan aylar groupby sonucunda görünmez; reindex ile onları sıfır olarak eklemezsen grafik aradaki boşlukları saklar. Benim verimde 3 ay tamamen boş.

    En yoğun ay 273 kayıtla Ağustos 2019. 2026’ya bakınca dalgalanma çok net: Şubat’ta 8, Ağustos’ta 5, Ekim’de ise şimdiden 48 kayıt. Son 30 günde 69 kayıt var; çoğu Suspicious Partner ve Weak Hero.

    Yani benim izleme alışkanlığım düz bir çizgi değil. Bazı dönemler neredeyse hiç açmıyorum, sonra bir diziye başlayınca bir anda geri dönüyorum. [BURAYA: Bu “bir çok, bir az” dönemlere dair kendi cümlen.]

    Maraton günü ve en uzun ara

    gunluk = df.groupby(df["tarih"].dt.date).size()
    print("Maraton günü:", gunluk.idxmax(), gunluk.max(), "kayıt")
    gunler = pd.Series(sorted(df["tarih"].dt.normalize().unique()))
    aralar = gunler.diff()
    en_uzun = aralar.idxmax()
    print("En uzun ara:", aralar.max().days, "gün",
    gunler[en_uzun - 1].date(), "→", gunler[en_uzun].date())
    • Maraton günü: 20 Aralık 2020, tek günde 36 kayıt. Bunların 35’i Meteor Garden. Nasıl bir gündü hiç hatırlamıyorum.😊
    • En uzun ara: 109 gün. 28 Eylül 2019’dan 15 Ocak 2020’ye kadar hiçbir şey izlememişim. Acaba üyeliğimi mi dondurdum?

    Unutma: Netflix yarım bıraktığın bölümü de kaydettiği için 36 kayıt 36 bölümün sonuna kadar izlendiği anlamına gelmiyor.

    Yıl bitmeden izleme listemi bitirebilir miyim?

    Bu analizi yaparken aklımda bir soru vardı. Yıl bitmeden izleme listemi bitirmek gibi bir hedefim var ve dürüst olmak gerekirse çok zor görünüyor.

    Veri bu soruya kesin bir cevap vermiyor ama bir fikir veriyor. Son 30 günde 69 kayıt var. Aynı hızla gidersem yıl sonuna kadar yaklaşık 160 kayıt daha eklenir. Bunu kendi listenle karşılaştırmak için küçük bir hesap yeter:

    son_30_gun = df[df["tarih"] >= df["tarih"].max() - pd.Timedelta(days=30)]
    gunluk_hiz = len(son_30_gun) / 30
    kalan_gun = (pd.Timestamp("2026-12-31") - df["tarih"].max()).days
    print(f"Bu hızla yıl sonuna kadar yaklaşık {gunluk_hiz * kalan_gun:.0f} kayıt daha")

    Ama aylık grafik bana şunu da hatırlatıyor: benim hızım sabit değil. Şubat’ta 8 kayıt, Ekim’de 48. Hedefe yetişip yetişemeyeceğim hızdan çok, bu dalgalı dönemlerden hangisine denk geldiğime bağlı. Yıl sonunda ne olduğunu panonun ikinci bölümünde verilerle paylaşacağım.

    Gizlilik notu: verin sende kalsın

    İzleme geçmişi kişisel bir veri. Ne izlediğin, ne zaman uyanık olduğun ve hangi dönemlerde ekrandan uzak kaldığın bu dosyadan okunabilir. Ben bu yazıda yalnızca toplamları ve ilk beş listesini paylaştım; ham dosya ne blogda ne de GitHub deposunda.

    Sen de kendi analizini paylaşırken:

    • CSV dosyasını herkese açık bir depoya yükleme. Colab’da dosyayı yalnızca o oturuma yükle; oturum kapanınca silinir.
    • Grafikleri paylaşmadan önce bak: saatlik bir grafik, ne zaman evde olduğunu da anlatabilir.
    • Başkasının profilini analiz edeceksen önce izin iste.

    Sırada ne var?

    Bu bölümde veriyi indirdik, temizledik ve ilk soruları sorduk. Netflix Panosu 2’de aynı kodu Streamlit ile tıklanabilir bir panoya çevireceğiz: yıl seçince grafiklerin değiştiği, kendi CSV’ni yükleyip anında sonuç gördüğün bir sayfa.

    Pandas’a yeni başlıyorsan, buradaki value_counts, groupby ve reindex Python serisinin ilerleyen derslerinde tek tek gelecek. O zamana kadar not defterini açıp kendi verinle oynamak en iyi pratik.
  • Wordle Çözücü Yazmak: Python ile Kelime Oyununu Yenmek

    Wordle Çözücü Yazmak: Python ile Kelime Oyununu Yenmek

    İtiraf edeyim: Wordle’ı çok az oynadım. Ama çözücüsünü yazmak, oynamaktan çok daha keyifli çıktı. Bu yazıda Türkçe Wordle’ı çözen bir Python programını birlikte yazıyoruz. Sonunda program 3.377 kelimenin üzerinde test ediliyor ve ortalama 4’ün altında tahminde doğru kelimeyi buluyor.

    Kod Python Dersi 9’da işleyeceğimiz fonksiyonları ve biraz liste işlemini kullanıyor. Serinin başındaysan da korkma: her adımı açıklıyorum, kodu çalıştırmak için anlaman şart değil. Tüm kod hazır bir not defterinde: Colab’da Aç

    Wordle’ın kısa hikâyesi

    Wordle’ı Galli yazılım mühendisi Josh Wardle, başta kendisi ve partneri Palak Shah için yazdı. Oyun Ekim 2021’de herkese açıldı ve yayılma hızı olağanüstüydü: 1 Kasım 2021’de 90 olan oyuncu sayısı, 2 Ocak 2022’ye gelindiğinde 300 bini, bir hafta sonra da 2 milyonu geçti. The New York Times, oyunu 31 Ocak 2022’de satın aldı.

    Oyun tasarımı açısından neden tuttu?

    Wordle’ın başarısının büyük kısmı birkaç basit tasarım kararından geliyor:

    • Günde tek bulmaca. Herkes aynı kelimeyi çözüyor. Bu, oyunu ortak bir sohbet konusuna çeviriyor ve “bir tane daha” diye saatlerce oynamayı engelliyor; ertesi günü bekletiyor.
    • Paylaşılabilir renkli kareler. Oyuncular kelimeyi açık etmeden sonuçlarını emoji kareleriyle paylaşabiliyor. İlginç olan şu: bu fikir Wardle’dan değil, sonuçlarını böyle paylaşan Yeni Zelandalı bir arkadaş grubundan çıktı. Wardle bunu görüp oyuna ekledi ve oyunun yayılmasında büyük rol oynadı.
    • Basit kural, derin strateji. Kuralları bir dakikada öğrenirsin ama iyi oynamak düşünmeyi gerektirir. Oyun tasarımında bu dengeye sıkça “öğrenmesi kolay, ustalaşması zor” denir.

    Oyun geliştirmeyi düşünüyorsan Wordle iyi bir ders: başarılı bir oyun için büyük bir ekip ya da karmaşık grafikler şart değil.

    Kurallar

    Amacın beş harfli bir kelimeyi en fazla altı tahminde bulmak. Her tahminden sonra harfler renklenir:

    • Yeşil: Harf kelimede var ve doğru yerde.
    • Sarı: Harf kelimede var ama başka bir yerde.
    • Gri: Harf kelimede yok.

    1. Adım: Türkçe kelime listesi

    Bir çözücü için ilk ihtiyaç beş harfli Türkçe kelimelerin listesi. Burada iki açık kaynağı birleştirdim:

    • hunspell-tr: Yazım denetimi için hazırlanmış, MPL-2.0 lisanslı bir Türkçe sözlük. Gerçek kelime köklerini buradan alıyoruz.
    • wordfreq: Dillerde kelimelerin ne sıklıkla kullanıldığını veren bir Python kütüphanesi. Az bilinen kelimeleri elemek için bunu kullanıyoruz.

    Neden ikisi birden? Sözlükteki birçok kök tek başına kelime değil, yalnızca ekleri tutmak için var. Sıklık listesinde ise özel isimler ve çekimli kelimeler bol. İkisinin kesişimi bize hem gerçek hem de tanıdık kelimeler veriyor.

    from collections import Counter
    TR_HARFLER = set("abcçdefgğhıijklmnoöprsştuüvyz")
    def turkce_kucuk(metin):
    # Python'ın lower() fonksiyonu "I" harfini "i" yapar; Türkçede "ı" olmalı.
    return metin.replace("I", "ı").replace("İ", "i").lower()
    def kelime_listesi_yukle(dic_yolu, en_fazla=60000):
    import wordfreq
    kokler = set()
    with open(dic_yolu, encoding="utf-8") as dosya:
    next(dosya) # ilk satır kelime sayısı
    for satir in dosya:
    kelime = turkce_kucuk(satir.split("/")[0].strip())
    if len(kelime) == 5 and set(kelime) <= TR_HARFLER:
    kokler.add(kelime)
    # Sık kullanılan kelimelerle kesiştir: hem gerçek kelime hem tanıdık olsun
    sik = wordfreq.top_n_list("tr", en_fazla)
    return [k for k in sik if k in kokler]

    Sonuç: 3.377 kelime. Birkaç argo kelimeyi de listeden elle çıkardım. Liste kusursuz değil; içinde “benim” ya da “geldi” gibi çekimli kelimeler de var. Bir çözücü için bu yeterli, ama kendi oyununu yapıyorsan listeyi elle temizlemen gerekir.

    Koddaki turkce_kucuk fonksiyonuna dikkat: Türkçe için yazılmış programların en klasik tuzağı burada. Python’ın lower() fonksiyonu büyük “I” harfini “i”ye çevirir, oysa Türkçede karşılığı “ı”dır.

    2. Adım: Renkleri hesaplamak

    Çözücünün kalbi, oyunun kuralını koda çeviren bu fonksiyon. Bir tahmin ve bir cevap alıyor, Wordle’ın göstereceği renkleri döndürüyor: Y yeşil, S sarı, G gri.

    def renkleri_hesapla(tahmin, cevap):
    """Y = yeşil (doğru yer), S = sarı (yanlış yer), G = gri (yok)."""
    sonuc = ["G"] * 5
    kalan = Counter()
    # Önce yeşiller
    for i in range(5):
    if tahmin[i] == cevap[i]:
    sonuc[i] = "Y"
    else:
    kalan[cevap[i]] += 1
    # Sonra sarılar: aynı harf iki kez varsa fazladan sarı vermemek için sayaç kullanıyoruz
    for i in range(5):
    if sonuc[i] == "G" and kalan[tahmin[i]] > 0:
    sonuc[i] = "S"
    kalan[tahmin[i]] -= 1
    return "".join(sonuc)
    print(renkleri_hesapla("elmas", "kalem")) # SSSSG

    Neden iki ayrı döngü? Aynı harf birden fazla geçtiğinde iş karışır. Cevapta bir tane “a” varken tahminde iki “a” varsa, yalnızca biri renklenmeli. Önce yeşilleri yerleştirip kalan harfleri sayarak bu hatayı önlüyoruz. İlk akla gelen basit çözümlerde bu ayrıntı kolayca atlanır.

    3. Adım: Listeyi daraltmak

    Aslında çözücünün bütün zekası tek bir fikirde: Her aday kelime için “Cevap bu kelime olsaydı, aynı renkleri görür müydüm?” diye sor. Görüyorsan aday listede kalır, görmüyorsan elenir.

    def listeyi_daralt(adaylar, tahmin, renkler):
    # Cevap bu kelime olsaydı aynı renkleri görür müydük? Görürsek aday kalır.
    return [k for k in adaylar if renkleri_hesapla(tahmin, k) == renkler]

    Bu tek satır, yeşil, sarı ve gri için ayrı ayrı kural yazmaktan çok daha güvenli. Az önce yazdığımız renk fonksiyonunu yeniden kullanıyoruz ve tekrar eden harf gibi zor durumları zaten o çözüyor.

    4. Adım: Hangi kelimeyi tahmin etmeli?

    Liste daralıyor ama hangi kelimeyle? Basit bir strateji: aday kelimelerde en sık geçen harfleri içeren kelimeyi seç. Bu harfler hakkında bilgi almak listeyi en hızlı küçültür.

    def en_iyi_tahmin(adaylar):
    # Her harfin kaç kelimede geçtiğini say (bir kelimede iki kez geçse de bir say)
    harf_sayisi = Counter()
    for k in adaylar:
    harf_sayisi.update(set(k))
    def puan(kelime):
    return sum(harf_sayisi[h] for h in set(kelime))
    return max(adaylar, key=puan)

    set(kelime) sayesinde aynı harfi iki kez saymıyoruz. “aaaaa” gibi bir kelimenin tek bir harf hakkında bilgi verdiğini hatırla.

    Tüm liste için bu fonksiyonun önerdiği ilk tahmin: ekran. Bu kelime Türkçede çok sık geçen a, e, k, r ve n harflerini bir arada içeriyor.

    Bir oyunu adım adım izle

    Cevap “kalem” olsun:

    TahminRenklerKalan aday
    ekranSSGSG11
    hakemGYSYY2 (kalem, kadem)
    kalemYYYYYBuldu

    Üç tahmin. İlk tahminden sonra 3.377 kelimeden geriye 11 tane kaldı.

    5. Adım: Çözücüyü test etmek

    Bir çözücünün ne kadar iyi olduğunu tek oyunla anlayamayız. Listedeki her kelimeyi sırayla cevap yapıp çözücüye oynattım:

    def oyna(cevap, kelimeler, ilk_tahmin=None):
    adaylar = kelimeler
    for deneme in range(1, 7):
    tahmin = ilk_tahmin if (deneme == 1 and ilk_tahmin) else en_iyi_tahmin(adaylar)
    renkler = renkleri_hesapla(tahmin, cevap)
    if renkler == "YYYYY":
    return deneme
    adaylar = listeyi_daralt(adaylar, tahmin, renkler)
    return None # 6 denemede bulamadı
    sonuclar = Counter(oyna(c, kelimeler, "ekran") for c in kelimeler)

    Sonuçlar:

    Tahmin sayısıKelime sayısı
    11
    2133
    31.043
    41.445
    5568
    6144
    Bulamadı43

    Çözücü 3.377 kelimenin 3.334’ünü altı tahminde buldu; ortalama 3,86 tahmin. Fena değil: bunu yalnızca dört küçük fonksiyonla yaptık.

    Bulamadığı 43 kelime: Wordle tuzağı

    Bulamadığı kelimelere bakmak çok öğretici. Cevap “senin” olduğunda olanlar:

    TahminRenklerKalan aday
    ekranSGGGY81
    gidenGSGSY19
    besinGYSYY4
    seçinYYGYY3
    selinYYGYY2
    sevinYYGYY1

    Dördüncü tahminden sonra yalnızca bir harf eksik, ama o harf için dört aday var: seçin, selin, sevin, senin. Çözücü onları tek tek denediği için altı hakkı bitti. Wordle oyuncularının iyi tanıdığı bir tuzak bu. Kalan aday sayısı az da olsa her seferinde tek harf eleyebiliyorsan sıkışırsın.

    Kapak ile kazak, saman ile yaman, kapan ile kapar gibi kelimeler de aynı sebeple bu listede.

    Çözücüyü kendi oyununda kullan

    Türkçe bir Wordle oynarken çözücüden yardım almak istersen, not defterindeki bu hücreyi kullanabilirsin. Her tahminden sonra oyunda gördüğün renkleri Y, S, G harfleriyle yaz:

    adaylar = kelimeler
    # Her tahminden sonra bu iki satırı değiştirip hücreyi yeniden çalıştır
    tahmin = "ekran"
    renkler = "SSGSG" # oyunda gördüğün renkler: Y yeşil, S sarı, G gri
    adaylar = listeyi_daralt(adaylar, tahmin, renkler)
    print(len(adaylar), "aday kaldı:", adaylar[:15])
    print("Önerim:", en_iyi_tahmin(adaylar))

    Oyunun kelime listesi bizimkiyle aynı olmayabilir. Aday listesi boş kalırsa, cevap muhtemelen bizim listemizde değildir.

    Sana meydan okuma

    Tuzağı aşmak için çözücüyü geliştirebilir misin? İpucu: Kalan aday çok azken her zaman aday listeden tahmin yapmak zorunda değilsin. “seçin, selin, sevin, senin” arasında kaldığında ç, l, v ve n harflerinin ikisini birden sınayan bir kelime, bir hamlede iki adayı eleyebilir. Bulamadığı kelime sayısını 43’ün altına indirirsen sonucunu yorumlarda paylaş.

    Oyunlar ve kod

    Bu yazı, “Popüler Kültürü Kodluyorum” serisinin ilk yazısı. Serideki her yazıda sevdiğin bir oyunu, diziyi ya da filmi küçük bir kod projesine çevireceğiz. Oyunlarla ilgileniyorsan, çözücü yazmak oyun geliştirmeye de iyi bir giriş: bir oyunu çözebilmek için önce kurallarını koda çevirmen gerekiyor, ki bu da oyunu yazmanın ilk adımı.

    Kaynaklar