
Netflix’te ne kadar zaman geçirdiğimi ve bu zamana da neler izlediğimi hep merak ettim. Aslında Netflix’in bunu Spotify gibi bir yıl sonu etkinliğine dönüştürür diye bekledim ama yapmayınca kendim yapmaya karar verdim. Sonunda izleme geçmişimi indirdim ve Python’a verdim. Karşıma çıkan tablo: Ağustos 2019’dan bugüne 4.986 kayıt, 487 farklı dizi ve 350 film.
Bu yazı iki bölümlük bir serinin ilki. Bugün veriyi indirip temizliyor ve ilk soruları soruyoruz. İkinci bölümde bunları Streamlit ile tıklanabilir bir panoya çevireceğiz. Kodun tamamı hazır bir not defterinde; kendi verini yükleyip aynı analizi yapabilirsin: Colab’da Aç
1. Adım: İzleme geçmişini indir
Netflix’in yardım sayfasına göre adımlar şöyle:
- Bir tarayıcıdan Netflix’te Hesap sayfasına git.
- Profiller‘den kendi profilini seç.
- İzleme etkinliği‘ni aç.
- Sayfanın en altındaki Tümünü indir bağlantısına bas.
NetflixViewingHistory.csv adında bir dosya iner. Bu iş yalnızca tarayıcıdan yapılabiliyor ve her profil için ayrı dosya indiriliyor.
Dosyayı açınca iki sütun görürsün: ne izlediğin (Title) ve ne zaman izlediğin (Date). Hepsi bu kadar; izleme süresi yok. Bu yüzden analiz boyunca “kaç saat” değil “kaç kayıt” sayacağız. Bir de şunu bil: Netflix bir bölümü yarım bırakıp kapatsan da kaydeder.
2. Adım: Dosyayı Pandas ile oku
import pandas as pddf = pd.read_csv("NetflixViewingHistory.csv")df = df.rename(columns={"Title": "baslik", "Date": "tarih"})print(len(df), "kayıt")print(df.head())
3. Adım: Tarihleri düzelt
İlk sürpriz burada çıktı. Benim dosyamda tarihler 10/21/26 biçimindeydi: önce ay, sonra gün, sonra yılın son iki hanesi. Netflix tarihi hesabının diline göre yazdığı için senin dosyanda 21.10.2026 da olabilir. Kod ikisini de tanısın:
def tarihi_coz(seri): # Netflix tarihi hesabın diline göre farklı yazar: 21.10.2026 ya da 10/21/26 gibi. ornek = seri.dropna().astype(str) if ornek.str.contains(r"\.").any(): return pd.to_datetime(seri, format="%d.%m.%Y", errors="coerce") # Eğik çizgili biçimde ilk sayı 12'den büyükse gün önce gelir parca = ornek.str.split("/") gun_once = parca.str[0].astype(int).gt(12).any() yil_iki_hane = parca.str[-1].str.len().eq(2).all() if gun_once: bicim = "%d/%m/%y" if yil_iki_hane else "%d/%m/%Y" else: bicim = "%m/%d/%y" if yil_iki_hane else "%m/%d/%Y" return pd.to_datetime(seri, format=bicim, errors="coerce")df["tarih"] = tarihi_coz(df["tarih"])df = df.dropna(subset=["tarih"])
errors="coerce" okunamayan bir tarihi hata vermek yerine boş bırakır. Boş kalan satırları sonra dropna ile atabiliriz.
4. Adım: Diziyi filmden ayır
Asıl temizlik işi burada. Bir dizinin her bölümü ayrı bir satır olarak geliyor:
Weak Hero: Class 2: Episode 8Meet Me After School: Episode 5Harry Potter and the Chamber of Secrets
“En çok izlediğim dizi” sorusunu cevaplamak için bölüm adını atıp yalnızca dizinin adını tutmamız gerekiyor. İlk denemem basitti: iki noktadan önceki kısmı dizi adı say. Ama bazı dizilerin kendi adında da iki nokta var (örneğin “Avatar: The Last Airbender”). İkinci sorun: benim verimde “Season” kelimesini hiç içermeyen, yalnızca “Episode 5” gibi biten yüzlerce bölüm vardı ve ilk kodum bunların hepsini film sanıyordu.
Çözüm iki adımlı oldu:
import reSEZON = re.compile(r"^(Sezon|Season|Bölüm|Episode|Kısıtlı Dizi|Limited Series|Mini Dizi|Kitap|Book|Part|Kısım|Volume|Class|Chapter|Collection)\b", re.IGNORECASE)def ayir(baslik): # "Sezon" gibi bir kelimeyle başlayan ilk parçaya kadar olan kısmı dizi adı say parcalar = baslik.split(": ") for i, parca in enumerate(parcalar[1:], start=1): if SEZON.match(parca): return ": ".join(parcalar[:i]), "Dizi" return baslik, "Film"df[["isim", "tur"]] = df["baslik"].apply(lambda b: pd.Series(ayir(b)))# İkinci kontrol: iki noktadan önceki kısım birden fazla kayıtta geçiyorsa bu bir dizidiron_ek = df["baslik"].str.split(": ").str[0].str.strip()tekrar = on_ek.map(on_ek.value_counts())dizi_mi = (df["tur"] == "Film") & df["baslik"].str.contains(": ") & (tekrar >= 2)df.loc[dizi_mi, "isim"] = on_ek[dizi_mi]df.loc[dizi_mi, "tur"] = "Dizi"
İlk denemem 2.145 film buldu. Kelime listesini genişletince bu sayı 918’e, ikinci kontrolden sonra da 350’ye indi. Yani başta gerçek film sayımın altı katından fazlasını film sanıyordum. Veri temizliğinde en önemli alışkanlık bu: sonucu görünce “bu mantıklı mı?” diye sor, mantıksız duruyorsa ham veriye geri dön. Kural yine de kusursuz değil; tek bir bölümünü izlediğin bir dizi hâlâ film sayılabilir. Ama genel tabloyu değiştirecek kadar büyük bir hata bırakmıyor.
5. Adım: Veriye ilk soruları sor
Veri temizlendikten sonra her soru birkaç satırlık bir koda dönüşüyor. Aşağıdaki sonuçların hepsi benim verimden.
En çok izlediğim diziler
diziler = df[df["tur"] == "Dizi"]print(diziler["isim"].value_counts().head(5))
| Sıra | Dizi | Kayıt |
|---|---|---|
| 1 | How I Met Your Mother | 208 |
| 2 | Hunter X Hunter (2011) | 148 |
| 3 | Friends | 147 |
| 4 | Brooklyn Nine-Nine | 130 |
| 5 | Kuroko’s Basketball | 78 |
İlk üçün ikisi uzun soluklu sitcom. Arka planda açık bırakılıp tekrar tekrar izlenen diziler sayıda öne geçiyor; bu liste “en sevdiğim diziler” ile birebir aynı şey değil. [BURAYA: Bu listeye dair kısa yorumun. Örneğin hangisini tekrar tekrar izliyorsun?]
Yıllara göre
print(df["tarih"].dt.year.value_counts().sort_index())
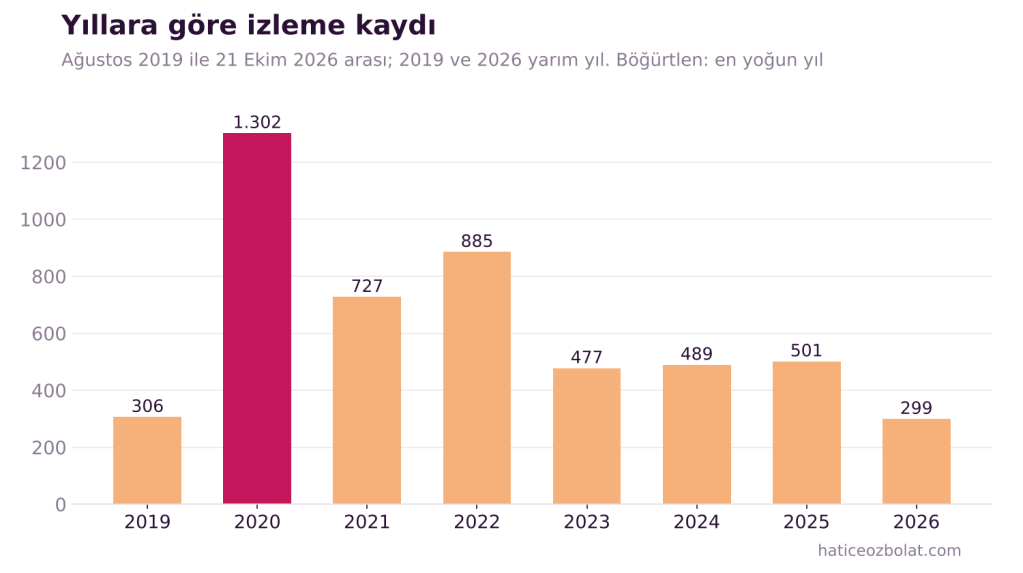
Zirve yıl 1.302 kayıtla 2020. 2019 ve 2026 yarım yıllar; 2019 Ağustos’ta başlıyor, 2026 ise henüz bitmedi. Pandemi etksini burada görüyoruz.
Haftanın günlerine göre
sira = ["Pazartesi", "Salı", "Çarşamba", "Perşembe", "Cuma", "Cumartesi", "Pazar"]df["gun"] = df["tarih"].dt.dayofweek.map(lambda i: sira[i])print(df["gun"].value_counts().reindex(sira))
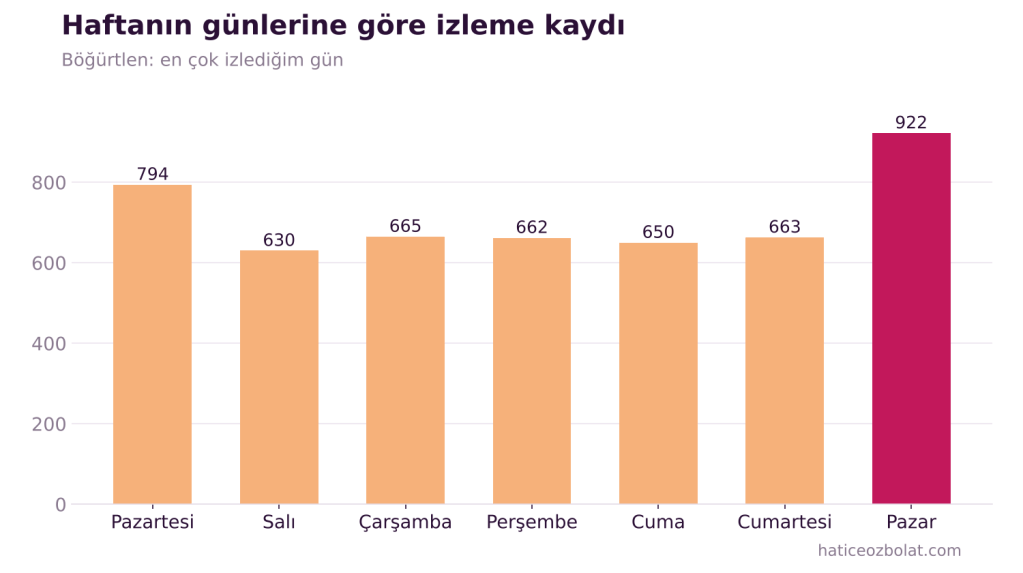
En çok izlediğim gün 922 kayıtla Pazar, en az izlediğim gün 630 kayıtla Salı. Burada reindex(sira) önemli: o olmadan Pandas günleri sayıya göre sıralar ve grafik Pazartesi’den Pazar’a okunmaz.
Aylara göre: çok izlediğim ve hiç izlemediğim dönemler
aylik = df.groupby(df["tarih"].dt.to_period("M")).size()# Hiç kayıt olmayan ayları da 0 olarak göstertum_aylar = pd.period_range(aylik.index.min(), aylik.index.max(), freq="M")aylik = aylik.reindex(tum_aylar, fill_value=0)print(aylik.idxmax(), aylik.max())print((aylik == 0).sum(), "ay hiç izlenmemiş")
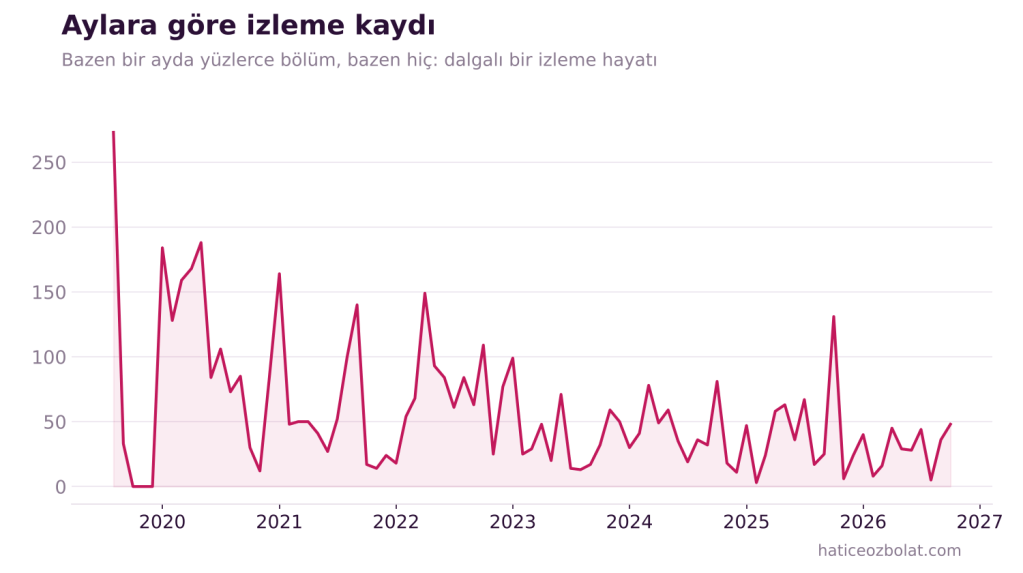
Bu grafik benim için en dürüst olanı. Hiç kayıt olmayan aylar groupby sonucunda görünmez; reindex ile onları sıfır olarak eklemezsen grafik aradaki boşlukları saklar. Benim verimde 3 ay tamamen boş.
En yoğun ay 273 kayıtla Ağustos 2019. 2026’ya bakınca dalgalanma çok net: Şubat’ta 8, Ağustos’ta 5, Ekim’de ise şimdiden 48 kayıt. Son 30 günde 69 kayıt var; çoğu Suspicious Partner ve Weak Hero.
Yani benim izleme alışkanlığım düz bir çizgi değil. Bazı dönemler neredeyse hiç açmıyorum, sonra bir diziye başlayınca bir anda geri dönüyorum. [BURAYA: Bu “bir çok, bir az” dönemlere dair kendi cümlen.]
Maraton günü ve en uzun ara
gunluk = df.groupby(df["tarih"].dt.date).size()print("Maraton günü:", gunluk.idxmax(), gunluk.max(), "kayıt")gunler = pd.Series(sorted(df["tarih"].dt.normalize().unique()))aralar = gunler.diff()en_uzun = aralar.idxmax()print("En uzun ara:", aralar.max().days, "gün", gunler[en_uzun - 1].date(), "→", gunler[en_uzun].date())
- Maraton günü: 20 Aralık 2020, tek günde 36 kayıt. Bunların 35’i Meteor Garden. Nasıl bir gündü hiç hatırlamıyorum.😊
- En uzun ara: 109 gün. 28 Eylül 2019’dan 15 Ocak 2020’ye kadar hiçbir şey izlememişim. Acaba üyeliğimi mi dondurdum?
Unutma: Netflix yarım bıraktığın bölümü de kaydettiği için 36 kayıt 36 bölümün sonuna kadar izlendiği anlamına gelmiyor.
Yıl bitmeden izleme listemi bitirebilir miyim?
Bu analizi yaparken aklımda bir soru vardı. Yıl bitmeden izleme listemi bitirmek gibi bir hedefim var ve dürüst olmak gerekirse çok zor görünüyor.
Veri bu soruya kesin bir cevap vermiyor ama bir fikir veriyor. Son 30 günde 69 kayıt var. Aynı hızla gidersem yıl sonuna kadar yaklaşık 160 kayıt daha eklenir. Bunu kendi listenle karşılaştırmak için küçük bir hesap yeter:
son_30_gun = df[df["tarih"] >= df["tarih"].max() - pd.Timedelta(days=30)]gunluk_hiz = len(son_30_gun) / 30kalan_gun = (pd.Timestamp("2026-12-31") - df["tarih"].max()).daysprint(f"Bu hızla yıl sonuna kadar yaklaşık {gunluk_hiz * kalan_gun:.0f} kayıt daha")
Ama aylık grafik bana şunu da hatırlatıyor: benim hızım sabit değil. Şubat’ta 8 kayıt, Ekim’de 48. Hedefe yetişip yetişemeyeceğim hızdan çok, bu dalgalı dönemlerden hangisine denk geldiğime bağlı. Yıl sonunda ne olduğunu panonun ikinci bölümünde verilerle paylaşacağım.
Gizlilik notu: verin sende kalsın
İzleme geçmişi kişisel bir veri. Ne izlediğin, ne zaman uyanık olduğun ve hangi dönemlerde ekrandan uzak kaldığın bu dosyadan okunabilir. Ben bu yazıda yalnızca toplamları ve ilk beş listesini paylaştım; ham dosya ne blogda ne de GitHub deposunda.
Sen de kendi analizini paylaşırken:
- CSV dosyasını herkese açık bir depoya yükleme. Colab’da dosyayı yalnızca o oturuma yükle; oturum kapanınca silinir.
- Grafikleri paylaşmadan önce bak: saatlik bir grafik, ne zaman evde olduğunu da anlatabilir.
- Başkasının profilini analiz edeceksen önce izin iste.
Sırada ne var?
Bu bölümde veriyi indirdik, temizledik ve ilk soruları sorduk. Netflix Panosu 2’de aynı kodu Streamlit ile tıklanabilir bir panoya çevireceğiz: yıl seçince grafiklerin değiştiği, kendi CSV’ni yükleyip anında sonuç gördüğün bir sayfa.
Pandas’a yeni başlıyorsan, buradaki value_counts, groupby ve reindex Python serisinin ilerleyen derslerinde tek tek gelecek. O zamana kadar not defterini açıp kendi verinle oynamak en iyi pratik.
Bir yanıt yazın