Kategori: Teknoloji Okuryazarlığı

Teknoloji Okuryazarlığı
– Dijital Güvenlik
– e-Devlet Kullanımı
– Günlük Hayatta Teknoloji

  • Token Nedir? Yapay Zekâ Metni Nasıl Okur?

    Token Nedir? Yapay Zekâ Metni Nasıl Okur?

    Yapay zekâ araçlarının fiyat sayfalarında, kullanım sınırlarında ve teknik açıklamalarında hep aynı kelime geçiyor: token. “Bu model 200 bin token okuyabiliyor”, “1 milyon token başına şu kadar ücret”… Peki token tam olarak ne? Ve neden aynı cümlenin Türkçesi İngilizcesinden daha fazla token tutuyor?

    Kısa tanım

    Token, bir dil modelinin metni okurken kullandığı en küçük parça. Bazen bir kelimenin tamamı, bazen bir hece gibi bir parçası, bazen tek bir harf ya da noktalama işareti.

    Modeller metni harf harf ya da kelime kelime değil, token token okuyor. Metni token’lara bölen programa tokenizer deniyor. Tokenizer her token’ı bir sayıya çeviriyor; model aslında kelimeleri değil, bu sayı dizisini görüyor.

    Bir örnekle görelim

    Aşağıdaki sonuçlar, OpenAI’ın GPT-4 ve GPT-3.5 modellerinde kullanılan cl100k_base tokenizer’ıyla alındı:

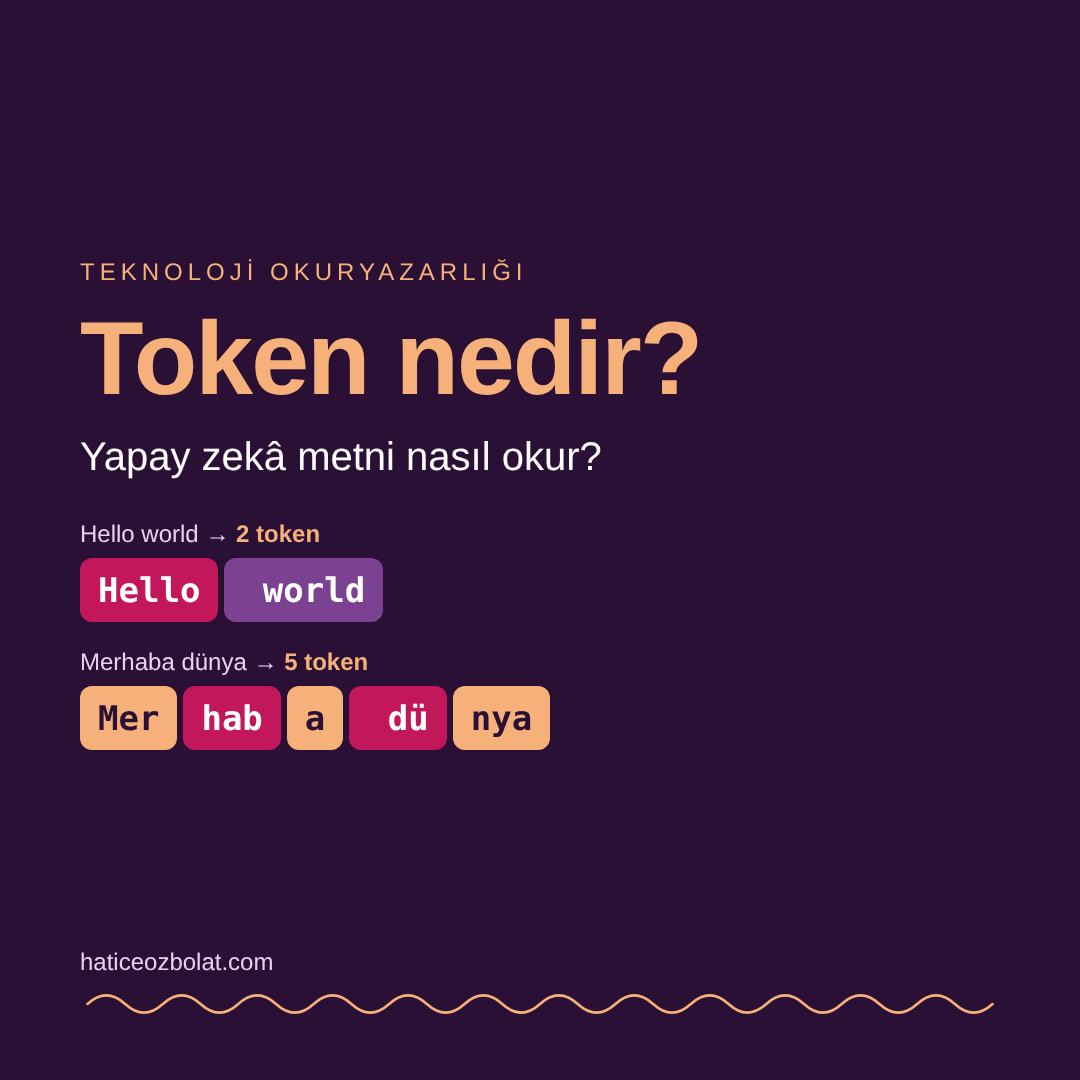
    "Hello world" → 'Hello' | ' world' → 2 token
    "Merhaba dünya" → 'Mer' | 'hab' | 'a' | ' dü' | 'nya' → 5 token

    İngilizcede iki kelime iki token. Türkçede ise “Merhaba” üç, “dünya” iki parçaya bölünmüş. Kelimelerin önündeki boşluk da token’ın bir parçası (' world', ' dü').

    Aynı anlamdaki iki cümle daha:

    CümleKarakterToken
    The weather is very nice today.317
    Bugün hava çok güzel.218
    How does AI read text?226
    Yapay zekâ metni nasıl okur?2813

    Türkçe cümle daha kısa olmasına rağmen daha fazla token tutuyor. Bu örneklerde İngilizcede bir token ortalama 4 civarı karaktere denk gelirken, Türkçede 2 ile 2,5 karakter arasında kalıyor.

    Neden Türkçe daha fazla token tutuyor?

    Tokenizer’lar eğitildikleri metinlerde sık geçen parçaları tek bir token olarak öğreniyor. Eğitim verisinin büyük kısmı İngilizce olduğu için “weather”, “today” gibi kelimeler tek parça halinde sözlükte yer alıyor. Türkçe kelimeler ise daha nadir görüldüğü için parçalara bölünüyor.

    Buna Türkçenin eklemeli yapısı da ekleniyor. Bir köke ekler eklendikçe ortaya çok sayıda farklı kelime çıkıyor ve bunların her birinin sözlükte hazır olması mümkün değil. En uç örnek:

    "Çekoslovakyalılaştıramadıklarımızdanmışsınız"
    → Ç | ek | os | lovak | yal | ı | la | şt | ı | ram | ad | ıkl | ar | ım | ız | dan | m | ış | s | ını | z
    → 21 token

    Tek bir kelime 21 token. Tokenizer’ın böldüğü yerlerin Türkçe eklerle her zaman örtüşmediğine de dikkat et: “şt”, “ram”, “m” gibi parçalar dilbilgisi açısından bir anlam taşımıyor. Tokenizer dili anlamaya çalışmıyor, sadece sık gördüğü parçaları kullanıyor.

    Not: Her model ailesinin kendi tokenizer’ı var ve daha yeni tokenizer’lar çok dilli metinlerde genellikle daha verimli. Aynı cümle başka bir modelde farklı sayıda token tutabilir; ama genel eğilim, yani Türkçenin İngilizceden daha fazla token tutması, çoğu modelde görülüyor.

    Token neden önemli?

    • Bağlam penceresi: Bir modelin aynı anda “aklında tutabildiği” metin miktarı token cinsinden ölçülüyor. Uzun bir PDF’i ya da uzun bir sohbeti modele verirken sınırı belirleyen şey karakter sayısı değil, token sayısı.
    • Maliyet: API üzerinden kullanılan modeller genellikle token başına ücretlendiriliyor; hem gönderdiğin hem de modelin ürettiği token’lar sayılıyor. Aynı içerik Türkçe daha fazla token tutuyorsa, Türkçe işlem aynı modelde daha pahalıya gelebiliyor.
    • Hız: Modeller cevabı token token üretiyor. Ekranda kelimelerin parça parça belirmesinin sebebi bu.
    • Garip hatalar: Modelin bir kelimedeki harfleri saymakta zorlanması gibi tuhaf hataların bir kısmı buradan geliyor. Model kelimeyi harf harf değil, parça parça görüyor.

    Kendin dene

    Colab’da şu kodla istediğin metnin kaç token tuttuğunu ve nasıl bölündüğünü görebilirsin:

    !pip install -q tiktoken
    import tiktoken
    enc = tiktoken.get_encoding("cl100k_base")
    metin = "Bugün hava çok güzel."
    kodlar = enc.encode(metin)
    print(len(kodlar), "token")
    print(kodlar) # modelin gördüğü sayılar
    print([enc.decode([k]) for k in kodlar]) # her sayının karşılığı olan parça
    8 token
    [47873, 16461, 305, 2979, 58112, 55008, 28493, 13]
    ['Bug', 'ün', ' h', 'ava', ' çok', ' gü', 'zel', '.']

    İkinci satırdaki sayılar modelin gerçekten “okuduğu” şey. Kendi adını, bir şehir adını ya da uzun bir Türkçe kelimeyi deneyip kaç parçaya bölündüğüne bak.

    Bir cümlede

    Token, dil modelinin metni okuduğu parça; bağlam sınırı, maliyet ve hız hep token’la ölçülüyor ve Türkçe aynı anlamı genellikle İngilizceden daha fazla token’la ifade ediyor.
    Devamını oku

  • Makine Öğrenmesi ve Derin Öğrenme Arasındaki Fark

    Makine Öğrenmesi ve Derin Öğrenme Arasındaki Fark

    Yapay zekâ haberlerinde “makine öğrenmesi” ve “derin öğrenme” ifadeleri çoğu zaman aynı cümlede, hatta birbirinin yerine geçiyor. Aslında ikisi aynı şey değil, ama birbirinden bağımsız da değil. Bu yazıda farkı bir örnekle ve on satırlık bir Python koduyla netleştireceğiz.

    Kısa tanım

    • Makine öğrenmesi, bilgisayarın kuralları bizim yazmamıza gerek kalmadan, örneklerden öğrenmesini sağlayan yöntemlerin genel adı.
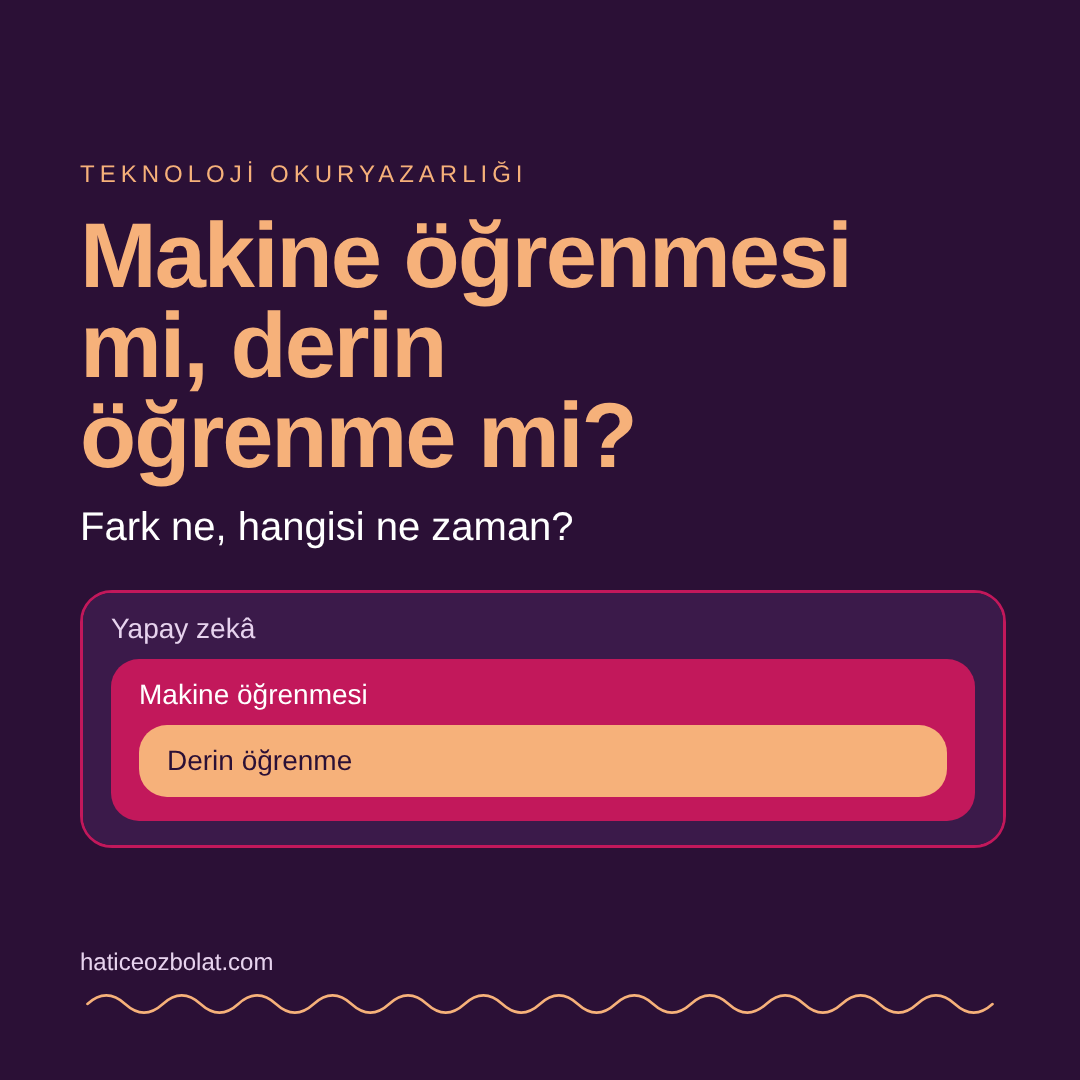
    • Derin öğrenme, makine öğrenmesinin bir alt dalı. Çok katmanlı yapay sinir ağlarını kullanıyor.

    Yani her derin öğrenme modeli bir makine öğrenmesi modeli, ama her makine öğrenmesi modeli derin öğrenme değil. İç içe üç halka gibi düşünebilirsin: En dışta yapay zekâ, onun içinde makine öğrenmesi, en içte derin öğrenme.

    Asıl fark: özellikleri kim seçiyor?

    Bir fotoğrafta kedi olup olmadığını anlayan bir model yapmak istediğimizi düşünelim.

    Klasik makine öğrenmesiyle önce bizim düşünmemiz gerekiyor: Bir kediyi kedi yapan ne? Kulakların şekli, bıyıklar, gözlerin konumu… Bu özellikleri fotoğraftan çıkaran kodu biz yazıyoruz. Model de bu özelliklere bakıp karar vermeyi öğreniyor. Bu adıma özellik mühendisliği (feature engineering) deniyor.

    Derin öğrenmeyle modele doğrudan fotoğrafın piksellerini veriyoruz. Sinir ağının ilk katmanları kenarları ve renk geçişlerini, sonraki katmanlar kulak ve göz gibi şekilleri, son katmanlar da “kedi yüzü” gibi bütünleri tanımayı kendi kendine öğreniyor. Hangi özelliğe bakacağını biz söylemiyoruz.

    Adındaki “derin” kelimesi de buradan geliyor: Üst üste dizilmiş çok sayıda katman.

    Python ile küçük bir karşılaştırma

    scikit-learn’ün içinde gelen el yazısı rakam veri setini kullanalım: 8×8 piksellik, 1797 rakam görüntüsü. Aynı veride bir karar ağacını ve küçük bir sinir ağını deneyelim:

    from sklearn.datasets import load_digits
    from sklearn.model_selection import train_test_split
    from sklearn.tree import DecisionTreeClassifier
    from sklearn.neural_network import MLPClassifier
    X, y = load_digits(return_X_y=True)
    X_egitim, X_test, y_egitim, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
    agac = DecisionTreeClassifier(random_state=42).fit(X_egitim, y_egitim)
    sinir_agi = MLPClassifier(hidden_layer_sizes=(64, 32), max_iter=1000, random_state=42).fit(X_egitim, y_egitim)
    print(f"Karar ağacı: {agac.score(X_test, y_test):.0%}") # 86%
    print(f"Sinir ağı: {sinir_agi.score(X_test, y_test):.0%}") # 97%

    Aynı piksellerle karar ağacı test verisinin %86’sını, iki gizli katmanlı sinir ağı %97’sini doğru tanıdı. Karar ağacı tek tek piksellere bakıp “5. piksel koyu mu?” gibi sorular sorabiliyor. Sinir ağı ise katmanları sayesinde pikselleri bir araya getirip çizgi ve eğri gibi daha anlamlı kalıplar öğrenebiliyor.

    Dürüst bir not: İki katmanlı bu ağ gerçek dünyadaki derin öğrenme modellerinin yanında çok küçük. Yine de fikri göstermek için yeterli: Ham veride kalıp arama işinde katmanlı ağlar çok güçlü.

    Yan yana

    Klasik makine öğrenmesiDerin öğrenme
    Özellikleri kim seçiyor?Çoğunlukla insanModel kendisi öğreniyor
    Veri ihtiyacıAz ya da orta miktarda veriyle çalışabiliyorGenelde çok fazla veri istiyor
    DonanımSıradan bir bilgisayar yeterliBüyük modeller için GPU gerekiyor
    AçıklanabilirlikKarar ağacı gibi modellerin kuralları okunabiliyorNeden o kararı verdiğini anlamak zor
    Güçlü olduğu yerTablo verisi: satış, kredi, müşteri kayıtlarıGörüntü, ses, metin
    ÖrneklerKarar ağacı, rastgele orman, lojistik regresyonYapay sinir ağları, CNN’ler, Transformer’lar

    Hangisi ne zaman?

    • Elinde Excel benzeri tablo verisi varsa (müşteri yaşı, alışveriş sayısı, şehir gibi) klasik makine öğrenmesi çoğu zaman hem daha hızlı hem daha açıklanabilir bir sonuç veriyor.
    • Elinde fotoğraf, ses kaydı ya da uzun metin varsa derin öğrenme genelde çok önde.
    • Veri azsa, önce basit bir modelle başla. Basit model işini görüyorsa daha karmaşıkına geçmene gerek yok.

    Bu blogdan iki örnek: Seçmen Şapkası yazısındaki karar ağacı klasik makine öğrenmesiydi; dört puanlık bir tablo verisinden kurallar çıkardı ve o kuralları okuyabildik. Attention yazısında anlattığım Transformer modelleri ise derin öğrenmenin bugünkü en bilinen örneği; ChatGPT gibi dil modellerinin temeli bunlar.

    [AFFILIATE: makine öğrenmesine giriş kitabı ya da kursu]

    Bir cümlede

    Makine öğrenmesi bilgisayarın örneklerden öğrenmesi; derin öğrenme ise bunun, çok katmanlı sinir ağlarıyla neye bakacağını da kendi kendine öğrenen alt dalı.

    Devamını oku

  • Veritabanı Nedir? SQL ve NoSQL Farkı

    Veritabanı Nedir? SQL ve NoSQL Farkı

    Instagram’a girdiğinde takip ettiğin herkesin paylaşımları saniyeler içinde önüne geliyor. Bankadan para çektiğinde bakiyen anında düşüyor. Bir alışveriş sitesinde “kaşmir kazak” diye aradığında milyonlarca ürün arasından doğru olanlar listeleniyor. Bütün bunların arkasında aynı şey var: veritabanı.

    Kısa tanım

    Veritabanı, verilerin düzenli bir şekilde saklanmasını, hızlıca bulunmasını ve güvenle güncellenmesini sağlayan sistem. Veritabanını yöneten yazılıma da veritabanı yönetim sistemi deniyor; MySQL, PostgreSQL, SQLite, MongoDB bunların en bilinenleri.

    Excel’den farkı ne?

    İlk bakışta bir veritabanı tablosu Excel’deki bir sayfaya benziyor: satırlar ve sütunlar. Fark, ölçek ve güvenilirlikte ortaya çıkıyor:

    • Boyut: Excel bir milyon satır civarında zorlanır; veritabanları milyarlarca kaydı tutabilir.
    • Aynı anda çok kullanıcı: Bir Excel dosyasını aynı anda bin kişi düzenleyemez. Bir banka veritabanına ise saniyede binlerce işlem gelir ve hiçbiri birbirini bozmaz.
    • Kurallar: Veritabanına “not sütununa sadece sayı girilebilir” ya da “aynı T.C. kimlik numarası iki kez kaydedilemez” gibi kurallar koyabilirsin. Excel’de bu kuralları korumak çok daha zor.
    • Sorgulama: Veritabanına özel bir dille soru sorarsın ve cevabı anında alırsın.

    SQL: veritabanına soru sormanın dili

    Verileri birbirine bağlı tablolarda tutan veritabanlarına ilişkisel veritabanı deniyor. Bu veritabanlarıyla konuşmak için kullanılan dil SQL (Structured Query Language). SQL’in güzel tarafı, neredeyse İngilizce cümle gibi okunması:

    SELECT ad, notu FROM ogrenciler WHERE notu >= 50 ORDER BY notu DESC;

    Bu satırı şöyle okuyabilirsin: “Öğrenciler tablosundan, notu 50 ve üstü olanların adını ve notunu getir; nota göre büyükten küçüğe sırala.”

    Python ile ilk SQL sorgun

    Veritabanı denemek için bir sunucu kurman gerekmiyor. Python’un içinde hazır gelen sqlite3 modülüyle, Colab’da bile bir veritabanı kurup sorgulayabilirsin:

    import sqlite3
    baglanti = sqlite3.connect(":memory:") # bellekte geçici bir veritabanı
    imlec = baglanti.cursor()
    imlec.execute("CREATE TABLE ogrenciler (ad TEXT, bolum TEXT, notu INTEGER)")
    imlec.executemany(
    "INSERT INTO ogrenciler VALUES (?, ?, ?)",
    [("Ayşe", "Bilgisayar", 85), ("Mert", "Elektrik", 45), ("Zeynep", "Bilgisayar", 92)],
    )
    for satir in imlec.execute("SELECT ad, notu FROM ogrenciler WHERE notu >= 50 ORDER BY notu DESC"):
    print(satir)
    # ('Zeynep', 92)
    # ('Ayşe', 85)
    for satir in imlec.execute("SELECT bolum, AVG(notu) FROM ogrenciler GROUP BY bolum"):
    print(satir)
    # ('Bilgisayar', 88.5)
    # ('Elektrik', 45.0)

    İlk sorgu geçen öğrencileri, ikincisi her bölümün not ortalamasını veriyor. Python derslerinde aynı işleri döngü ve sözlüklerle yapmıştık; SQL’de ise ne istediğini söylüyorsun, nasıl yapılacağına veritabanı karar veriyor.

    NoSQL: tablo dışında bir dünya

    Her veri tabloya rahat sığmaz. Bir sosyal medya gönderisini düşün: Bazılarında tek fotoğraf var, bazılarında on fotoğraf; bazılarında konum var, bazılarında yok; yorum sayısı sıfırdan binlere kadar değişiyor. NoSQL (“Not only SQL”, yani sadece SQL değil) veritabanları bu tür esnek veriler için geliştirildi.

    En yaygın NoSQL türü doküman veritabanı. Burada her kayıt, Python sözlüğüne çok benzeyen bir belge:

    {
    "kullanici": "ayse",
    "metin": "Bugün ilk SQL sorgumu yazdım!",
    "fotograflar": ["kod.png"],
    "etiketler": ["python", "sql"],
    "begeni": 42
    }

    Bir sonraki gönderide konum alanı olabilir, fotograflar hiç olmayabilir; veritabanı buna itiraz etmez. MongoDB bu türün en bilinen örneği. Anahtar-değer veritabanları (Redis gibi) ve graf veritabanları da NoSQL ailesinden.

    Hangisi ne zaman?

    SQL (ilişkisel)NoSQL
    Veri yapısıSabit tablolar, belirli sütunlarEsnek; her kayıt farklı olabilir
    Güçlü olduğu yerTutarlılık, tablolar arası ilişkilerHızlı büyüme, değişken yapılar
    Tipik örnekBanka hesapları, öğrenci kayıtları, siparişlerSosyal medya akışı, oyun verileri, sensör kayıtları
    Bilinen sistemlerPostgreSQL, MySQL, SQLiteMongoDB, Redis

    Yeni başlıyorsan önce SQL öğren. Veri analisti ve veri bilimci iş ilanlarının büyük kısmı SQL istiyor ve bir kez öğrendiğinde hemen her ilişkisel veritabanında kullanabiliyorsun. 3 Kasım’da başlayacak Sınav ve Mülakat serisinin ilk yazısı da tam olarak SQL soru tipleri üzerine.

    Bir cümlede

    Veritabanı, verini düzenli, güvenli ve hızlı erişilebilir tutan sistemdir; SQL ona tablolarla, NoSQL esnek belgelerle soru sormanın yoludur.

  • Açık Kaynak Nedir?

    Açık Kaynak Nedir?

    Python derslerinde kullandığımız Python’un kendisi, telefonların çoğunda çalışan Android’in temelindeki Linux, Firefox tarayıcısı… Hepsinin ortak bir özelliği var: Kodlarını herkes okuyabilir. Bunlara açık kaynak yazılım deniyor.

    Kısa tanım

    Açık kaynak, bir yazılımın kaynak kodunun herkese açık olması ve bir lisansla insanlara bu kodu kullanma, inceleme, değiştirme ve paylaşma izni verilmesi demek. Kaynak kod, bir programın insanların okuyabildiği, programlama diliyle yazılmış hali.

    Karşıtı kapalı kaynak (ya da mülk) yazılım: Programı kullanırsın ama kodunu göremez, değiştiremezsin.

    Bir benzetme: yemek tarifi

    Bir restoranda harika bir yemek yedin. Kapalı kaynak, o yemeği sadece restoranda yiyebilmek gibi: Tadına bakarsın ama tarifi sır. Açık kaynak ise tarifin kapıya asılması gibi: İstersen evde yaparsın, tuzunu azaltırsın, kendi versiyonunu arkadaşına verirsin. Biri tarifte bir hata bulursa herkes düzeltmesinden faydalanır.

    Kendin dene: Python’un içine bak

    Python açık kaynak olduğu için, kullandığın hazır fonksiyonların kodunu bilgisayarından okuyabilirsin. Mesela medyanı (ortanca değeri) hesaplayan fonksiyonun içine bakalım:

    import inspect
    import statistics
    print(inspect.getsource(statistics.median))

    Çıktının son kısmı şöyle:

        data = sorted(data)
        n = len(data)
        if n == 0:
            raise StatisticsError("no median for empty data")
        if n % 2 == 1:
            return data[n // 2]
        else:
            i = n // 2
            return (data[i - 1] + data[i]) / 2

    Tanıdık geldi mi? sorted ve len Python Dersi 7’den, if/else Python Dersi 5’ten. Python’u yazan geliştiriciler de bizim derslerde öğrendiğimiz araçlarla kod yazıyor. Açık kaynağın en güzel tarafı bu: “Bu nasıl çalışıyor?” diye merak ettiğinde cevabı kendin okuyabiliyorsun.

    Açık kaynak bedava mı demek?

    Çoğu zaman evet ama asıl mesele bu değil. Açık kaynak dünyasında sık kullanılan bir söz var: “Bedava bira gibi değil, özgür konuşma gibi özgür.” Yani önemli olan fiyat değil, kodla ne yapabileceğin. Ücretsiz olup kodu kapalı olan birçok uygulama var; bunlar açık kaynak değil.

    Açık kaynak kod kullanan şirketler de para kazanabilir: destek hizmeti satarak, bulutta barındırarak ya da açık kaynak bir projenin üstüne kendi ürününü kurarak.

    Lisanslar: “Şu şartlarla kullanabilirsin”

    Kodun herkese görünür olması tek başına yetmez; neye izin verildiğini lisans belirler. En sık karşılaşacağın üç lisans:

    LisansKısaca
    MITÇok serbest. Kodu istediğin gibi kullan, sadece lisans metnini ve telif notunu koru.
    Apache 2.0MIT’e benzer serbestlik, ek olarak patent haklarıyla ilgili maddeler içerir.
    GPLKodu değiştirip dağıtırsan, senin sürümün de aynı şekilde açık kaynak olmak zorunda.

    GitHub’da bir projenin lisansını görmek için depodaki LICENSE dosyasına bakman yeterli. Lisansı olmayan bir kod, herkese açık görünse bile hukuken açık kaynak sayılmaz; sahibi izin vermedikçe kullanım hakları belirsiz kalır.

    Neden önemli?

    • Öğrenmek için: Gerçek projelerin kodunu okumak, ders kitabından sonra gelen en iyi okul.
    • Güven için: Kod herkese açık olduğu için başkaları da inceleyip hataları ve güvenlik açıklarını bulabiliyor.
    • Hız için: Herkes tekerleği yeniden icat etmiyor. Veri biliminde kullandığımız pandas, NumPy, scikit-learn gibi kütüphanelerin hepsi açık kaynak.
    • Kariyer için: Açık kaynak bir projeye yaptığın katkılar herkese açık bir portfolyo gibi çalışır.

    Nasıl katkı verilir?

    Açık kaynak projeye katkı vermek için usta bir yazılımcı olman gerekmiyor. Başlamak için birkaç kolay yol:

    • Kullandığın bir projede hata bulursan, projenin GitHub sayfasında “issue” açarak bildir.
    • Belgelerdeki yazım hatalarını düzelt ya da eksik bir örneği ekle.
    • Belgelerin Türkçe çevirisine yardım et.
    • GitHub’da “good first issue” etiketli işlere bak; bunlar yeni başlayanlar için ayrılmış küçük görevler.

    Bir cümlede

    Açık kaynak, bir yazılımın tarifini herkese açmak demek: Herkes okuyabilir, değiştirebilir, paylaşabilir; kuralları da lisans belirler.

  • Bulut Bilişim Nedir? Günlük Hayattan Örneklerle

    Bulut Bilişim Nedir? Günlük Hayattan Örneklerle

    Fotoğrafların telefonda yer kaplamasın diye “buluta yedekle” seçeneğine bastıysan bulut bilişimi zaten kullanıyorsun. Gmail’e girdiğinde, Netflix’te dizi açtığında ya da Python derslerinde Google Colab’da kod çalıştırdığında da öyle. Peki bu “bulut” tam olarak nerede?

    Kısa tanım

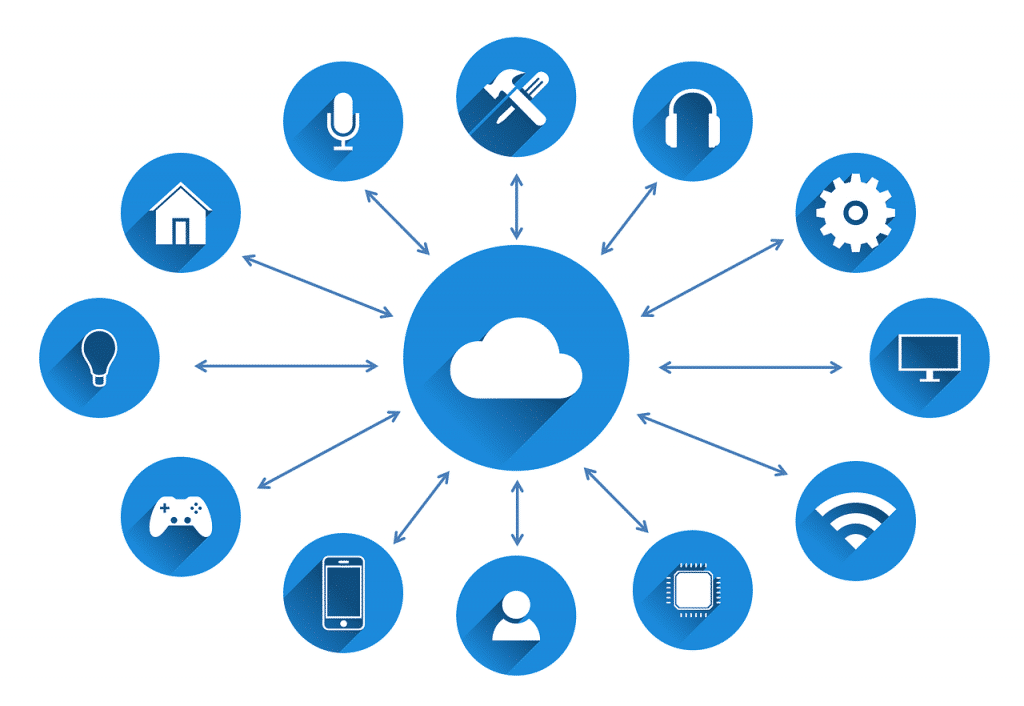
    Bulut bilişim, bilgisayar gücünü (depolama alanı, işlemci, yazılım) kendi cihazına kurmak yerine internet üzerinden başka bir şirketin bilgisayarlarından kiralamak demek. Bulut gökyüzünde değil; dünyanın farklı yerlerindeki büyük veri merkezlerinde duran, binlerce sunucudan oluşan gerçek makineler.

    Bir benzetme: jeneratör mü, şebeke mi?

    Eskiden elektriğe ihtiyacı olan bir fabrika kendi jeneratörünü kurardı. Jeneratörü almak, bakımını yapmak, bozulunca tamir etmek fabrikanın işiydi. Sonra şehir şebekesi geldi: fişi takıyorsun, kullandığın kadar ödüyorsun, santralin nasıl çalıştığıyla ilgilenmiyorsun.

    Bulut bilişim, bilgisayarlar için şebeke gibi. Kendi sunucunu alıp bir odada çalıştırmak yerine bir bulut sağlayıcısından ihtiyacın kadar kiralıyorsun. İşin büyüyünce daha fazla kiralıyor, küçülünce azaltıyorsun.

    Günlük hayattan örnekler

    • Fotoğraf yedekleme (Google Fotoğraflar, iCloud): Fotoğrafların telefonundan çok bir veri merkezindeki disklerde duruyor; telefonunu kaybetsen de gitmiyor.
    • E-posta (Gmail, Outlook): Mailler bilgisayarına değil, sağlayıcının sunucularına kaydediliyor. Bu yüzden hangi cihazdan girersen gir aynı kutuyu görüyorsun.
    • Ortak belgeler (Google Dokümanlar): Aynı dosyayı üç kişi aynı anda düzenleyebiliyor, çünkü dosya kimsenin bilgisayarında değil, ortak bir sunucuda.
    • Google Colab: Python derslerinde kodu kendi bilgisayarında değil, Google’ın sunucusunda çalıştırıyorsun. Bilgisayarına Python kurmana gerek kalmamasının sebebi bu.

    Kendin dene: kod nerede çalışıyor?

    Aşağıdaki kodu önce Colab’da, sonra (Python kuruluysa) kendi bilgisayarında çalıştır:

    import platform
    import os
    print("Makine adı:", platform.node())
    print("İşletim sistemi:", platform.system())
    print("İşlemci çekirdeği:", os.cpu_count())

    Colab’da gördüğün makine adı ve işletim sistemi seninkinden farklı çıkacak; Colab’da işletim sistemi olarak Linux görürsün. Çünkü kod gerçekten başka bir bilgisayarda, bir veri merkezinde çalışıyor. Ekranda gördüğün sadece o makinenin sana gönderdiği sonuç.

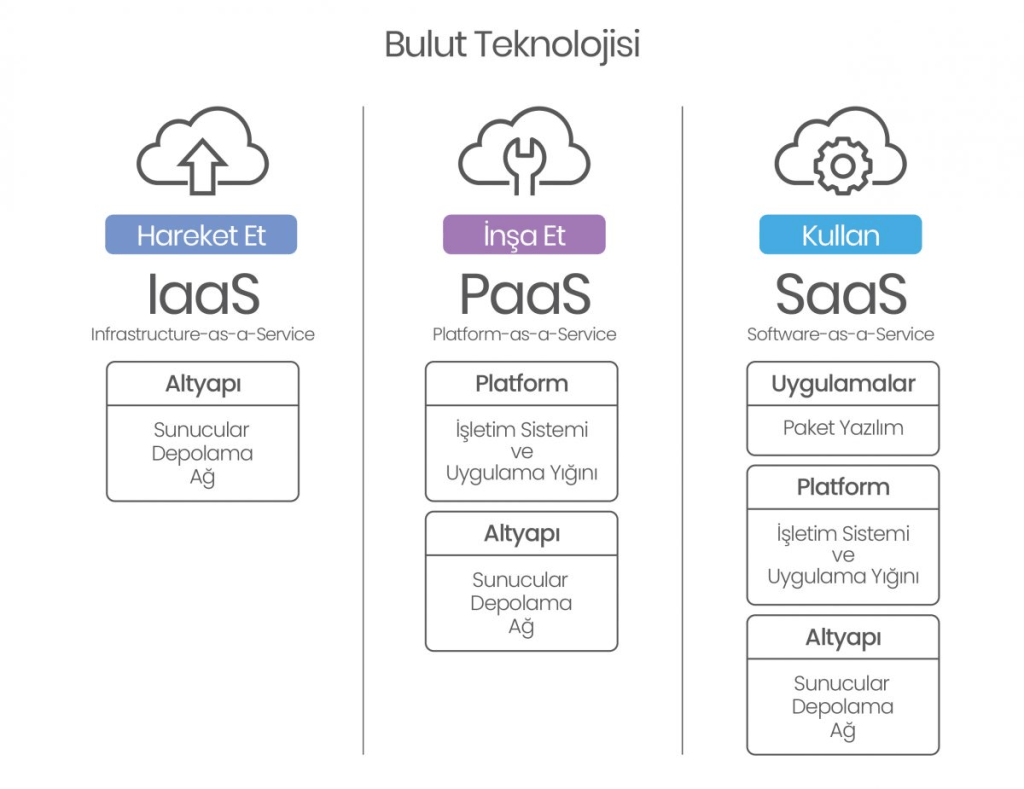
    Bulut hizmetinin üç türü

    Bulut hizmetleri, işin ne kadarını sağlayıcıya bıraktığına göre üçe ayrılıyor. En kolay anlatımı pizza benzetmesi:

    • IaaS (Altyapı hizmeti): Mutfağı kiralıyorsun; malzemeyi alıp pizzayı kendin yapıyorsun. Sana boş bir sanal sunucu veriliyor, üstüne ne kuracağın senin işin. Örnek: Amazon EC2, Google Compute Engine.
    • PaaS (Platform hizmeti): Hamur ve fırın hazır, sen sadece malzemeyi seçiyorsun. Kodunu yüklüyorsun, sunucuyu ayakta tutmak sağlayıcının işi. Örnek: Google App Engine, Heroku.
    • SaaS (Yazılım hizmeti): Pizzayı hazır sipariş ediyorsun. Programı kullanıyorsun, gerisiyle hiç uğraşmıyorsun. Örnek: Gmail, Google Dokümanlar, Canva.

    Günlük hayatta en çok SaaS kullanıyoruz. Veri bilimi ve yazılım tarafında ise IaaS ve PaaS da sık karşına çıkacak.

    Büyük bulut sağlayıcıları

    En bilinen üç sağlayıcı Amazon Web Services (AWS), Microsoft Azure ve Google Cloud. Üçü de yeni başlayanlar için sınırlı ücretsiz kullanım seçenekleri sunuyor; veri ve yazılım iş ilanlarında da bu isimleri sık görürsün.

    Artıları ve eksileri

    Artıları

    • Pahalı donanım almadan güçlü bilgisayarlara erişirsin.
    • Kullandığın kadar ödersin; ihtiyacın artınca hızlıca büyütürsün.
    • Verine her yerden, her cihazdan ulaşırsın.
    • Yedekleme ve donanım bakımı sağlayıcının işidir.

    Eksileri

    • İnternet yoksa erişim de yok.
    • Verin başka bir şirketin sunucusunda duruyor; gizlilik ve güvenlik ayarlarına dikkat etmen gerekir.
    • Kullanımı takip etmezsen fatura sürpriz yapabilir; açık unutulan bir sunucu çalıştığı sürece ücretlendirilir.
    • Bir sağlayıcıya çok bağlanınca başka birine geçmek zorlaşabilir.

    Bir cümlede

    Bulut bilişim, bilgisayar gücünü kendin sahip olmak yerine internet üzerinden kiralamaktır; fotoğraf yedeğinden Colab’a kadar her gün kullandığın birçok şey bu sayede çalışıyor.

  • Algoritma Nedir? Günlük Hayattan Örneklerle

    Algoritma Nedir? Günlük Hayattan Örneklerle

    “Algoritma” kelimesini sosyal medya haberlerinden duymuşsundur: “Instagram algoritması değişti”, “algoritma bunu öne çıkarıyor”. Kulağa gizemli geliyor ama aslında her gün kullandığın bir şey: bir işi yapmak için sırası belli, açık adımlar.

    Kısa tanım

    Algoritma, bir problemi çözmek ya da bir işi tamamlamak için izlenen, sırası belli ve sonunda biten adımlar dizisidir. Bilgisayar programları algoritmaların bir programlama diliyle yazılmış hâlidir.

    Bir yemek tarifi gibi

    Bir çay demleme tarifini düşün:

    1. Çaydanlığa su koy ve kaynat.
    2. Demliğe iki tatlı kaşığı çay koy.
    3. Kaynayan suyu demliğe dök.
    4. Demliği çaydanlığın üstüne koy, 10-15 dakika demlenmeye bırak.

    Bu bir algoritma. Adımların sırası önemli (suyu kaynatmadan demliğe dökemezsin), her adım açık ve sonunda bitiyor. Bilgisayar için yazılan bir algoritmanın tek farkı, adımların çok daha kesin olması gerektiği: “biraz çay koy” bir insana yeter, bilgisayara yetmez.

    İyi bir algoritmanın özellikleri

    • Açık: Her adım tek bir şekilde anlaşılır.
    • Sıralı: Hangi adımın önce geldiği bellidir.
    • Sonlu: Bir noktada biter; sonsuza kadar dönmez.
    • Doğru: Her olası girdi için istenen sonucu verir.
    • Verimli: İşi gereksiz adımlarla uzatmaz.

    Python’da küçük bir algoritma: en yüksek not

    Bir listedeki en yüksek notu bulmak için adımları önce Türkçe yazalım:

    1. İlk notu “şimdiye kadarki en yüksek” kabul et.
    2. Geri kalan her notu tek tek kontrol et.
    3. Daha büyük bir not görürsen “en yüksek”i onunla değiştir.
    4. Liste bitince elindeki “en yüksek” cevaptır.

    Aynı adımlar Python’da:

    notlar = [70, 85, 40, 90, 65]
    en_yuksek = notlar[0] # 1. adım
    for n in notlar: # 2. adım
    if n > en_yuksek: # 3. adım
    en_yuksek = n
    print(en_yuksek) # 4. adım: 90

    Python’da bu iş için hazır bir fonksiyon var: max(notlar). Ama hazır fonksiyonun arkasında da tam olarak bu adımları izleyen bir algoritma çalışıyor. Buradaki for ve if‘i Python Dersi 5 ve 6’da anlattım.

    Aynı iş, farklı algoritmalar: sayı tahmin oyunu

    Bir arkadaşın 1 ile 100 arasında bir sayı tuttu. Her tahmininde sana sadece “daha büyük” ya da “daha küçük” diyor. Nasıl tahmin edersin?

    Birinci yol: sırayla dene. 1 mi? 2 mi? 3 mü? Sayı 73’se 73 tahmin yaparsın. Buna doğrusal arama deniyor.

    İkinci yol: her seferinde ikiye böl. Önce 50 de. “Daha büyük” derse 51 ile 100 arasının ortasını (75) söyle. “Daha küçük” derse 51 ile 74’ün ortasını söyle. Her tahmin, kalan aralığı yarıya indiriyor. Buna ikili arama (binary search) deniyor.

    Bu iki yöntem Python’da yazılıp tahminler sayıldığında sonuç şöyle:

    AralıkTutulan sayıSırayla denemeİkiye bölme
    1 – 1007373 tahmin6 tahmin
    1 – 1.000.000999.999999.999 tahmin19 tahmin

    Aralık 10.000 kat büyüdü, ikili aramanın tahmin sayısı 6’dan sadece 19’a çıktı. Bir milyonluk aralıkta bile 20 tahmin her zaman yetiyor. Algoritma seçimi işte bu yüzden önemli: ikisi de doğru cevabı buluyor, ama biri saniyede, diğeri saatlerce sonra.

    Tek bir şartı var: ikili arama ancak sıralı bir listede çalışır. Telefon rehberinde bir ismi bulurken ortadan açıp “daha ileride mi, geride mi?” diye bakman da aynı fikir; rehber alfabetik olduğu için işe yarıyor.

    Günlük hayattaki algoritmalar

    • Harita uygulamaları iki nokta arasındaki en kısa ya da en hızlı yolu bir algoritmayla hesaplıyor.
    • Sosyal medya akışı hangi gönderiyi önce göstereceğine bir sıralama algoritmasıyla karar veriyor. “Algoritma değişti” denince kast edilen bu sıralama kuralları.
    • Öneri sistemleri (Netflix, Spotify, YouTube), geçmişte izlediklerine ya da dinlediklerine bakarak sana ne önereceğini seçiyor.
    • Arama motorları milyonlarca sayfa arasından aramana en uygun olanları sıralıyor.

    Bir cümlede

    Algoritma, bir işi yapmanın sırası belli, açık adımlarıdır; aynı bilgisayarda bir işin saniyeler mi saatler mi süreceğini çoğu zaman seçilen algoritma belirler.

  • Büyük Dil Modeli (LLM) Nedir?

    Büyük Dil Modeli (LLM) Nedir?

    ChatGPT, Gemini ya da Claude ile konuştuğunda aslında bir büyük dil modeli ile konuşuyorsun. İngilizcesi large language model, kısaca LLM. Bu yazıda LLM’in ne olduğunu, nasıl çalıştığını ve neden bazen kendinden emin bir şekilde yanlış söylediğini sade bir dille anlatıyorum.

    Kısa tanım

    Bir büyük dil modeli, çok büyük miktarda metin üzerinde eğitilmiş ve bir metnin devamında hangi kelimenin geleceğini tahmin etmeyi öğrenmiş bir yapay zekâ modelidir. Ne kadar akıllı görünürse görünsün, temelde yaptığı şey bu: “Buraya kadar yazılana göre sıradaki kelime ne olmalı?”

    Telefonundaki klavyeyi düşün

    Telefonda mesaj yazarken klavyenin üstünde üç kelime önerisi çıkar. “Günaydın” yazınca “nasılsın” önerir, çünkü daha önce yazdıklarından bu ikisinin sık sık peş peşe geldiğini öğrenmiştir. Bir LLM bu fikrin çok, çok daha büyük bir versiyonu.

    Bu fikri birkaç satır Python ile deneyebiliriz. Aşağıdaki minik “dil modeli” beş cümle okuyor ve her kelimeden sonra hangi kelimenin kaç kez geldiğini sayıyor:

    from collections import Counter, defaultdict
    metin = """bugün hava çok güzel
    bugün hava biraz soğuk
    bugün okula gittim
    yarın hava çok sıcak olacak
    hava çok güzel olunca parka gideriz"""
    # Her kelimeden sonra hangi kelimenin kaç kez geldiğini say
    sonraki = defaultdict(Counter)
    for satir in metin.splitlines():
    kelimeler = satir.split()
    for once, sonra in zip(kelimeler, kelimeler[1:]):
    sonraki[once][sonra] += 1
    def tahmin_et(kelime):
    toplam = sum(sonraki[kelime].values())
    return {k: f"%{100 * s / toplam:.0f}" for k, s in sonraki[kelime].most_common()}
    print("bugün →", tahmin_et("bugün")) # {'hava': '%67', 'okula': '%33'}
    print("hava →", tahmin_et("hava")) # {'çok': '%75', 'biraz': '%25'}

    Modelimiz “bugün” kelimesinden sonra %67 ihtimalle “hava” geleceğini öğrendi. Her seferinde en olası kelimeyi seçersek sıfırdan bir cümle bile üretebiliyor: bugün hava çok güzel.

    Bu modeli gerçek bir LLM’den ayıran iki şey var:

    1. Sadece bir önceki kelimeye bakıyor. Gerçek bir LLM, yazılan metnin tamamına bakıyor ve hangi kelimenin hangisiyle ilgili olduğunu tartıyor. Bunu sağlayan “dikkat” mekanizmasını, Attention Is All You Need yazısında anlattım.
    2. Beş cümle okudu. Gerçek bir LLM kitaplar, makaleler ve web sayfalarından oluşan devasa bir metin yığını okuyor.

    “Büyük” ne demek?

    Bir modelin büyüklüğü genellikle parametre sayısıyla ölçülür. Parametreleri, modelin eğitim sırasında ayarladığı milyonlarca düğme gibi düşünebilirsin; bizim minik modelimizde bunların karşılığı “hangi kelimeden sonra ne geliyor” sayacıydı. Örneğin 2020’de tanıtılan GPT-3’ün 175 milyar parametresi vardı. Bugünün modelleri daha da büyük, ama şirketler sayıları artık her zaman açıklamıyor.

    Nasıl eğitiliyor?

    Kabaca iki aşamada:

    1. Ön eğitim (pre-training): Model devasa bir metin yığını üzerinde, cümlelerin devamını tahmin ederek eğitilir. Tahmin yanlışsa düğmeler biraz düzeltilir. Bu, milyarlarca kez tekrarlanır. GPT’deki “P” harfi buradan geliyor: pre-trained.
    2. İnce ayar (fine-tuning): Sadece metnin devamını tahmin eden bir model sohbet etmeyi bilmez. Bu aşamada model, insanların yazdığı örnek soru-cevaplarla ve insanların hangi cevabı daha iyi bulduğuna dair geri bildirimlerle eğitilir. Bu yöntemlerden birinin adı RLHF, yani insan geri bildirimiyle pekiştirmeli öğrenme.

    LLM’ler neden bazen uyduruyor?

    Model “doğru olanı” değil, “en olası görüneni” üretmek üzere eğitildi. Bir soruya cevap verirken, gerçekten var olmayan bir kitap adı ya da tarih, dil açısından çok “olası” görünebilir. Buna halüsinasyon deniyor ve ayrı bir yazının konusu. Şimdilik akılda tutman gereken: bir LLM’in verdiği bilgiyi, özellikle sayı, tarih ve kaynaklarda, mutlaka kontrol et.

    Bilinen örnekler

    • ChatGPT (OpenAI): GPT serisi modelleri kullanıyor.
    • Gemini (Google)
    • Claude (Anthropic)
    • Llama (Meta): Açık ağırlıklı modeller; kendi bilgisayarında ya da sunucunda çalıştırabiliyorsun.

    Bir cümlede

    Bir büyük dil modeli, devasa miktarda metinden “bir metnin devamında ne gelir?” sorusunu cevaplamayı öğrenmiş ve bu basit yeteneği sohbet, özetleme, çeviri ve kod yazmaya kadar genişletmiş bir modeldir.