Yapay zekâ araçlarının fiyat sayfalarında, kullanım sınırlarında ve teknik açıklamalarında hep aynı kelime geçiyor: token. “Bu model 200 bin token okuyabiliyor”, “1 milyon token başına şu kadar ücret”… Peki token tam olarak ne? Ve neden aynı cümlenin Türkçesi İngilizcesinden daha fazla token tutuyor?
Kısa tanım
Token, bir dil modelinin metni okurken kullandığı en küçük parça. Bazen bir kelimenin tamamı, bazen bir hece gibi bir parçası, bazen tek bir harf ya da noktalama işareti.
Modeller metni harf harf ya da kelime kelime değil, token token okuyor. Metni token’lara bölen programa tokenizer deniyor. Tokenizer her token’ı bir sayıya çeviriyor; model aslında kelimeleri değil, bu sayı dizisini görüyor.
Bir örnekle görelim
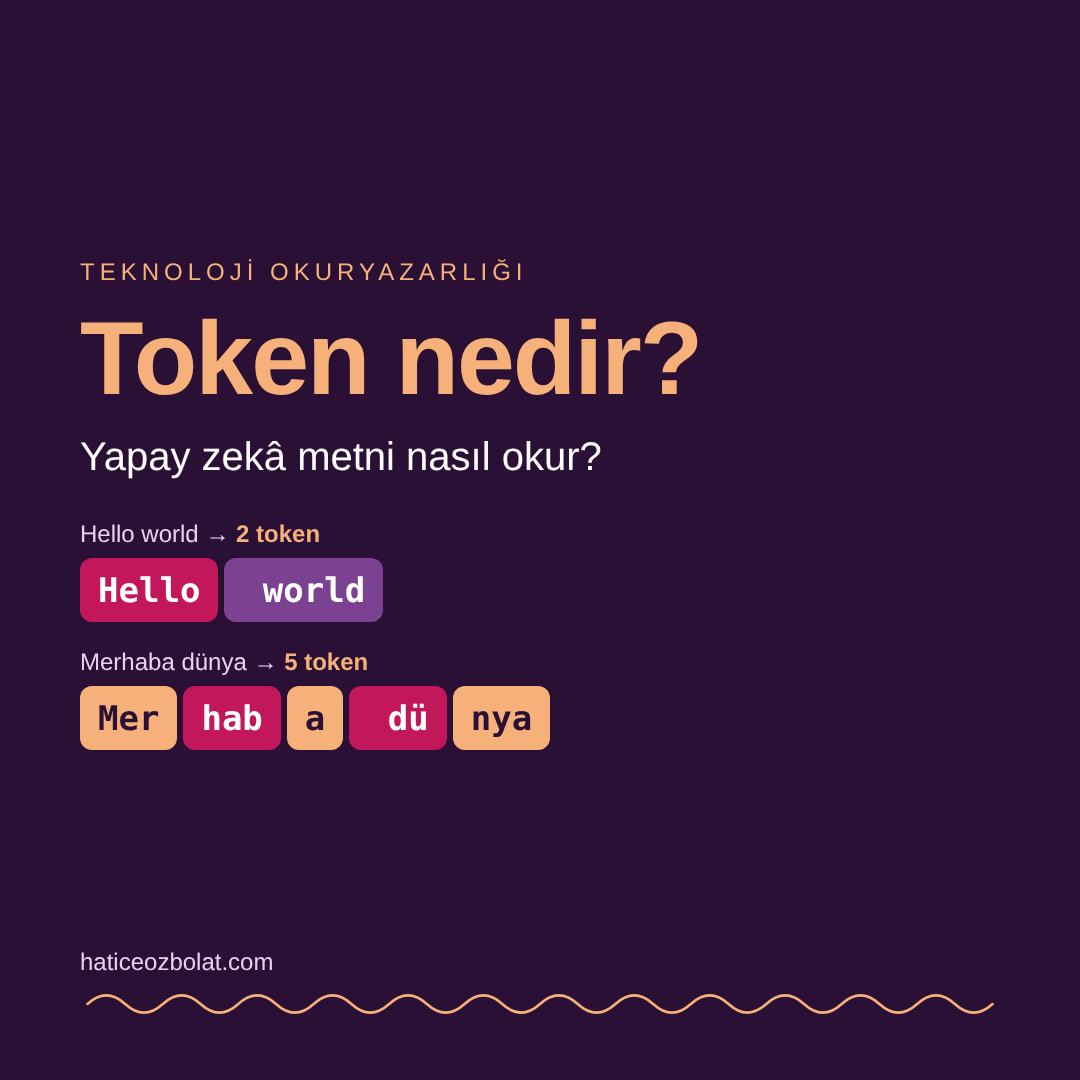
Aşağıdaki sonuçlar, OpenAI’ın GPT-4 ve GPT-3.5 modellerinde kullanılan cl100k_base tokenizer’ıyla alındı:
"Hello world" → 'Hello' | ' world' → 2 token"Merhaba dünya" → 'Mer' | 'hab' | 'a' | ' dü' | 'nya' → 5 token
İngilizcede iki kelime iki token. Türkçede ise “Merhaba” üç, “dünya” iki parçaya bölünmüş. Kelimelerin önündeki boşluk da token’ın bir parçası (' world', ' dü').
Aynı anlamdaki iki cümle daha:
| Cümle | Karakter | Token |
|---|---|---|
| The weather is very nice today. | 31 | 7 |
| Bugün hava çok güzel. | 21 | 8 |
| How does AI read text? | 22 | 6 |
| Yapay zekâ metni nasıl okur? | 28 | 13 |
Türkçe cümle daha kısa olmasına rağmen daha fazla token tutuyor. Bu örneklerde İngilizcede bir token ortalama 4 civarı karaktere denk gelirken, Türkçede 2 ile 2,5 karakter arasında kalıyor.
Neden Türkçe daha fazla token tutuyor?
Tokenizer’lar eğitildikleri metinlerde sık geçen parçaları tek bir token olarak öğreniyor. Eğitim verisinin büyük kısmı İngilizce olduğu için “weather”, “today” gibi kelimeler tek parça halinde sözlükte yer alıyor. Türkçe kelimeler ise daha nadir görüldüğü için parçalara bölünüyor.
Buna Türkçenin eklemeli yapısı da ekleniyor. Bir köke ekler eklendikçe ortaya çok sayıda farklı kelime çıkıyor ve bunların her birinin sözlükte hazır olması mümkün değil. En uç örnek:
"Çekoslovakyalılaştıramadıklarımızdanmışsınız"→ Ç | ek | os | lovak | yal | ı | la | şt | ı | ram | ad | ıkl | ar | ım | ız | dan | m | ış | s | ını | z→ 21 token
Tek bir kelime 21 token. Tokenizer’ın böldüğü yerlerin Türkçe eklerle her zaman örtüşmediğine de dikkat et: “şt”, “ram”, “m” gibi parçalar dilbilgisi açısından bir anlam taşımıyor. Tokenizer dili anlamaya çalışmıyor, sadece sık gördüğü parçaları kullanıyor.
Not: Her model ailesinin kendi tokenizer’ı var ve daha yeni tokenizer’lar çok dilli metinlerde genellikle daha verimli. Aynı cümle başka bir modelde farklı sayıda token tutabilir; ama genel eğilim, yani Türkçenin İngilizceden daha fazla token tutması, çoğu modelde görülüyor.
Token neden önemli?
- Bağlam penceresi: Bir modelin aynı anda “aklında tutabildiği” metin miktarı token cinsinden ölçülüyor. Uzun bir PDF’i ya da uzun bir sohbeti modele verirken sınırı belirleyen şey karakter sayısı değil, token sayısı.
- Maliyet: API üzerinden kullanılan modeller genellikle token başına ücretlendiriliyor; hem gönderdiğin hem de modelin ürettiği token’lar sayılıyor. Aynı içerik Türkçe daha fazla token tutuyorsa, Türkçe işlem aynı modelde daha pahalıya gelebiliyor.
- Hız: Modeller cevabı token token üretiyor. Ekranda kelimelerin parça parça belirmesinin sebebi bu.
- Garip hatalar: Modelin bir kelimedeki harfleri saymakta zorlanması gibi tuhaf hataların bir kısmı buradan geliyor. Model kelimeyi harf harf değil, parça parça görüyor.
Kendin dene
Colab’da şu kodla istediğin metnin kaç token tuttuğunu ve nasıl bölündüğünü görebilirsin:
!pip install -q tiktokenimport tiktokenenc = tiktoken.get_encoding("cl100k_base")metin = "Bugün hava çok güzel."kodlar = enc.encode(metin)print(len(kodlar), "token")print(kodlar) # modelin gördüğü sayılarprint([enc.decode([k]) for k in kodlar]) # her sayının karşılığı olan parça
8 token[47873, 16461, 305, 2979, 58112, 55008, 28493, 13]['Bug', 'ün', ' h', 'ava', ' çok', ' gü', 'zel', '.']
İkinci satırdaki sayılar modelin gerçekten “okuduğu” şey. Kendi adını, bir şehir adını ya da uzun bir Türkçe kelimeyi deneyip kaç parçaya bölündüğüne bak.
Bir cümlede
Token, dil modelinin metni okuduğu parça; bağlam sınırı, maliyet ve hız hep token’la ölçülüyor ve Türkçe aynı anlamı genellikle İngilizceden daha fazla token’la ifade ediyor.
Bir yanıt yazın