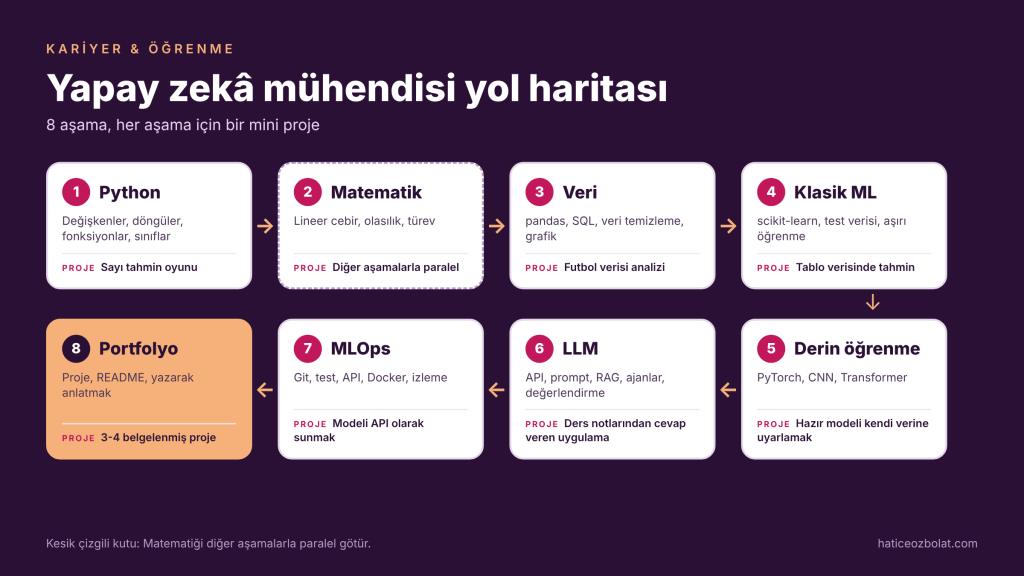
“Yapay zekâ mühendisi olmak istiyorum, nereden başlamalıyım?” sorusunun internette binlerce cevabı var ve çoğu ya çok genel ya da yüzlerce kaynaktan oluşan, bakmaya bile üşendiren listeler. Bu yazıda yolu sekiz aşamaya böldüm. Her aşamada ne öğrenmen gerektiğini, neden gerektiğini ve o aşamayı bitirdiğini gösterecek küçük bir projeyi yazdım.
Bu blogda yayımlanan derslerin çoğu da bu yolun bir parçası; her aşamada ilgili yazıları işaret ettim.
Önce: Yapay zekâ mühendisi ne yapar?
Bu unvan farklı şirketlerde farklı işler için kullanılıyor. Genel olarak üç yakın rol var:
| Rol | Odak | Tipik bir gün |
|---|---|---|
| Veri bilimci | Veriden soru sorup cevap bulmak | Analiz, deney, rapor, model denemeleri |
| Makine öğrenmesi mühendisi | Modelleri eğitip ürüne taşımak | Eğitim hattı kurmak, modeli canlıya almak, izlemek |
| Yapay zekâ mühendisi | Hazır büyük modellerle ürün geliştirmek | Büyük dil modelleri, RAG, ajanlar, değerlendirme |
Sınırlar bulanık ve birçok ilan bu rollerin karışımını istiyor. Bu yüzden aşağıdaki yol haritası üçünün ortak temelini kuruyor; son aşamalarda hangisine ağırlık vereceğini sen seçiyorsun.
1. Aşama: Programlama, yani Python
Neden: Yapay zekâ dünyasının ortak dili Python. Kütüphanelerin, örneklerin, makalelerin kodlarının büyük çoğunluğu Python’la yazılıyor.
Öğren: Değişkenler, koşullar, döngüler, fonksiyonlar, listeler ve sözlükler, hata yönetimi, dosya okuma, sınıflar ve nesneler.
Bitirdiğini nasıl anlarsın: Küçük bir programı baştan sona kendin yazabiliyorsan. Örneğin bir sayı tahmin oyunu ya da bir yapılacaklar listesi uygulaması.
Blogdaki Python dersleri bu aşamayı baştan sona kapsıyor.
2. Aşama: Matematik temeli
Neden: Modelleri kullanmak için matematik uzmanı olman gerekmiyor. Ama bir modelin neden çalışmadığını anlamak için temel kavramları bilmen gerekiyor.
Öğren:
- Lineer cebir: Vektör, matris, matris çarpımı. Bir sinir ağı aslında üst üste matris çarpımlarından oluşuyor.
- Olasılık ve istatistik: Ortalama, dağılım, olasılık, hipotez testi. Bir modelin sonucuna ne kadar güveneceğini bunlar söylüyor.
- Türev ve gradyan: Modeller hatalarını “gradyan inişi” denen bir yöntemle azaltıyor; türev bunun temeli.
İpucu: Matematiği ayrı bir dönem gibi çalışmak yerine diğer aşamalarla paralel götür. Bir kavrama ihtiyacın olduğunda dönüp öğrenmek çoğu kişi için daha kalıcı.
3. Aşama: Veriyle çalışmak
Neden: Her yapay zekâ projesi veriyle başlıyor ve zamanın büyük kısmı veriyi hazırlamaya gidiyor.
Öğren: pandas ile tablo verisi, NumPy, matplotlib ile grafik, SQL ile veritabanı sorgulama, veri temizleme.
Mini proje: Açık bir veri setini indir, temizle, birkaç soru sor ve sonuçları grafiklerle anlat. Blogdaki Futbol Veri Projesi tam olarak bu aşamaya bir örnek.
4. Aşama: Klasik makine öğrenmesi
Neden: Derin öğrenmeye geçmeden önce makine öğrenmesinin temel fikirlerini oturtman gerekiyor: eğitim ve test verisi, aşırı öğrenme, değerlendirme ölçütleri. Bu fikirler en büyük modellerde bile aynı.
Öğren: scikit-learn ile sınıflandırma ve regresyon; karar ağaçları, rastgele orman, lojistik regresyon; doğruluk, kesinlik, duyarlılık; çapraz doğrulama.
Mini proje: Bir tablo veri setinde bir şey tahmin eden bir model kur, sonucunu dürüstçe değerlendir. Seçmen Şapkası yazısındaki karar ağacı ve Makine Öğrenmesi ile Derin Öğrenme farkı yazısı bu aşamaya giriş niteliğinde.
5. Aşama: Derin öğrenme
Neden: Görüntü, ses ve metin gibi verilerde günümüzün en güçlü modelleri derin öğrenmeye dayanıyor.
Öğren: Sinir ağlarının nasıl öğrendiği, PyTorch ile model kurmak, evrişimli sinir ağları (CNN), Transformer mimarisi ve dikkat (attention) mekanizması.
Mini proje: Hazır eğitilmiş bir modeli kendi küçük veri setine uyarla (fine-tuning). Örneğin kendi çektiğin fotoğraflarda iki şeyi ayırt eden bir model.
Blogdaki Attention yazısı, Transformer’ın arkasındaki fikri anlatıyor.
6. Aşama: Büyük dil modelleri ve üretken yapay zekâ
Neden: Bugün “yapay zekâ mühendisi” ilanlarının çoğu bu alanla ilgili: hazır bir büyük dil modelini bir ürünün içine güvenli ve faydalı bir şekilde yerleştirmek.
Öğren:
- Bir modeli API üzerinden kullanmak ve iyi prompt yazmak
- Token, bağlam penceresi ve maliyet
- Embedding’ler ve vektör veritabanları
- RAG: Modelin kendi belgelerinden cevap vermesini sağlamak
- Araç kullanan ajanlar
- Değerlendirme: Modelin cevaplarının doğru ve güvenli olduğunu nasıl ölçeceğin. Bu alanın en çok ihmal edilen ama en çok aranan becerisi.
Mini proje: Bir dersin notlarını yükleyip onlara dayanarak soru cevaplayan küçük bir RAG uygulaması. Cevapların doğruluğunu ölçmek için kendi 20 soruluk test setini hazırla.
Blogdaki LLM Nedir? ve İyi Bir Prompt Nasıl Yazılır? yazıları bu aşamaya giriş.
7. Aşama: Yazılım mühendisliği ve modeli canlıya almak
Neden: Not defterinde çalışan bir model ile gerçek kullanıcıların kullandığı bir ürün arasında büyük bir fark var. İşe alımlarda bu farkı kapatabilen kişiler öne çıkıyor.
Öğren: Git ve GitHub, test yazmak, bir modeli API olarak sunmak (örneğin FastAPI ile), Docker, bir bulut platformunun temelleri, canlıdaki modeli izlemek (MLOps).
Mini proje: 4. ya da 6. aşamadaki projeni basit bir web arayüzü ya da API ile başkalarının kullanabileceği hale getir.
8. Aşama: Portfolyo ve sürekli öğrenme
Neden: Bu alanda işe alımı diplomadan çok, ne yaptığını gösterebilmen belirliyor.
Yap:
- 3-4 iyi belgelenmiş proje. Kaç proje yaptığından çok, her birinde hangi problemi çözdüğünü, neyi denediğini ve neyin işe yaramadığını anlatman önemli.
- Projelerini yazarak anlat: GitHub README’si, blog yazısı ya da LinkedIn gönderisi.
- Alan çok hızlı değişiyor. Haftada birkaç saatini yeni gelişmeleri takip etmeye ayır.
Ücretsiz başlangıç kaynakları
- Kaggle Learn: Python, pandas ve makine öğrenmesine kısa ve uygulamalı giriş kursları.
- Andrew Ng’in makine öğrenmesi ve derin öğrenme kursları: Kavramları sade anlatmasıyla bilinen, alanın en yaygın giriş kurslarından.
- fast.ai: Derin öğrenmeye “önce yap, sonra teoriye in” yaklaşımıyla giren ücretsiz kurs.
- Hugging Face kursları: Transformer modelleri ve büyük dil modelleriyle uygulamalı çalışmak için.
Kaynakların çoğu İngilizce. Bu alanda ilerlemek istiyorsan teknik İngilizceni geliştirmek de yol haritasının gizli dokuzuncu aşaması.
Sık sorulan sorular
Bilgisayar mühendisliği okumak şart mı? Hayır. Matematik, istatistik, endüstri mühendisliği ya da tamamen farklı bir alandan gelip bu alana geçen çok kişi var. Ama programlama ve matematik temelini bir şekilde edinmen gerekiyor.
Ne kadar sürer? Bu, haftada kaç saat ayırabildiğine ve nereden başladığına bağlı. Kimseyle kıyaslamadan, her aşamayı bir proje bitirerek kapatmak süreden daha önemli.
Önce büyük dil modellerine mi başlasam? Hazır bir modeli API ile kullanmak için ilk üç aşama yeterli olabilir ve motivasyon için iyi bir başlangıç. Ama bir şeyler ters gittiğinde nedenini anlamak için 4. ve 5. aşamalara mutlaka dönmen gerekecek.