Yazar: Hatice Özbolat

  • Git ve GitHub Nedir? Yeni Başlayanlar İçin

    Git ve GitHub Nedir? Yeni Başlayanlar İçin

    Bilgisayarında şöyle bir klasör oldu mu hiç: odev.docx, odev_son.docx, odev_son_duzeltilmis.docx, odev_GERCEKTEN_son.docx? Hangisinin en güncel olduğunu, dünkü sürümde neyi sildiğini hatırlamak imkânsız hâle gelir.

    Yazılımcılar bu sorunu yıllar önce çözdü. Çözümün adı Git. Bu yazıda Git’in ne olduğunu, GitHub’dan farkını ve neden yazılıma yeni başlayan herkesin onu erkenden öğrenmesi gerektiğini bir örnekle anlatıyorum.

    Git: kodun için kayıt noktaları

    Bir video oyununda kayıt noktası (save point) düşün. Zor bir bölüme girmeden önce kaydedersin; işler kötü giderse oraya dönersin.

    Git, dosyaların için tam olarak bunu yapıyor. Projende bir değişiklik yaptığında bir kayıt noktası oluşturuyorsun. Git her kayıt noktasında neyin, ne zaman ve kim tarafından değiştiğini saklıyor. İstediğin zaman eski bir hâle dönebilir ya da iki sürüm arasındaki farkı görebilirsin. Buna sürüm kontrolü (version control) deniyor.

    Git’i 2005’te Linus Torvalds yazdı. Amaç, binlerce kişinin aynı anda üzerinde çalıştığı Linux çekirdeğinin geliştirilmesini yönetmekti. Bugün dünyadaki yazılım projelerinin çok büyük kısmı Git kullanıyor.

    En önemli nokta: Git senin bilgisayarında çalışan bir program. İnternet olmadan da kullanabilirsin.

    GitHub: Git depolarının buluştuğu site

    GitHub ise Git ile tutulan projeleri internette saklayan ve paylaşmayı sağlayan bir web sitesi. 2008’de kuruldu, 2018’de Microsoft tarafından satın alındı.

    Aradaki farkı aklında tutmanın kolay yolu:

    GitGitHub
    Ne?Sürüm kontrol programıGit projelerini barındıran web sitesi
    Nerede çalışır?Senin bilgisayarındaİnternette
    İnternet gerekir mi?HayırEvet
    BenzetmeFotoğraf makinesiFotoğrafları paylaştığın albüm sitesi

    GitHub tek seçenek de değil; GitLab ve Bitbucket gibi benzer siteler de var. Ama en yaygın olanı GitHub.

    Bir örnekle: alışveriş listesi

    Komutları gerçekten çalıştırarak görelim. Bir klasör açıp onu Git deposuna (repository) çeviriyoruz:

    $ git init
    Initialized empty Git repository in .../proje/.git/

    Klasöre liste.txt adlı bir dosya ekledik (içinde “Alışveriş listesi” ve “- süt” yazıyor). Git ne düşünüyor, soralım:

    $ git status
    On branch main
    No commits yet
    Untracked files:
    (use "git add <file>..." to include in what will be committed)
    liste.txt

    Git dosyayı görüyor ama henüz takip etmiyor (untracked). İki adımda kayıt noktası oluşturuyoruz:

    $ git add liste.txt
    $ git commit -m "İlk liste"
    [main (root-commit) a32b283] İlk liste
    1 file changed, 2 insertions(+)
    create mode 100644 liste.txt
    • git add: “Bu dosyayı bir sonraki kayıt noktasına dahil et.”
    • git commit: “Kayıt noktasını oluştur.” -m ile yanına kısa bir açıklama yazıyoruz.

    Bu kayıt noktasına commit deniyor. a32b283 ise commit’in kimliği; her commit’in kendine özgü bir kodu var. Sen aynı komutları çalıştırınca bu kod farklı çıkacak, çünkü içinde tarih ve yazar bilgisi de var.

    Şimdi listeye ekmek ekleyelim ve Git’e neyin değiştiğini soralım:

    $ git diff
    Alışveriş listesi
    - süt
    +- ekmek

    (Çıktının başındaki birkaç teknik satırı kısalttım.) Başında + olan satır yeni eklenen satır. Silinen bir satır olsaydı başında - görürdük. Bunu da kaydedelim ve geçmişe bakalım:

    $ git add liste.txt
    $ git commit -m "Ekmek eklendi"
    $ git log --oneline
    e66ce47 Ekmek eklendi
    a32b283 İlk liste

    Artık listenin iki sürümü de güvende. odev_son_son.docx dönemi bitti: Tek bir dosya var, tüm geçmişi Git’te.

    Küçük bir Git sözlüğü

    TerimAnlamı
    Depo (repository, repo)Git’in takip ettiği proje klasörü
    CommitBir kayıt noktası
    Branch (dal)Ana projeyi bozmadan denemeler yaptığın paralel bir çalışma kolu
    PushBilgisayarındaki commit’leri GitHub’a göndermek
    PullGitHub’daki yeni commit’leri bilgisayarına almak
    CloneGitHub’daki bir projenin kopyasını bilgisayarına indirmek

    Neden şimdiden öğrenmelisin?

    • Hata yapmaktan korkmazsın. Bir şeyi bozarsan son çalışan sürüme dönebilirsin.
    • Ekip çalışmasının dili bu. İşe girdiğinde ilk günlerde karşına çıkacak araçlardan biri neredeyse kesin Git olacak.
    • GitHub senin vitrinin. Yaptığın projeleri GitHub’a koyarsan, iş başvurusunda “Python biliyorum” demek yerine kodunu gösterebilirsin.

    Bu blogdaki tüm Python dersleri de GitHub’da duruyor. Derslerdeki “Colab’da aç” düğmesi, not defterini doğrudan GitHub’daki depodan açıyor: python-dersleri

    Devamını oku: Yapay Zekâ Mühendisi Olmak İçin Yol Haritası

    Nereden başlamalı?

    1. GitHub’da ücretsiz bir hesap aç.
    2. Bilgisayarına Git’i kur (git-scm.com). Mac ve Linux’ta çoğu zaman zaten yüklü geliyor.
    3. Bu yazıdaki alışveriş listesi örneğini kendin yap: init, add, commit, log.
    4. İlk projeni GitHub’a yükle. Python derslerinde yazdığın sayı tahmin oyunu iyi bir aday.

    BTK akademideki Atıl Samancıoğl’un Versiyon Kontrolleri: Git ve GitHub dersi güzel bir kaynak.

    Devamını oku: Futbol Veri Projesi 1: Maç Verisini Toplamak ve Temizlemek
  • Monopoly’de En Değerli Kareler: Monte Carlo Simülasyonu

    Monopoly’de En Değerli Kareler: Monte Carlo Simülasyonu

    Monopoly oynarken herkesin bir teorisi vardır: “Laciverti al, oyun biter.” “Demiryolları sağlam para.” “Kahverengi sadece başlangıç için.” Peki bu teoriler ne kadar doğru?

    Bir arsanın değerli olması için önce oyuncuların ona basması gerekiyor. Bu yazıda tek bir soruya cevap arıyoruz: Monopoly tahtasında en çok hangi karelere basılıyor? Cevabı formülle değil, oyunu bilgisayara bir milyon tur oynatarak bulacağız.

    Tüm kodlar Colab’da, tek tıkla açılıyor: Colab’da aç

    Monte Carlo nedir?

    Bir şeyin ihtimalini hesaplamak zorsa, onu çok kez rastgele deneyip sonuçları sayabilirsin. Buna Monte Carlo simülasyonu deniyor. Adını Monaco’daki ünlü kumarhane semtinden alıyor; rastgelelik ve şans üzerine kurulu bir yöntem için yerinde bir isim.

    Önce cevabını bildiğimiz bir soruyla deneyelim: İki zar atınca toplamın 7 gelme ihtimali kaç? Matematikle cevap 6/36, yani yaklaşık yüzde 16,67.

    import random
    from collections import Counter
    def zar_toplami_dene(atis_sayisi, tohum=1):
    rnd = random.Random(tohum)
    sayac = Counter(rnd.randint(1, 6) + rnd.randint(1, 6) for _ in range(atis_sayisi))
    return sayac[7] / atis_sayisi * 100
    for n in [100, 10_000, 1_000_000]:
    print(f"{n:>9,} atış -> 7 gelme oranı: %{zar_toplami_dene(n):.2f}")
          100 atış -> 7 gelme oranı: %20.00
       10,000 atış -> 7 gelme oranı: %16.75
    1,000,000 atış -> 7 gelme oranı: %16.65

    100 atışta sonuç %20 çıkıyor, epey sapmış. Bir milyon atışta gerçek değere neredeyse yapışıyor. Monte Carlo’nun bütün fikri bu: Yeterince çok denersen rastgelelik dengelenir.

    Monopoly’de kartlar, hapis ve çift zar kuralları yüzünden formül çok karışık. Ama simülasyonun mantığı aynı kalıyor.

    Tahtayı ve kuralları koda dökmek

    Tahtada 40 kare var. Klasik ABD tahtasının kare adlarını bir listeye yazıyoruz; listenin sırası tahtadaki sıra. Simülasyona koyduğumuz kurallar:

    • İki zar atılır, toplam kadar ilerlenir.
    • Çift atan bir daha atar; üst üste üçüncü çift hapse gönderir.
    • Hapse Gir karesine gelen hapse gider.
    • 16 Şans kartından 10’u oyuncuyu bir yere gönderir: Başlangıç, Illinois Ave, St. Charles Place, Reading Demiryolu, Boardwalk, hapis, en yakın şirket, iki kez en yakın demiryolu ve 3 kare geri.
    • 16 Kamu Fonu kartından 2’si oyuncuyu gönderir: Başlangıç ve hapis.
    • Kartlar karıştırılır, çekilen kart destenin altına gider.

    Kartları birer metin listesi olarak tutuyoruz. Bir kart çekmek, listenin başındaki elemanı alıp sona koymak demek:

    k = sans.pop(0)
    sans.append(k)
    konum = sans_karti(k, konum)

    Simülasyonun kalbi olan simule() fonksiyonu yaklaşık 30 satır. Her turda zar atıyor, kuralları uyguluyor ve piyonun durduğu kareyi bir Counter‘a yazıyor. Kodun tamamı not defterinde; burada sonuçlara bakalım.

    Bir milyon tur sonra

    Eşit ihtimal olsaydı her kareye yüzde 2,5 düşerdi. Ama tahta hiç de eşit değil. Hapisten hemen çıkan bir oyuncu için en çok basılan 10 kare:

    SıraKareBasılma oranı
    1Hapis%6,15
    2Illinois Ave%3,19
    3Başlangıç%3,09
    4New York Ave%3,06
    5B&O Demiryolu%3,06
    6Reading Demiryolu%2,97
    7Pennsylvania Demiryolu%2,93
    8Tennessee Ave%2,92
    9Ücretsiz Otopark%2,91
    10Su İdaresi%2,83

    Bu tablodan üç şey çıkıyor:

    • Hapis açık ara birinci. Oraya giden üç yol var: Hapse Gir karesi, Şans ve Kamu Fonu kartları, üst üste üç çift. Başka hiçbir kare bu kadar “trafik” almıyor.
    • Illinois Ave en çok basılan arsa. Şans destesindeki kartlardan biri doğrudan oraya gönderiyor.
    • Demiryolları listede üç kez var. İki Şans kartı “en yakın demiryoluna git” diyor.

    Listenin en altında ise Şans kareleri var: Buraya gelen oyuncuların çoğu çektiği kartla başka yere gidiyor. Hapse Gir karesinin oranı ise sıfır, çünkü oraya gelen piyon anında hapse taşınıyor.

    Renk grupları: hangisi önde?

    Monopoly’de asıl para, bir renk grubunun tamamını alıp ev kurmaktan geliyor. Grupların kare sayısı farklı (2 ya da 3), o yüzden adil karşılaştırma için arsa başına oranı hesaplıyoruz:

    GRUPLAR = {
    "Kahverengi": [1, 3], "Açık mavi": [6, 8, 9], "Pembe": [11, 13, 14], "Turuncu": [16, 18, 19],
    "Kırmızı": [21, 23, 24], "Sarı": [26, 27, 29], "Yeşil": [31, 32, 34], "Lacivert": [37, 39],
    }
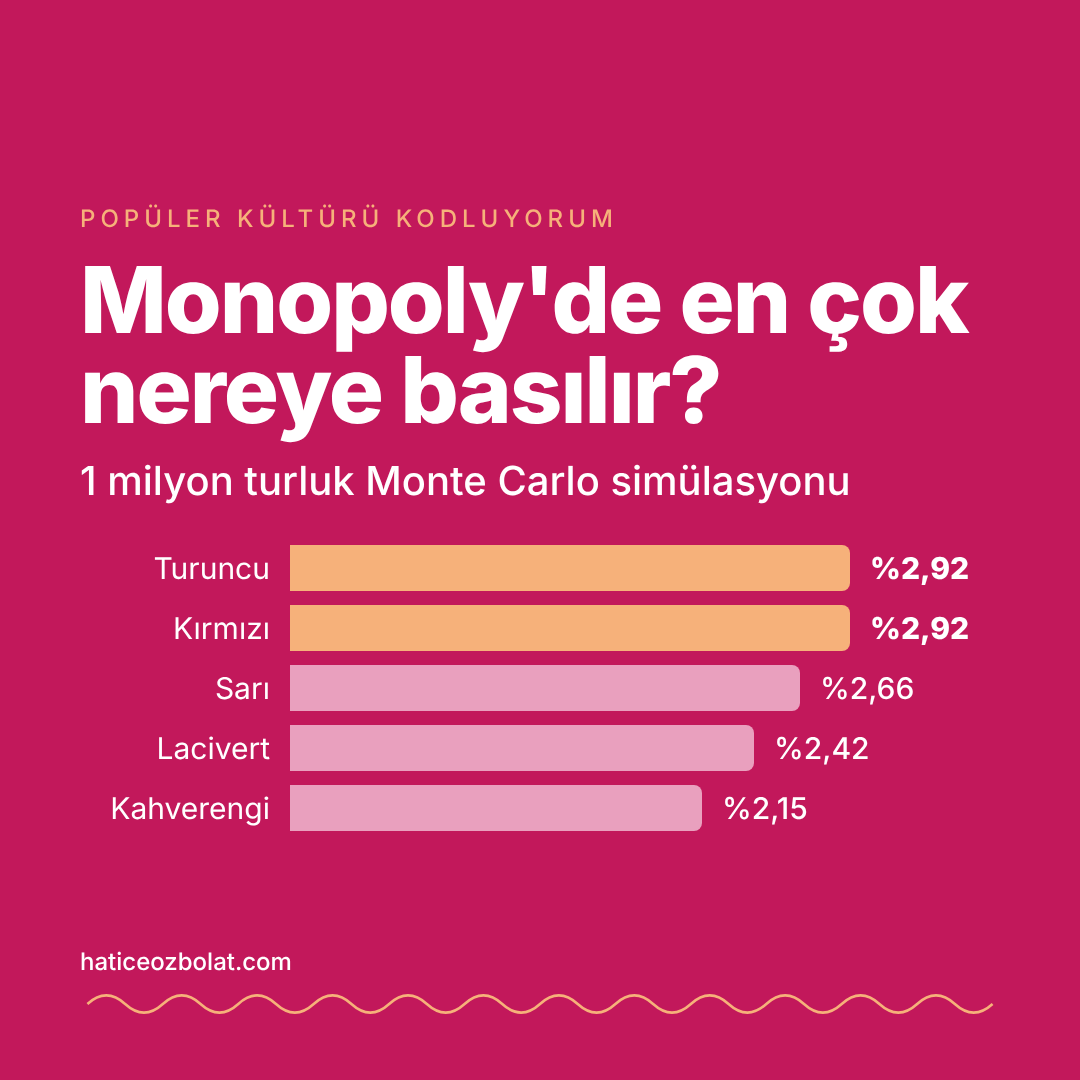
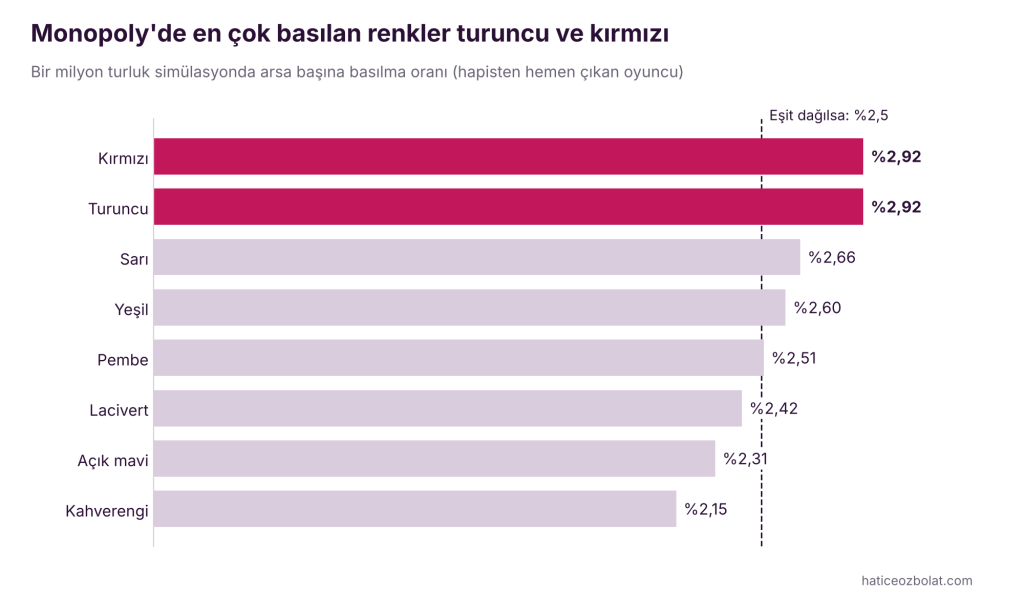
    Monopoly renk gruplarında arsa başına basılma oranı. Turuncu ve kırmızı %2,92 ile başta; sonra sarı %2,66, yeşil %2,60, pembe %2,51, lacivert %2,42, açık mavi %2,31 ve kahverengi %2,15. Eşit dağılımda oran %2,5 olurdu.

    Turuncu ve kırmızı başa baş önde, kahverengi en geride. Asıl sürpriz lacivert: Oyunun en pahalı grubu, ama arsa başına basılma oranı ortalamanın altında. Boardwalk’ı bir Şans kartı kurtarıyor; Park Place ise kendi başına kalıyor.

    Turuncunun sırrı: hapisten çıkış

    Hapis tahtada 10. kare ve oyuncular oraya çok sık gidiyor. Hapisten çıkan oyuncu iki zar atıyor. Turuncu kareler hapisten tam 6, 8 ve 9 kare ileride.

    İki zarda hangi toplamın kaç farklı yolla gelebildiğine bakalım:

     2: █  1/36
     3: ██  2/36
     4: ███  3/36
     5: ████  4/36
     6: █████  5/36
     7: ██████  6/36
     8: █████  5/36
     9: ████  4/36
    10: ███  3/36
    11: ██  2/36
    12: █  1/36

    6, 8 ve 9 toplamları en sık gelenlerden. Toplarsak: (5 + 5 + 4) / 36, yani hapisten çıkan bir oyuncunun tek atışta turuncu bir kareye basma ihtimali yüzde 38,9. Hapis ne kadar kalabalıksa turuncu o kadar kazanıyor.

    Kırmızının arkasındaki güç ise Şans destesi: Illinois Ave kartı.

    Hapiste beklersen ne değişir?

    Oyunun sonlarına doğru oyuncular genelde hapiste kalmayı tercih eder. Tahta evlerle dolmuştur ve dolaşmak pahalıdır; hapiste otururken kira ödemezsin ama kira toplamaya devam edersin. Aynı simülasyonu “çift atana kadar bekle” stratejisiyle çalıştırdığımızda:

    • Hapis karesinin payı yüzde 6,15’ten yüzde 11,50’ye çıkıyor.
    • Turuncu arsa başına yüzde 2,77 ile kırmızının (yüzde 2,73) önüne geçiyor.

    Yani oyun ilerledikçe turuncunun avantajı büyüyor. “Turuncuyu al” tavsiyesinin arkasındaki matematik bu.

    Sınırlar

    Bu simülasyon sadece basılma ihtimalini ölçüyor. Bir grubun gerçekten ne kadar kârlı olduğu arsanın fiyatına, ev maliyetine ve kiraya da bağlı; bunları modele katmadık. Kuralların da klasik sürümünü kullandık, evdeki özel kurallar (Ücretsiz Otopark’ta para toplamak gibi) sonucu değiştirmiyor ama farklı bir tahta sürümü değiştirebilir.

    Yine de basılmayan bir arsadan kira alamazsın. O yüzden bu tablo iyi bir başlangıç noktası.

    Devamını oku: Netflix’te Ne İzlesem? Basit Bir Öneri Sistemi Yazmak

    Kendin dene

    1. TUR değerini 1.000’e indir. Sonuçlar ne kadar oynuyor? Kaç turdan sonra sıralama oturuyor?
    2. Şans destesinden Illinois kartını çıkar. Illinois Ave hâlâ en çok basılan arsa mı?
    3. Demiryollarını bir grup olarak ekle ([5, 15, 25, 35]). Arsa başına oranları nasıl?
    4. Hapiste en fazla bir tur beklenebilsin. Turuncunun avantajına ne oluyor?

    Devamını oku: Futbol Veri Projesi 1: Maç Verisini Toplamak ve Temizlemek
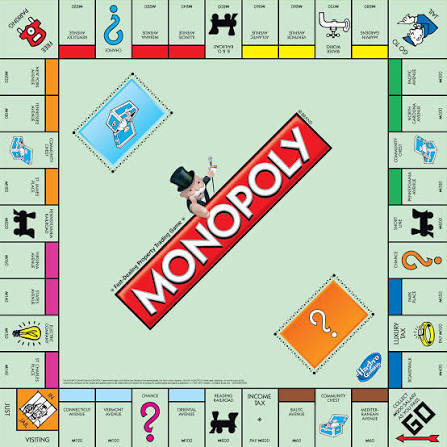
    Monopoly, Hasbro’nun tescilli markasıdır. Bu yazı oyunla resmî bir bağlantı taşımıyor; kare adları klasik ABD tahtasından, görseller kendi grafiklerimiz.

  • Dosya Okuma ve Yazma (Python Dersi 14)

    Dosya Okuma ve Yazma (Python Dersi 14)

    Şimdiye kadar yazdığımız her programda bir sorun vardı: Program kapanınca her şey unutuluyordu. Sayı tahmin oyununda en iyi skorunu, alışveriş listende yazdığın ürünleri, hesapladığın notları… Hepsi değişkenlerde duruyordu ve değişkenler program bitince kaybolur.

    Bir şeyi kalıcı olarak saklamanın en basit yolu onu bir dosyaya yazmak. Bu derste dosya açmayı, yazmayı, okumayı ve veri analizinde en sık göreceğin CSV dosyalarını öğreniyoruz. Sonunda da kapatıp açınca bile unutmayan bir alışveriş listesi yazıyoruz.

    Tüm kodlar Colab’da, tek tıkla açılıyor: Colab’da aç

    Colab’da oluşturduğun dosyaları sol taraftaki klasör simgesine tıklayarak görebilirsin. Ama dikkat: Colab oturumu kapanınca bu dosyalar da silinir. Kalıcı saklamak istediğin bir dosyayı bilgisayarına indirmen gerekir.

    İlk dosyamızı yazalım

    open() fonksiyonu bir dosyayı açar. Ona iki şey söylüyoruz: dosyanın adı ve ne yapacağımız.

    dosya = open("notlar.txt", "w", encoding="utf-8")
    dosya.write("Bugün dosyalara giriş yaptım.\n")
    dosya.write("Şimdi ne öğrendiğimi okuyacağım.\n")
    dosya.close()
    print("Dosya yazıldı.")

    Satır satır ne oluyor:

    • "w": yazmak için aç (write). Dosya yoksa oluşturulur.
    • encoding="utf-8": ç, ğ, ı, ö, ş, ü gibi Türkçe karakterlerin doğru kaydedilmesi için. Bunu her dosya işleminde yazmayı alışkanlık hâline getir.
    • \n: satır sonu. Yazmazsan iki cümle aynı satıra yapışır.
    • close(): dosyayı kapat. Unutursan yazdıkların dosyaya tam kaydedilmeyebilir.

    with: kapatmayı Python’a bırak

    close() yazmayı unutmak çok kolay. with bloğu bu yükten kurtarıyor: Blok bitince dosya kendiliğinden kapanır. Bundan sonra hep bu yolu kullanacağız.

    with open("notlar.txt", "r", encoding="utf-8") as dosya:
    icerik = dosya.read()
    print(icerik)
    Bugün dosyalara giriş yaptım.
    Şimdi ne öğrendiğimi okuyacağım.

    "r" okumak (read) demek. read() dosyanın tamamını tek bir metin olarak getirir.

    Üç temel mod: r, w, a

    ModAnlamıDosya yoksaDosya varsa
    "r"okuhata verirbaştan okur
    "w"yazoluştururiçini siler, baştan yazar
    "a"ekleoluşturursonuna ekler

    En sık yapılan hata: Var olan bir dosyaya bir şey eklemek isterken "w" kullanmak. "w" dosyanın içini sorgusuz sualsiz siler. Eski içeriği korumak istiyorsan "a" (append) kullan:

    with open("notlar.txt", "a", encoding="utf-8") as dosya:
    dosya.write("Bu satır sonradan eklendi.\n")

    Satır satır okumak

    Dosyayı bir for döngüsüne verirsen her turda bir satır gelir:

    with open("notlar.txt", "r", encoding="utf-8") as dosya:
    for numara, satir in enumerate(dosya, start=1):
    print(numara, satir.strip())
    1 Bugün dosyalara giriş yaptım.
    2 Şimdi ne öğrendiğimi okuyacağım.
    3 Bu satır sonradan eklendi.

    Her satırın sonunda bir \n karışıyor. strip() onu atıyor; yoksa satırların arasında boş satırlar görürsün. enumerate ise satırları numaralandırmamızı sağlıyor.

    Tüm satırları bir listeye almak istersen:

    with open("notlar.txt", "r", encoding="utf-8") as dosya:
    satirlar = dosya.read().splitlines()
    print(len(satirlar)) # 3

    Sayıları yazmak: önce metne çevir

    write() sadece metin kabul eder. Bir sayıyı yazmadan önce str() ile metne çevirmen, okurken de int() ile geri sayıya çevirmen gerekir:

    puanlar = [85, 92, 78]
    with open("puanlar.txt", "w", encoding="utf-8") as dosya:
    for puan in puanlar:
    dosya.write(str(puan) + "\n")
    with open("puanlar.txt", "r", encoding="utf-8") as dosya:
    okunan = [int(satir) for satir in dosya]
    print(okunan) # [85, 92, 78]
    print(sum(okunan) / len(okunan)) # 85.0

    Okuma kısmındaki tek satırlık döngü, Ders 12’de öğrendiğimiz liste üreteci.

    Devamını oku: Kümeler ve Liste Üreteçleri (Python Dersi 12)

    Dosya yoksa ne olur?

    Olmayan bir dosyayı "r" ile açmaya çalışırsan Python FileNotFoundError verir ve program durur. Geçen derste öğrendiğimiz try ve except tam burada işe yarıyor:

    try:
    with open("olmayan_dosya.txt", "r", encoding="utf-8") as dosya:
    print(dosya.read())
    except FileNotFoundError:
    print("Böyle bir dosya yok. Önce oluşturman gerekiyor.")

    Devamını oku: Hata Yönetimi: try ve except (Python Dersi 13)

    CSV dosyaları

    Veri analizine geçtiğinde en sık göreceğin dosya türü CSV olacak. Her satır bir kayıt, değerler virgülle ayrılmış. Aslında düz bir metin dosyası, Excel’de de açılabiliyor. Python’un hazır csv modülü bu işi kolaylaştırıyor:

    import csv
    ogrenciler = [
    ["ad", "bolum", "not"],
    ["Ayşe", "Bilgisayar", 88],
    ["Mehmet", "Endüstri", 74],
    ["Zeynep", "Bilgisayar", 95],
    ]
    with open("ogrenciler.csv", "w", encoding="utf-8", newline="") as dosya:
    yazici = csv.writer(dosya)
    yazici.writerows(ogrenciler)

    newline="" bazı sistemlerde satırlar arasında fazladan boş satır oluşmasını engelliyor. CSV yazarken eklemeyi unutma.

    Okurken csv.DictReader her satırı bir sözlüğe çeviriyor, böylece sütunlara adıyla ulaşabiliyorsun:

    with open("ogrenciler.csv", "r", encoding="utf-8") as dosya:
    for satir in csv.DictReader(dosya):
    print(satir["ad"], "->", satir["not"])
    Ayşe -> 88
    Mehmet -> 74
    Zeynep -> 95

    Dikkat: CSV’den okunan her şey metin olarak gelir. satir["not"] bir sayı değil, "88" gibi bir metin. Hesap yapacaksan int() ile çevirmen gerekiyor.

    Gerçek bir veri projesinde CSV’leri genelde pandas kütüphanesiyle okuyoruz, ama arka planda olan şey tam olarak bu.

    Devamını oku: Futbol Veri Projesi 1: Maç Verisini Toplamak ve Temizlemek
    Mini proje: unutmayan alışveriş listesi

    Öğrendiklerimizi birleştirelim. Program her açıldığında listeyi dosyadan yüklesin, yeni ürün eklenince dosyaya kaydetsin:

    LISTE_DOSYASI = "alisveris.txt"
    def listeyi_yukle():
    try:
    with open(LISTE_DOSYASI, "r", encoding="utf-8") as dosya:
    return dosya.read().splitlines()
    except FileNotFoundError:
    return []
    def urun_ekle(urun):
    with open(LISTE_DOSYASI, "a", encoding="utf-8") as dosya:
    dosya.write(urun + "\n")
    def listeyi_goster():
    liste = listeyi_yukle()
    if not liste:
    print("Liste boş.")
    for sira, urun in enumerate(liste, start=1):
    print(f"{sira}. {urun}")
    listeyi_goster()
    urun_ekle("süt")
    urun_ekle("ekmek")
    urun_ekle("domates")
    print("---")
    listeyi_goster()
    Liste boş.
    ---
    1. süt
    2. ekmek
    3. domates

    Burada üç dersin bir araya geldiğini görüyorsun: fonksiyonlar (Ders 9), hata yönetimi (Ders 13) ve dosyalar. Dosya henüz yoksa listeyi_yukle() programı çökertmek yerine boş bir liste döndürüyor.

    Colab’da son hücreyi bir kez daha çalıştır: Ürünler iki kez eklenir. Çünkü liste artık programın içinde değil, dosyada duruyor. Programı kapatıp açsan da kaybolmuyor. Bu dersin bütün meselesi de bu.

    Alıştırmalar

    1. gunluk.txt adında bir dosya oluştur ve içine üç satır yaz. Sonra dosyayı okuyup kaç satır olduğunu ekrana yazdır.
    2. puanlar.txt dosyasına içini silmeden iki yeni puan ekle. Sonra en yüksek puanı bul.
    3. ogrenciler.csv dosyasını DictReader ile oku ve sadece Bilgisayar bölümündeki öğrencilerin not ortalamasını hesapla.
    4. Alışveriş listesine urun_sil(urun) fonksiyonu ekle. İpucu: Listeyi yükle, ürünü çıkar, kalanları "w" ile baştan yaz.

    Cevaplar not defterinin sonunda.

    Bu derste neler öğrendik?

    • open(dosya, mod, encoding="utf-8") bir dosyayı açar.
    • with bloğu dosyayı kendiliğinden kapatır.
    • "r" okur, "w" silip yazar, "a" sonuna ekler.
    • Dosyayı for ile gezersen satır satır okursun; strip() satır sonunu temizler.
    • write() sadece metin alır: Sayıları str() ile çevir.
    • Olmayan dosya FileNotFoundError verir; try ve except ile yakala.
    • CSV için csv.writer ve csv.DictReader kullan, okunan değerlerin metin olduğunu unutma.

    Sıradaki ders

    Bir sonraki derste Python’un gücünün asıl kaynağına geliyoruz: başkalarının yazdığı hazır kodları kullanmak. Bu derste import csv diyerek küçük bir tadımını aldık.

    Sıradaki ders: Modüller ve pip: Hazır Kütüphaneleri Kullanmak (Python Dersi 15)

  • Banka Kampanyası Verisi: Kim Vadeli Mevduat Açar?

    Banka Kampanyası Verisi: Kim Vadeli Mevduat Açar?

    Bir banka, müşterilerini telefonla arayıp vadeli mevduat hesabı açmalarını teklif ediyor. On kişiyi arasın, dokuzu “hayır” diyor. Peki kimi aramalı? Bu hafta sonu projesinde gerçek bir banka kampanyasının verisiyle bu soruya cevap arıyoruz.

    Yol boyunca veri biliminin üç klasik tuzağına da basacağız: gizli eksik değerler, yanıltıcı bir başarı ölçüsü ve modelin gelecekten haber alması.

    Tüm kodlar Google Colab’da çalışıyor. Colab tarayıcıda açılıyor ve kodu Google’ın sunucularında çalıştırıyor; bu projede kullandığımız pandas, scikit-learn ve matplotlib orada hazır geliyor. Yani bilgisayarına hiçbir şey kurman gerekmiyor, bir Google hesabı yeterli: Colab’da aç

    Veri seti

    Veri, bir Portekiz bankasının 2008-2010 yılları arasındaki telefonla pazarlama kampanyalarından geliyor ve UCI Machine Learning Repository’de CC BY 4.0 lisansıyla paylaşılıyor. Her satır anonim bir müşteriyle yapılan bir görüşme; isim ya da kimlik bilgisi yok.

    Sütunlar dört gruba ayrılıyor:

    • Müşteri: yaş, meslek, medeni durum, eğitim, kredi durumu
    • Bu kampanyadaki görüşme: ay, gün, iletişim türü, görüşme süresi, kaçıncı arama olduğu
    • Geçmiş: önceki kampanyada aranıp aranmadığı ve sonucu
    • Ekonomi: istihdam, enflasyon endeksi, faiz gibi o döneme ait göstergeler

    Hedef sütun y: müşteri vadeli mevduat açtı mı (yes), açmadı mı (no)?

    Veriyi indirmek

    UCI dosyayı iç içe iki zip olarak veriyor. Diske tek tek açmak yerine bellekte açıyoruz:

    import io
    import os
    import zipfile
    import numpy as np
    import pandas as pd
    import requests
    DOSYA = "bank-additional-full.csv"
    URL = "https://archive.ics.uci.edu/static/public/222/bank+marketing.zip"
    def veriyi_indir():
    dis = zipfile.ZipFile(io.BytesIO(requests.get(URL, timeout=60).content))
    ic_adi = [a for a in dis.namelist() if a.endswith("bank-additional.zip")][0]
    ic = zipfile.ZipFile(io.BytesIO(dis.read(ic_adi)))
    csv_adi = [a for a in ic.namelist() if a.endswith(DOSYA)][0]
    with open(DOSYA, "wb") as f:
    f.write(ic.read(csv_adi))
    if not os.path.exists(DOSYA):
    veriyi_indir()
    df = pd.read_csv(DOSYA, sep=";")
    print(df.shape)
    (41188, 21)

    sep=";" kısmına dikkat et. Bu dosyada ayırıcı virgül değil, noktalı virgül. Vermezsen pandas her satırı tek bir uzun sütun sanır.

    İlk bakış: on kişiden biri

    print("Tekrarlanan satır:", df.duplicated().sum())
    df = df.drop_duplicates().reset_index(drop=True)
    df["hedef"] = (df["y"] == "yes").astype(int)
    print(f"Vadeli mevduat açanların oranı: %{df['hedef'].mean() * 100:.1f}")
    Tekrarlanan satır: 12
    Vadeli mevduat açanların oranı: %11.3

    12 tekrar eden satırı sildikten sonra elimizde 41.176 görüşme kalıyor ve bunların yalnızca yüzde 11,3’ü “evet” ile bitmiş. Bir sınıfın diğerinden çok daha az olduğu bu duruma dengesiz sınıf deniyor. Aklında tut, birazdan canımızı sıkacak.

    Gizli eksikler: unknown ve 999

    df.isna().sum() bu veride her sütun için sıfır gösterir. Ama bu, eksik veri olmadığı anlamına gelmiyor. Eksikler iki kılıkta saklanıyor:

    • Kategorik sütunlarda "unknown" yazısı. En çok default sütununda (kredi borcunu ödememiş mi?): 8.596 satır, yani neredeyse her beş kişiden biri.
    • pdays sütununda 999 değeri. Müşterinin daha önce hiç aranmadığı anlamına geliyor ve satırların yüzde 96’sında bu değer var.

    Bu satırları silmiyoruz. “Bu soruya cevap vermemiş olmak” da bir bilgi; unknown kendi başına bir kategori olarak kalıyor. 999’u ise ortalamaya katılırsa sonucu saçma bir yere çekecek sıradan bir sayı gibi değil, “hiç” anlamında okuyoruz.

    Yeni bir veri setine başlarken isna() ile yetinme. Her kategorik sütunun value_counts() çıktısına bir kez göz at; eksikler genelde orada saklanır.

    Keşif: hangi grupta evet oranı yüksek?

    Aynı hesabı birçok sütun için yapacağımızdan küçük bir fonksiyon yazıyoruz:

    def oran_tablosu(sutun, sira=None):
    t = df.groupby(sutun, observed=True)["hedef"].agg(gorusme="size", evet_orani="mean")
    if sira is not None:
    t = t.reindex(sira)
    t["evet_orani"] = (t["evet_orani"] * 100).round(1)
    return t
    oran_tablosu("poutcome")
    Önceki kampanyanın sonucuGörüşmeEvet oranı
    Başarılı (evet demiş)1.373%65,1
    Başarısız4.252%14,2
    Daha önce aranmamış35.551%8,8

    Geçen sefer “evet” diyen müşterilerin üçte ikisi bu sefer de evet demiş. Tek bir sütun, ortalamanın neredeyse altı katı bir oran gösteriyor.

    Aynı fonksiyonla baktığımız diğer gruplardan öne çıkanlar:

    • İletişim türü: Cep telefonundan aranan müşterilerde oran %14,7, sabit hattan arananlarda %5,2.
    • Yaş: 66 yaş ve üstünde %46,9, 17-25 arasında %21,0. Aradaki yaş grupları %8-15 arasında kalıyor. Ama 66+ grubunda sadece 618 görüşme var.
    • Arama sayısı: İlk aramada oran %13,0; altı ve daha fazla aranmış kişilerde %5,5. Aynı müşteriyi ısrarla aramak işe yaramıyor gibi.

    Ay tablosu ve korelasyon tuzağı

    AYLAR = ["mar", "apr", "may", "jun", "jul", "aug", "sep", "oct", "nov", "dec"]
    oran_tablosu("month", AYLAR)

    Mart, eylül, ekim ve aralıkta evet oranı %44 ile %51 arasında. Mayıs’ta ise %6,4. “Demek ki martı beklemek lazım” demek çok cazip.

    Ama görüşme sayılarına bak: mayısta 13.767 görüşme var, aralıkta 182. Az aranan aylarda banka belki de zaten ilgili olduğunu bildiği müşterileri aradı. Bu tablo ayın sonucu değiştirdiğini göstermiyor; sadece ikisinin birlikte hareket ettiğini gösteriyor. Korelasyon, nedensellik değildir.

    duration tuzağı: veri sızıntısı

    duration, görüşmenin saniye cinsinden süresi:

    df.groupby("y")["duration"].median()
    y
    no 164.0
    yes 449.0

    Evet diyenlerle görüşme, ortanca değere göre neredeyse üç kat uzun sürmüş. Doğal: ikna olan müşteriyle hesap açmanın detaylarını konuşuyorsun. Bu sütun modele girerse sonucu çok iyi tahmin eder.

    Sorun şu: bankanın asıl sorusu “kimi arayalım?” ve bu soru arama yapılmadan önce soruluyor. O anda görüşmenin ne kadar süreceğini bilemezsin. Tahmin anında elinde olmayacak bir bilgiyi modele vermeye veri sızıntısı (data leakage) deniyor. Veri setinin kendi açıklaması da gerçekçi bir model için bu sütunun çıkarılmasını öneriyor. Biz de çıkarıyoruz.

    Model: lojistik regresyon

    from sklearn.compose import ColumnTransformer
    from sklearn.linear_model import LogisticRegression
    from sklearn.model_selection import train_test_split
    from sklearn.pipeline import Pipeline
    from sklearn.preprocessing import OneHotEncoder, StandardScaler
    CIKAR = ["y", "hedef", "duration", "yas_grubu", "arama_sayisi"]
    X = df.drop(columns=CIKAR)
    y = df["hedef"]
    X_egitim, X_test, y_egitim, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42)
    kategorik = X.select_dtypes(exclude="number").columns.tolist()
    sayisal = X.select_dtypes(include="number").columns.tolist()
    def model_kur(kategorik, sayisal):
    hazirlik = ColumnTransformer([
    ("kategorik", OneHotEncoder(handle_unknown="ignore"), kategorik),
    ("sayisal", StandardScaler(), sayisal),
    ])
    return Pipeline([
    ("hazirlik", hazirlik),
    ("model", LogisticRegression(max_iter=2000, class_weight="balanced")),
    ])
    model = model_kur(kategorik, sayisal)
    model.fit(X_egitim, y_egitim)
    olasilik = model.predict_proba(X_test)[:, 1]
    tahmin = (olasilik >= 0.5).astype(int)

    (yas_grubu ve arama_sayisi, keşif bölümünde tablolar için eklediğimiz yardımcı sütunlar; not defterinde oluşturuluyorlar.)

    Satır satır ne yaptık:

    • stratify=y: Eğitim ve test setinde evet oranı aynı kalsın. Dengesiz veride bunu unutursan test setine şans eseri çok az “evet” düşebilir.
    • OneHotEncoder: “meslek = öğrenci” gibi metin değerlerini 0-1 sütunlarına çevirir. Model sadece sayılarla çalışır.
    • StandardScaler: Yaş (17-98) ile faiz oranı (0-5) gibi farklı ölçekteki sayıları aynı ölçeğe getirir.
    • class_weight="balanced": Az olan “evet” sınıfındaki hataları daha ağır cezalandır. Bunu yazmazsan model, hemen herkese “hayır” demenin kolay yolunu seçer.
    • Pipeline: Hazırlık ve modeli tek bir nesnede toplar. Böylece test verisine eğitimde öğrenilen dönüşümün aynısı uygulanır.

    Accuracy neden yanıltır?

    Hiçbir şey öğrenmemiş, herkese “hayır” diyen bir model düşün:

    from sklearn.metrics import accuracy_score
    herkese_hayir = np.zeros(len(y_test), dtype=int)
    print(f"Herkese 'hayır' diyen model accuracy: %{accuracy_score(y_test, herkese_hayir) * 100:.1f}")
    print(f"Bizim modelin accuracy'si: %{accuracy_score(y_test, tahmin) * 100:.1f}")
    Herkese 'hayır' diyen model accuracy: %88.7
    Bizim modelin accuracy'si: %83.3

    Hiçbir şey öğrenmemiş model daha “başarılı” görünüyor. Oysa bankaya tek bir müşteri kazandırmaz. Dengesiz veride accuracy, çoğunluk sınıfını ne kadar iyi tahmin ettiğini ölçer; bizi ilgilendiren azınlık sınıfı ise kaybolur.

    Bu yüzden başka ölçülere bakıyoruz. Test setindeki 10.294 görüşmede bizim model:

    Sayı
    Doğru yakalanan “evet”742
    Kaçırılan “evet”418
    Boşa aranan (evet tahmin edildi, hayır dedi)1.300
    Doğru “hayır”7.834
    • Recall (duyarlılık): Gerçekten evet diyenlerin yüzde kaçını yakaladık? 742 / 1.160 = %64
    • Precision (kesinlik): Evet dediğimiz kişilerin yüzde kaçı gerçekten evet dedi? 742 / 2.042 = %36
    • ROC-AUC: Model, rastgele seçilmiş bir “evet”i rastgele seçilmiş bir “hayır”ın önüne ne sıklıkla koyuyor? 0,5 yazı tura, 1 kusursuz. Bizim model: 0,80

    Precision’ın %36 olması kötü gibi görünebilir. Ama rastgele arasan bu oran %11 olurdu; model aynı emekle üç kattan fazla müşteri buluyor.

    Asıl soru: kimi önce aramalı?

    Banka herkesi arayamaz. Modelin verdiği olasılığa göre müşterileri sıralayıp onluk dilimlere ayıralım. 1. dilim, modelin en umutlu bulduğu yüzde 10.

    sirali = pd.DataFrame({"gercek": y_test.to_numpy(), "olasilik": olasilik})
    sirali = sirali.sort_values("olasilik", ascending=False).reset_index(drop=True)
    sirali["dilim"] = sirali.index * 10 // len(sirali) + 1
    dilimler = sirali.groupby("dilim")["gercek"].agg(kisi="size", evet="sum", evet_orani="mean")
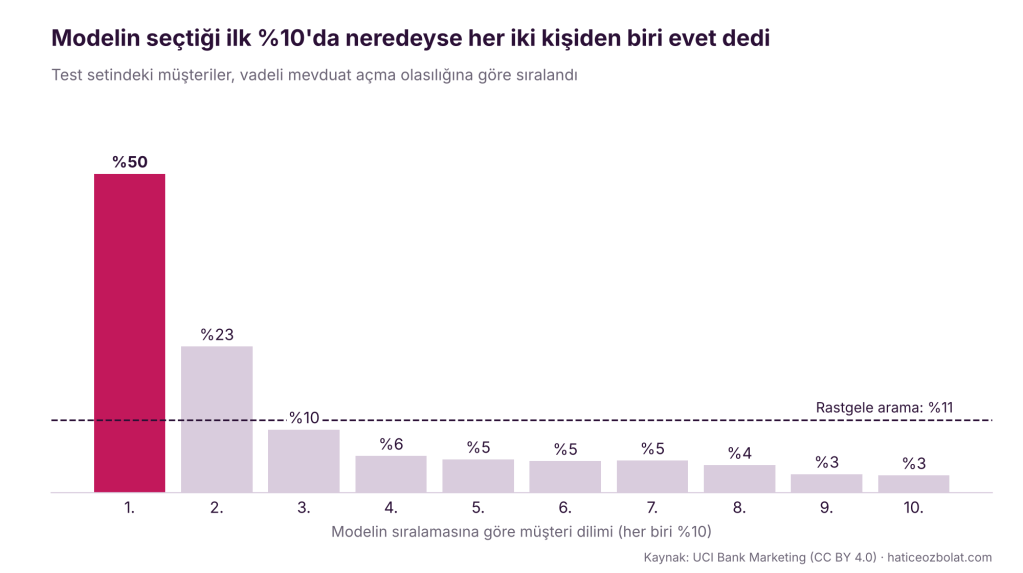
    Modelin sıralamasına göre 10 müşteri diliminde evet oranı. 1. dilimde %50, 2. dilimde %23; geri kalan dilimler %3 ile %10 arasında. Rastgele aramada oran %11.

    Modelin en umutlu bulduğu yüzde 10’luk dilimde 1.030 kişiden 510’u evet demiş: yaklaşık her iki kişiden biri. Bu dilim, test setindeki tüm evetlerin yüzde 44’ünü tek başına yakalıyor. Yani banka, listenin sadece onda birini arayarak müşterilerin neredeyse yarısına ulaşabilir.

    Bir model, her şeyi doğru tahmin etmek zorunda değil. Bazen tek işi doğru sıralamaktır.

    Sızıntılı model ne kadar iyi görünürdü?

    Aynı modeli bir de duration dahil kurduğumuzda (not defterinin 10. bölümü):

    duration olmadan ROC-AUC: 0.802
    duration ile ROC-AUC: 0.940

    0,94 çok daha parlak duruyor ve bir sunumda insanları kolayca etkiler. Ama gerçek hayatta kullanılamaz. Bir model fazla iyi çıktığında ilk soracağın soru şu olmalı: Bu bilgi, tahmin anında elimde olacak mı?

    Bu projeden kalanlar

    • Eksik veri her zaman NaN olarak gelmez; unknown ve 999 gibi kılıklara bak.
    • Grup oranlarına bakarken görüşme sayısını da yaz. Küçük gruplardaki uç oranlar akıl karıştırır.
    • Dengesiz veride accuracy’ye güvenme; recall, precision ve ROC-AUC’ye bak.
    • Modeli işin sorusuna göre değerlendir. Burada soru “kimi önce arayalım?” olduğu için sıralama kalitesi asıl ölçü.
    • “Fazla iyi” sonuçlarda veri sızıntısından şüphelen.

    Kendin dene

    1. class_weight="balanced" parametresini sil. Recall ve precision nasıl değişti?
    2. Eşiği 0,5 yerine 0,3 ve 0,7 yap. Yakalanan ve boşa aranan kişi sayıları nasıl değişiyor?
    3. LogisticRegression yerine RandomForestClassifier dene. ROC-AUC artıyor mu?
    4. education sütunu için oran_tablosu çalıştır. Ne görüyorsun?

    Kaynak ve lisans

    Moro, S., Cortez, P. ve Rita, P. (2014). A Data-Driven Approach to Predict the Success of Bank Telemarketing. Decision Support Systems, 62, 22-31. Veri: UCI Machine Learning Repository, Bank Marketing, CC BY 4.0.

  • Turing’in 1950 Makalesi: Makineler Düşünebilir mi?

    Turing’in 1950 Makalesi: Makineler Düşünebilir mi?

    Sabah bir sohbet botuna soru soruyorsun, cevabı okuyorsun ve bir an duraksıyorsun: “Bunu gerçekten anlıyor mu, yoksa sadece anlıyormuş gibi mi yapıyor?” Bu soru yeni değil. 76 yıl önce, daha bilgisayarlar oda büyüklüğündeyken, bir matematikçi tam olarak bunu sordu ve cevabı aramanın yolunu değiştirdi.

    O matematikçi Alan Turing. Makalenin adı Computing Machinery and Intelligence (Hesaplama Makineleri ve Zekâ). 1950’nin Ekim ayında felsefe dergisi Mind‘da yayımlandı. Bu yazıda makaleyi baştan sona, sade bir dille birlikte okuyacağız.

    Turing makaleye “Makineler düşünebilir mi?” sorusuyla başlıyor ve hemen ardından bu soruyu bir kenara koyuyor. Gerekçesi şu: “makine” ve “düşünmek” kelimelerinin anlamı üzerinde anlaşamazsak, tartışma bir anketle cevaplanacak bir kelime oyununa döner.

    Bunun yerine soruyu, cevabı gözlemlenebilen bir oyunla değiştiriyor. Bu, makalenin en önemli hamlesi: belirsiz bir felsefe sorusunu, deney yapılabilecek bir soruya çevirmek. Veriyle çalışan herkesin tanıdığı bir alışkanlık bu aslında. “Müşteri memnun mu?” ölçülemez; “müşteri ikinci kez alışveriş yaptı mı?” ölçülebilir.

    Oyunun ilk hâlinde makine yok. Üç kişi var:

    • A: bir erkek
    • B: bir kadın
    • C: sorgulayıcı, başka bir odada

    Sorgulayıcı ikisini de göremiyor, sesini de duymuyor; yazılı mesajlarla soru soruyor. Amacı, hangisinin kadın olduğunu bulmak. A’nın görevi sorgulayıcıyı yanıltmak, B’nin görevi ona yardım etmek.

    Sonra Turing asıl soruyu soruyor: A’nın yerine bir makine geçerse ne olur? Sorgulayıcı, makineyle konuşurken de insanla konuşurken olduğu kadar sık yanılır mı?

    Bugün “Turing testi” dediğimiz şey bu oyunun sadeleşmiş hâli: bir insan, ekranın öbür ucundakinin insan mı makine mi olduğunu yazışarak anlamaya çalışıyor.

    Dikkat et: Turing testi “makine düşünüyor mu?” sorusunu cevaplamıyor. “Makine, düşünen biri gibi davranabiliyor mu?” sorusunu cevaplıyor. İkisi arasındaki fark, bugün hâlâ tartışılan şeyin ta kendisi.

    Turing makalede somut bir tahmin de yapıyor: yaklaşık elli yıl içinde, beş dakikalık bir sorgudan sonra ortalama bir sorgulayıcının doğru tahmin şansının yüzde 70’i geçmeyeceği kadar iyi oynayan makineler yapılabilecek. Yani 2000 civarı.

    2000 yılında böyle bir makine yoktu. Ama bu yazının sonunda göreceğin gibi, tahmin tamamen boşa da çıkmadı; sadece biraz gecikti.

    Dokuz itiraz ve Turing’in cevapları

    Makalenin en eğlenceli kısmı burası. Turing, “makineler asla düşünemez” diyenlerin olası itirazlarını tek tek sıralıyor ve her birine cevap veriyor. Hepsini kısaca geçelim:

    1. Teolojik itiraz. Düşünmek ruha aittir, makinenin ruhu yoktur. Turing, bu tartışmaya girmeden bunun makinelerin yapabileceklerini sınırlamak için yeterli bir gerekçe olmadığını söylüyor.
    2. “Kafayı kuma gömme” itirazı. Makinelerin düşünmesinin sonuçları çok korkutucu olurdu, o yüzden düşünemediklerini umalım. Turing bunu bir argüman bile saymıyor; bir korku ifadesi olarak görüyor.
    3. Matematiksel itiraz. Gödel’in eksiklik teoremi gibi sonuçlar, her mantık sisteminin cevaplayamayacağı sorular olduğunu gösterir. Turing’in cevabı: insanlar da her soruyu cevaplayamıyor ve sık sık yanılıyor.
    4. Bilinç itirazı. Makine bir şey hissetmeden şiir yazarsa, gerçekten düşünmüş olmaz. Turing burada keskin bir noktaya dokunuyor: başka bir insanın düşündüğünü de içine girip doğrulayamıyoruz. Bunu davranışına bakarak, bir tür nezaket kuralı olarak kabul ediyoruz.
    5. “Şunu asla yapamaz” itirazları. Makine asla şaka yapamaz, âşık olamaz, hatadan ders alamaz… Turing, bu listelerin çoğunun o güne kadar görülen makinelere bakılarak yapılmış genellemeler olduğunu söylüyor.
    6. Lady Lovelace itirazı. 1800’lerde Ada Lovelace, Babbage’ın Analitik Makinesi’nin yeni bir şey yaratma iddiası olmadığını, sadece kendisine ne yapması söylenirse onu yapabileceğini yazmıştı. Turing’in cevabı kişisel: makineler onu sık sık şaşırtıyor.
    7. Sinir sisteminin sürekliliği. Beyin sürekli sinyallerle çalışır, dijital makine ise kesikli adımlarla. Turing, oyunda bu farkın dışarıdan anlaşılamayacak kadar küçültülebileceğini söylüyor.
    8. Davranışın kurallara sığmaması. İnsan her durumda ne yapacağını söyleyen bir kural listesiyle tarif edilemez. Turing, kuralların bilinmemesi ile kuralların olmaması arasında fark olduğunu hatırlatıyor.
    9. Duyular dışı algı. Telepati gibi yetenekler oyunu bozabilir. Bugün okuyunca şaşırtıcı geliyor ama Turing bu itirazı o dönemin tartışmaları yüzünden oldukça ciddiye alıyor.

    Bu listeyi okurken bir şeyi fark ediyorsun: 1950’de sayılan itirazların neredeyse hepsi bugün sohbet botları hakkında yapılan tartışmalarda hâlâ duyuluyor. Özellikle 4. ve 6. madde.

    Öğrenen makineler: makalenin asıl geleceği gören kısmı

    Makalenin son bölümünde Turing, düşünebilen bir makineyi tek tek kurallar yazarak programlamanın çok zor olacağını söylüyor. Önerdiği yol şu: yetişkin bir zihni taklit etmeye çalışmak yerine bir çocuğun zihnini taklit eden bir program yaz, sonra onu eğit.

    Bugün buna makine öğrenmesi diyoruz. Kural yazmak yerine örneklerden öğrenen sistemler. Turing bunu, ilk modern bilgisayarların henüz yeni çalıştığı bir dönemde düşünmüş.

    Teste yöneltilen eleştiriler

    Turing testi kadar eleştirilen az fikir var. İki önemli örnek:

    • ELIZA (1966). Joseph Weizenbaum’un yazdığı bu basit program, kullanıcının cümlelerini soruya çevirerek bir terapisti taklit ediyordu. Hiçbir şey anlamıyordu ama bazı kullanıcılar ona gerçekten açıldı. Bu, insanların bir makineye anlam yüklemesinin ne kadar kolay olduğunu gösterdi.
    • Çin Odası (1980). Filozof John Searle şöyle bir düşünce deneyi önerdi: Çince bilmeyen biri, bir odada, Çince sorulara kural kitabına bakarak Çince cevaplar veriyor. Dışarıdan bakan biri onun Çince bildiğini sanır, ama o hiçbir şey anlamıyor. Searle’e göre makineler de böyle: sembolleri işler, anlamı kavramaz.

    Bu eleştiriler Turing’in sorusunu çürütmüyor; ama testi geçmenin “anlamak” ile aynı şey olmadığını hatırlatıyor.

    Bugün: test geçildi mi?

    2025’te UC San Diego’dan Cameron Jones ve Benjamin Bergen, Turing’in üç kişilik oyununa çok yakın bir deney yaptı. Katılımcılar aynı anda hem bir insanla hem de bir yapay zekâ sistemiyle beşer dakika yazıştı, sonra hangisinin insan olduğunu seçti.

    Sonuçlar:

    Sistemİnsan sanılma oranı
    GPT-4.5 (insan gibi davranması istenen bir kişilik talimatıyla)%73
    LLaMa-3.1-405B (aynı talimatla)%56
    ELIZA%23
    GPT-4o%21

    GPT-4.5, karşısındaki gerçek insandan daha sık “insan” olarak seçildi. Turing’in tahmini 25 yıl gecikmeyle de olsa gerçekleşmiş gibi görünüyor.

    Ama iki not düşmek gerek. Birincisi, bu sonuç modele özel bir kişilik talimatı verildiğinde çıktı. İkincisi, makalenin yazarları da testi geçmenin modelin “düşündüğü” anlamına gelip gelmediğinin ayrı bir tartışma olduğunu kabul ediyor. Yani Turing’in kenara koyduğu soru, tam da şimdi geri döndü.

    Bir dil modelinin metni nasıl parçalara ayırıp okuduğunu merak ediyorsan:

    Makaleyi kendin okumak istersen

    Makale İngilizce ve yaklaşık 28 sayfa, ama teknik değil; düz bir deneme gibi okunuyor. Ders kitabı değil, bir sohbet gibi yazılmış. Bilgisayar bilimine yeni başlıyorsan, bu alanın kurucu metinlerinden birini kendi gözünle görmek iyi bir deneyim.

    Kaynaklar

    • Turing, A. M. (1950). Computing Machinery and Intelligence. Mind, 59(236), 433-460.
    • Jones, C. R. ve Bergen, B. K. (2025). Large Language Models Pass the Turing Test. arXiv:2503.23674
    • Searle, J. R. (1980). Minds, Brains, and Programs. Behavioral and Brain Sciences, 3(3), 417-424.
    • Weizenbaum, J. (1966). ELIZA. Communications of the ACM, 9(1), 36-45.
  • Yapay Zekâ Mühendisi Olmak İçin Yol Haritası

    Yapay Zekâ Mühendisi Olmak İçin Yol Haritası

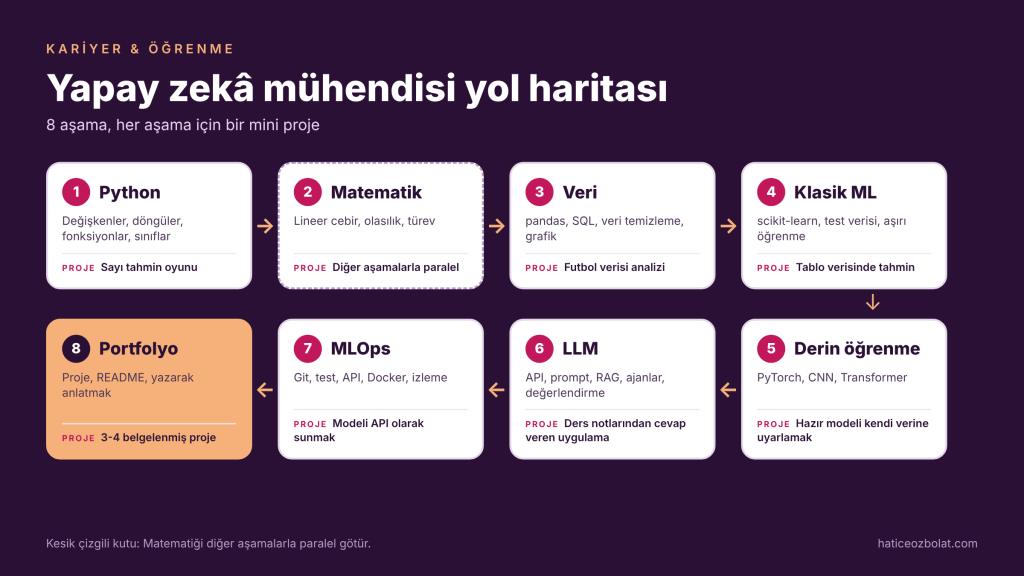
    “Yapay zekâ mühendisi olmak istiyorum, nereden başlamalıyım?” sorusunun internette binlerce cevabı var ve çoğu ya çok genel ya da yüzlerce kaynaktan oluşan, bakmaya bile üşendiren listeler. Bu yazıda yolu sekiz aşamaya böldüm. Her aşamada ne öğrenmen gerektiğini, neden gerektiğini ve o aşamayı bitirdiğini gösterecek küçük bir projeyi yazdım.

    Bu blogda yayımlanan derslerin çoğu da bu yolun bir parçası; her aşamada ilgili yazıları işaret ettim.

    Önce: Yapay zekâ mühendisi ne yapar?

    Bu unvan farklı şirketlerde farklı işler için kullanılıyor. Genel olarak üç yakın rol var:

    RolOdakTipik bir gün
    Veri bilimciVeriden soru sorup cevap bulmakAnaliz, deney, rapor, model denemeleri
    Makine öğrenmesi mühendisiModelleri eğitip ürüne taşımakEğitim hattı kurmak, modeli canlıya almak, izlemek
    Yapay zekâ mühendisiHazır büyük modellerle ürün geliştirmekBüyük dil modelleri, RAG, ajanlar, değerlendirme

    Sınırlar bulanık ve birçok ilan bu rollerin karışımını istiyor. Bu yüzden aşağıdaki yol haritası üçünün ortak temelini kuruyor; son aşamalarda hangisine ağırlık vereceğini sen seçiyorsun.

    1. Aşama: Programlama, yani Python

    Neden: Yapay zekâ dünyasının ortak dili Python. Kütüphanelerin, örneklerin, makalelerin kodlarının büyük çoğunluğu Python’la yazılıyor.

    Öğren: Değişkenler, koşullar, döngüler, fonksiyonlar, listeler ve sözlükler, hata yönetimi, dosya okuma, sınıflar ve nesneler.

    Bitirdiğini nasıl anlarsın: Küçük bir programı baştan sona kendin yazabiliyorsan. Örneğin bir sayı tahmin oyunu ya da bir yapılacaklar listesi uygulaması.

    Blogdaki Python dersleri bu aşamayı baştan sona kapsıyor.

    2. Aşama: Matematik temeli

    Neden: Modelleri kullanmak için matematik uzmanı olman gerekmiyor. Ama bir modelin neden çalışmadığını anlamak için temel kavramları bilmen gerekiyor.

    Öğren:

    • Lineer cebir: Vektör, matris, matris çarpımı. Bir sinir ağı aslında üst üste matris çarpımlarından oluşuyor.
    • Olasılık ve istatistik: Ortalama, dağılım, olasılık, hipotez testi. Bir modelin sonucuna ne kadar güveneceğini bunlar söylüyor.
    • Türev ve gradyan: Modeller hatalarını “gradyan inişi” denen bir yöntemle azaltıyor; türev bunun temeli.

    İpucu: Matematiği ayrı bir dönem gibi çalışmak yerine diğer aşamalarla paralel götür. Bir kavrama ihtiyacın olduğunda dönüp öğrenmek çoğu kişi için daha kalıcı.

    3. Aşama: Veriyle çalışmak

    Neden: Her yapay zekâ projesi veriyle başlıyor ve zamanın büyük kısmı veriyi hazırlamaya gidiyor.

    Öğren: pandas ile tablo verisi, NumPy, matplotlib ile grafik, SQL ile veritabanı sorgulama, veri temizleme.

    Mini proje: Açık bir veri setini indir, temizle, birkaç soru sor ve sonuçları grafiklerle anlat. Blogdaki Futbol Veri Projesi tam olarak bu aşamaya bir örnek.

    4. Aşama: Klasik makine öğrenmesi

    Neden: Derin öğrenmeye geçmeden önce makine öğrenmesinin temel fikirlerini oturtman gerekiyor: eğitim ve test verisi, aşırı öğrenme, değerlendirme ölçütleri. Bu fikirler en büyük modellerde bile aynı.

    Öğren: scikit-learn ile sınıflandırma ve regresyon; karar ağaçları, rastgele orman, lojistik regresyon; doğruluk, kesinlik, duyarlılık; çapraz doğrulama.

    Mini proje: Bir tablo veri setinde bir şey tahmin eden bir model kur, sonucunu dürüstçe değerlendir. Seçmen Şapkası yazısındaki karar ağacı ve Makine Öğrenmesi ile Derin Öğrenme farkı yazısı bu aşamaya giriş niteliğinde.

    5. Aşama: Derin öğrenme

    Neden: Görüntü, ses ve metin gibi verilerde günümüzün en güçlü modelleri derin öğrenmeye dayanıyor.

    Öğren: Sinir ağlarının nasıl öğrendiği, PyTorch ile model kurmak, evrişimli sinir ağları (CNN), Transformer mimarisi ve dikkat (attention) mekanizması.

    Mini proje: Hazır eğitilmiş bir modeli kendi küçük veri setine uyarla (fine-tuning). Örneğin kendi çektiğin fotoğraflarda iki şeyi ayırt eden bir model.

    Blogdaki Attention yazısı, Transformer’ın arkasındaki fikri anlatıyor.

    6. Aşama: Büyük dil modelleri ve üretken yapay zekâ

    Neden: Bugün “yapay zekâ mühendisi” ilanlarının çoğu bu alanla ilgili: hazır bir büyük dil modelini bir ürünün içine güvenli ve faydalı bir şekilde yerleştirmek.

    Öğren:

    • Bir modeli API üzerinden kullanmak ve iyi prompt yazmak
    • Token, bağlam penceresi ve maliyet
    • Embedding’ler ve vektör veritabanları
    • RAG: Modelin kendi belgelerinden cevap vermesini sağlamak
    • Araç kullanan ajanlar
    • Değerlendirme: Modelin cevaplarının doğru ve güvenli olduğunu nasıl ölçeceğin. Bu alanın en çok ihmal edilen ama en çok aranan becerisi.

    Mini proje: Bir dersin notlarını yükleyip onlara dayanarak soru cevaplayan küçük bir RAG uygulaması. Cevapların doğruluğunu ölçmek için kendi 20 soruluk test setini hazırla.

    Blogdaki LLM Nedir? ve İyi Bir Prompt Nasıl Yazılır? yazıları bu aşamaya giriş.

    7. Aşama: Yazılım mühendisliği ve modeli canlıya almak

    Neden: Not defterinde çalışan bir model ile gerçek kullanıcıların kullandığı bir ürün arasında büyük bir fark var. İşe alımlarda bu farkı kapatabilen kişiler öne çıkıyor.

    Öğren: Git ve GitHub, test yazmak, bir modeli API olarak sunmak (örneğin FastAPI ile), Docker, bir bulut platformunun temelleri, canlıdaki modeli izlemek (MLOps).

    Mini proje: 4. ya da 6. aşamadaki projeni basit bir web arayüzü ya da API ile başkalarının kullanabileceği hale getir.

    8. Aşama: Portfolyo ve sürekli öğrenme

    Neden: Bu alanda işe alımı diplomadan çok, ne yaptığını gösterebilmen belirliyor.

    Yap:

    • 3-4 iyi belgelenmiş proje. Kaç proje yaptığından çok, her birinde hangi problemi çözdüğünü, neyi denediğini ve neyin işe yaramadığını anlatman önemli.
    • Projelerini yazarak anlat: GitHub README’si, blog yazısı ya da LinkedIn gönderisi.
    • Alan çok hızlı değişiyor. Haftada birkaç saatini yeni gelişmeleri takip etmeye ayır.

    Ücretsiz başlangıç kaynakları

    • Kaggle Learn: Python, pandas ve makine öğrenmesine kısa ve uygulamalı giriş kursları.
    • Andrew Ng’in makine öğrenmesi ve derin öğrenme kursları: Kavramları sade anlatmasıyla bilinen, alanın en yaygın giriş kurslarından.
    • fast.ai: Derin öğrenmeye “önce yap, sonra teoriye in” yaklaşımıyla giren ücretsiz kurs.
    • Hugging Face kursları: Transformer modelleri ve büyük dil modelleriyle uygulamalı çalışmak için.

    Kaynakların çoğu İngilizce. Bu alanda ilerlemek istiyorsan teknik İngilizceni geliştirmek de yol haritasının gizli dokuzuncu aşaması.

    Sık sorulan sorular

    Bilgisayar mühendisliği okumak şart mı? Hayır. Matematik, istatistik, endüstri mühendisliği ya da tamamen farklı bir alandan gelip bu alana geçen çok kişi var. Ama programlama ve matematik temelini bir şekilde edinmen gerekiyor.

    Ne kadar sürer? Bu, haftada kaç saat ayırabildiğine ve nereden başladığına bağlı. Kimseyle kıyaslamadan, her aşamayı bir proje bitirerek kapatmak süreden daha önemli.

    Önce büyük dil modellerine mi başlasam? Hazır bir modeli API ile kullanmak için ilk üç aşama yeterli olabilir ve motivasyon için iyi bir başlangıç. Ama bir şeyler ters gittiğinde nedenini anlamak için 4. ve 5. aşamalara mutlaka dönmen gerekecek.

    Devamını oku

  • Token Nedir? Yapay Zekâ Metni Nasıl Okur?

    Token Nedir? Yapay Zekâ Metni Nasıl Okur?

    Yapay zekâ araçlarının fiyat sayfalarında, kullanım sınırlarında ve teknik açıklamalarında hep aynı kelime geçiyor: token. “Bu model 200 bin token okuyabiliyor”, “1 milyon token başına şu kadar ücret”… Peki token tam olarak ne? Ve neden aynı cümlenin Türkçesi İngilizcesinden daha fazla token tutuyor?

    Kısa tanım

    Token, bir dil modelinin metni okurken kullandığı en küçük parça. Bazen bir kelimenin tamamı, bazen bir hece gibi bir parçası, bazen tek bir harf ya da noktalama işareti.

    Modeller metni harf harf ya da kelime kelime değil, token token okuyor. Metni token’lara bölen programa tokenizer deniyor. Tokenizer her token’ı bir sayıya çeviriyor; model aslında kelimeleri değil, bu sayı dizisini görüyor.

    Bir örnekle görelim

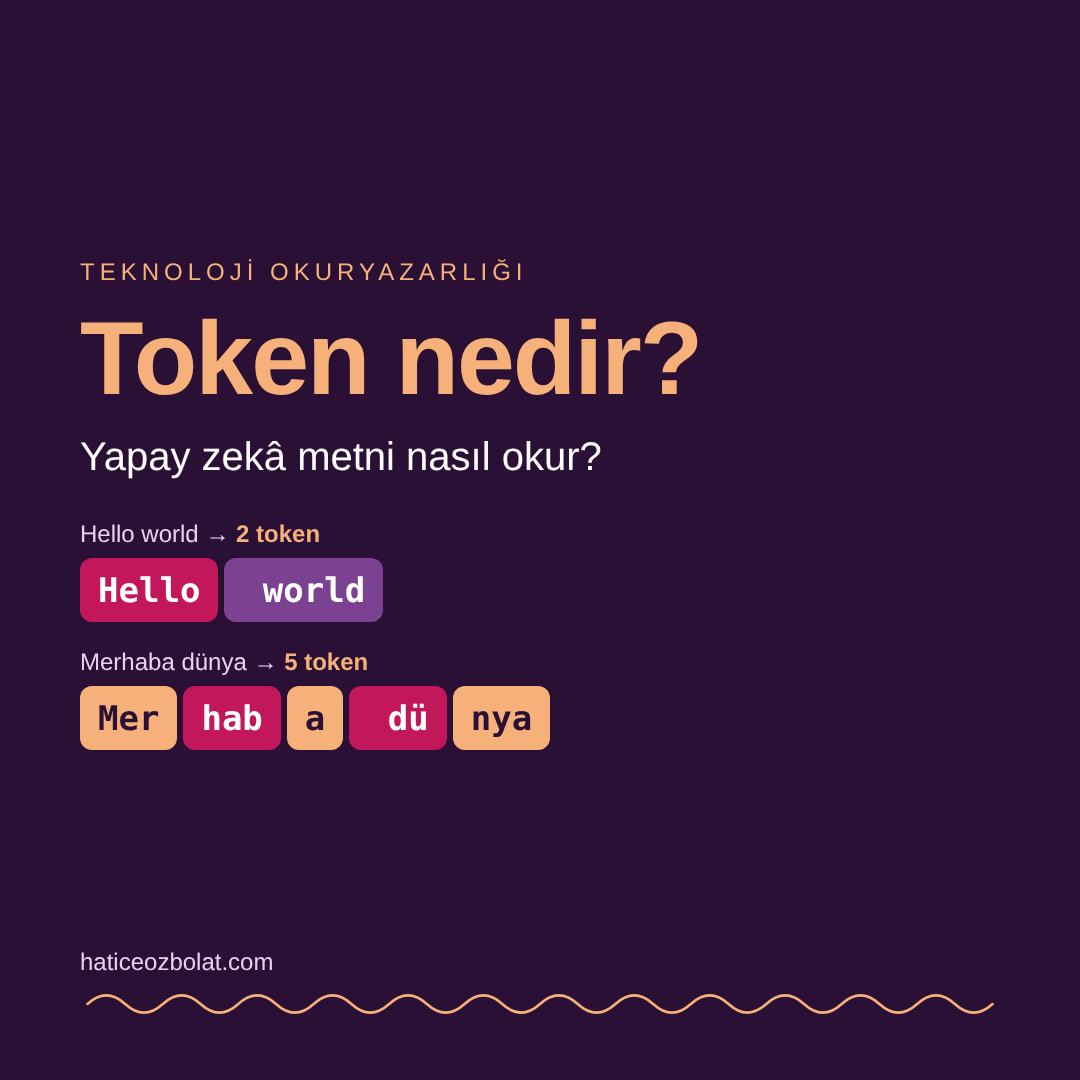
    Aşağıdaki sonuçlar, OpenAI’ın GPT-4 ve GPT-3.5 modellerinde kullanılan cl100k_base tokenizer’ıyla alındı:

    "Hello world" → 'Hello' | ' world' → 2 token
    "Merhaba dünya" → 'Mer' | 'hab' | 'a' | ' dü' | 'nya' → 5 token

    İngilizcede iki kelime iki token. Türkçede ise “Merhaba” üç, “dünya” iki parçaya bölünmüş. Kelimelerin önündeki boşluk da token’ın bir parçası (' world', ' dü').

    Aynı anlamdaki iki cümle daha:

    CümleKarakterToken
    The weather is very nice today.317
    Bugün hava çok güzel.218
    How does AI read text?226
    Yapay zekâ metni nasıl okur?2813

    Türkçe cümle daha kısa olmasına rağmen daha fazla token tutuyor. Bu örneklerde İngilizcede bir token ortalama 4 civarı karaktere denk gelirken, Türkçede 2 ile 2,5 karakter arasında kalıyor.

    Neden Türkçe daha fazla token tutuyor?

    Tokenizer’lar eğitildikleri metinlerde sık geçen parçaları tek bir token olarak öğreniyor. Eğitim verisinin büyük kısmı İngilizce olduğu için “weather”, “today” gibi kelimeler tek parça halinde sözlükte yer alıyor. Türkçe kelimeler ise daha nadir görüldüğü için parçalara bölünüyor.

    Buna Türkçenin eklemeli yapısı da ekleniyor. Bir köke ekler eklendikçe ortaya çok sayıda farklı kelime çıkıyor ve bunların her birinin sözlükte hazır olması mümkün değil. En uç örnek:

    "Çekoslovakyalılaştıramadıklarımızdanmışsınız"
    → Ç | ek | os | lovak | yal | ı | la | şt | ı | ram | ad | ıkl | ar | ım | ız | dan | m | ış | s | ını | z
    → 21 token

    Tek bir kelime 21 token. Tokenizer’ın böldüğü yerlerin Türkçe eklerle her zaman örtüşmediğine de dikkat et: “şt”, “ram”, “m” gibi parçalar dilbilgisi açısından bir anlam taşımıyor. Tokenizer dili anlamaya çalışmıyor, sadece sık gördüğü parçaları kullanıyor.

    Not: Her model ailesinin kendi tokenizer’ı var ve daha yeni tokenizer’lar çok dilli metinlerde genellikle daha verimli. Aynı cümle başka bir modelde farklı sayıda token tutabilir; ama genel eğilim, yani Türkçenin İngilizceden daha fazla token tutması, çoğu modelde görülüyor.

    Token neden önemli?

    • Bağlam penceresi: Bir modelin aynı anda “aklında tutabildiği” metin miktarı token cinsinden ölçülüyor. Uzun bir PDF’i ya da uzun bir sohbeti modele verirken sınırı belirleyen şey karakter sayısı değil, token sayısı.
    • Maliyet: API üzerinden kullanılan modeller genellikle token başına ücretlendiriliyor; hem gönderdiğin hem de modelin ürettiği token’lar sayılıyor. Aynı içerik Türkçe daha fazla token tutuyorsa, Türkçe işlem aynı modelde daha pahalıya gelebiliyor.
    • Hız: Modeller cevabı token token üretiyor. Ekranda kelimelerin parça parça belirmesinin sebebi bu.
    • Garip hatalar: Modelin bir kelimedeki harfleri saymakta zorlanması gibi tuhaf hataların bir kısmı buradan geliyor. Model kelimeyi harf harf değil, parça parça görüyor.

    Kendin dene

    Colab’da şu kodla istediğin metnin kaç token tuttuğunu ve nasıl bölündüğünü görebilirsin:

    !pip install -q tiktoken
    import tiktoken
    enc = tiktoken.get_encoding("cl100k_base")
    metin = "Bugün hava çok güzel."
    kodlar = enc.encode(metin)
    print(len(kodlar), "token")
    print(kodlar) # modelin gördüğü sayılar
    print([enc.decode([k]) for k in kodlar]) # her sayının karşılığı olan parça
    8 token
    [47873, 16461, 305, 2979, 58112, 55008, 28493, 13]
    ['Bug', 'ün', ' h', 'ava', ' çok', ' gü', 'zel', '.']

    İkinci satırdaki sayılar modelin gerçekten “okuduğu” şey. Kendi adını, bir şehir adını ya da uzun bir Türkçe kelimeyi deneyip kaç parçaya bölündüğüne bak.

    Bir cümlede

    Token, dil modelinin metni okuduğu parça; bağlam sınırı, maliyet ve hız hep token’la ölçülüyor ve Türkçe aynı anlamı genellikle İngilizceden daha fazla token’la ifade ediyor.

    Devamını oku