Yazar: Hatice Özbolat

  • Makine Öğrenmesi ve Derin Öğrenme Arasındaki Fark

    Makine Öğrenmesi ve Derin Öğrenme Arasındaki Fark

    Yapay zekâ haberlerinde “makine öğrenmesi” ve “derin öğrenme” ifadeleri çoğu zaman aynı cümlede, hatta birbirinin yerine geçiyor. Aslında ikisi aynı şey değil, ama birbirinden bağımsız da değil. Bu yazıda farkı bir örnekle ve on satırlık bir Python koduyla netleştireceğiz.

    Kısa tanım

    • Makine öğrenmesi, bilgisayarın kuralları bizim yazmamıza gerek kalmadan, örneklerden öğrenmesini sağlayan yöntemlerin genel adı.
    • Derin öğrenme, makine öğrenmesinin bir alt dalı. Çok katmanlı yapay sinir ağlarını kullanıyor.

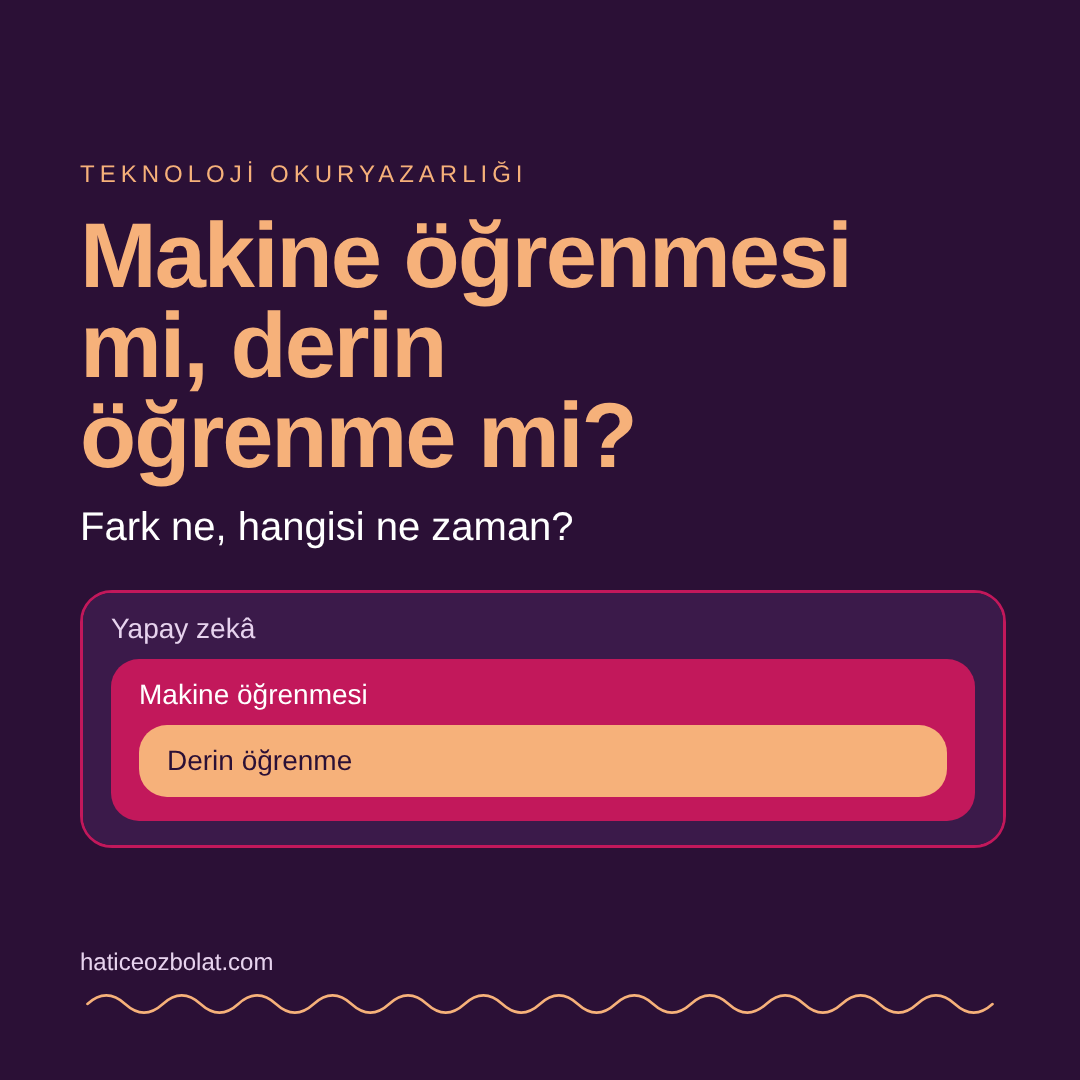
    Yani her derin öğrenme modeli bir makine öğrenmesi modeli, ama her makine öğrenmesi modeli derin öğrenme değil. İç içe üç halka gibi düşünebilirsin: En dışta yapay zekâ, onun içinde makine öğrenmesi, en içte derin öğrenme.

    Asıl fark: özellikleri kim seçiyor?

    Bir fotoğrafta kedi olup olmadığını anlayan bir model yapmak istediğimizi düşünelim.

    Klasik makine öğrenmesiyle önce bizim düşünmemiz gerekiyor: Bir kediyi kedi yapan ne? Kulakların şekli, bıyıklar, gözlerin konumu… Bu özellikleri fotoğraftan çıkaran kodu biz yazıyoruz. Model de bu özelliklere bakıp karar vermeyi öğreniyor. Bu adıma özellik mühendisliği (feature engineering) deniyor.

    Derin öğrenmeyle modele doğrudan fotoğrafın piksellerini veriyoruz. Sinir ağının ilk katmanları kenarları ve renk geçişlerini, sonraki katmanlar kulak ve göz gibi şekilleri, son katmanlar da “kedi yüzü” gibi bütünleri tanımayı kendi kendine öğreniyor. Hangi özelliğe bakacağını biz söylemiyoruz.

    Adındaki “derin” kelimesi de buradan geliyor: Üst üste dizilmiş çok sayıda katman.

    Python ile küçük bir karşılaştırma

    scikit-learn’ün içinde gelen el yazısı rakam veri setini kullanalım: 8×8 piksellik, 1797 rakam görüntüsü. Aynı veride bir karar ağacını ve küçük bir sinir ağını deneyelim:

    from sklearn.datasets import load_digits
    from sklearn.model_selection import train_test_split
    from sklearn.tree import DecisionTreeClassifier
    from sklearn.neural_network import MLPClassifier
    X, y = load_digits(return_X_y=True)
    X_egitim, X_test, y_egitim, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
    agac = DecisionTreeClassifier(random_state=42).fit(X_egitim, y_egitim)
    sinir_agi = MLPClassifier(hidden_layer_sizes=(64, 32), max_iter=1000, random_state=42).fit(X_egitim, y_egitim)
    print(f"Karar ağacı: {agac.score(X_test, y_test):.0%}") # 86%
    print(f"Sinir ağı: {sinir_agi.score(X_test, y_test):.0%}") # 97%

    Aynı piksellerle karar ağacı test verisinin %86’sını, iki gizli katmanlı sinir ağı %97’sini doğru tanıdı. Karar ağacı tek tek piksellere bakıp “5. piksel koyu mu?” gibi sorular sorabiliyor. Sinir ağı ise katmanları sayesinde pikselleri bir araya getirip çizgi ve eğri gibi daha anlamlı kalıplar öğrenebiliyor.

    Dürüst bir not: İki katmanlı bu ağ gerçek dünyadaki derin öğrenme modellerinin yanında çok küçük. Yine de fikri göstermek için yeterli: Ham veride kalıp arama işinde katmanlı ağlar çok güçlü.

    Yan yana

    Klasik makine öğrenmesiDerin öğrenme
    Özellikleri kim seçiyor?Çoğunlukla insanModel kendisi öğreniyor
    Veri ihtiyacıAz ya da orta miktarda veriyle çalışabiliyorGenelde çok fazla veri istiyor
    DonanımSıradan bir bilgisayar yeterliBüyük modeller için GPU gerekiyor
    AçıklanabilirlikKarar ağacı gibi modellerin kuralları okunabiliyorNeden o kararı verdiğini anlamak zor
    Güçlü olduğu yerTablo verisi: satış, kredi, müşteri kayıtlarıGörüntü, ses, metin
    ÖrneklerKarar ağacı, rastgele orman, lojistik regresyonYapay sinir ağları, CNN’ler, Transformer’lar

    Hangisi ne zaman?

    • Elinde Excel benzeri tablo verisi varsa (müşteri yaşı, alışveriş sayısı, şehir gibi) klasik makine öğrenmesi çoğu zaman hem daha hızlı hem daha açıklanabilir bir sonuç veriyor.
    • Elinde fotoğraf, ses kaydı ya da uzun metin varsa derin öğrenme genelde çok önde.
    • Veri azsa, önce basit bir modelle başla. Basit model işini görüyorsa daha karmaşıkına geçmene gerek yok.

    Bu blogdan iki örnek: Seçmen Şapkası yazısındaki karar ağacı klasik makine öğrenmesiydi; dört puanlık bir tablo verisinden kurallar çıkardı ve o kuralları okuyabildik. Attention yazısında anlattığım Transformer modelleri ise derin öğrenmenin bugünkü en bilinen örneği; ChatGPT gibi dil modellerinin temeli bunlar.

    [AFFILIATE: makine öğrenmesine giriş kitabı ya da kursu]

    Bir cümlede

    Makine öğrenmesi bilgisayarın örneklerden öğrenmesi; derin öğrenme ise bunun, çok katmanlı sinir ağlarıyla neye bakacağını da kendi kendine öğrenen alt dalı.
    Devamını oku

  • Öğrenciler İçin 7 Ücretsiz Yapay Zekâ Aracı

    Öğrenciler İçin 7 Ücretsiz Yapay Zekâ Aracı

    Yapay zekâ araçlarının sayısı o kadar arttı ki hangisini ne için kullanacağını seçmek başlı başına bir iş haline geldi. Üstelik çoğunun aylık ücreti öğrenci bütçesi için hiç de küçük değil. Bu yazıda ücretsiz kullanabileceğin ya da öğrenci olduğun için ücretsiz alabileceğin yedi aracı topladım: her biri ne işe yarıyor, ücretsiz sürümün sınırı ne ve bir öğrenci olarak onu en iyi nasıl kullanırsın.

    Önemli: Ücretsiz paketler ve öğrenci teklifleri çok sık değişiyor. Buradaki bilgileri 5 Kasım 2026’da kontrol ettim. Bir teklife başvurmadan önce aracın kendi sayfasına mutlaka bak.

    1. ChatGPT: her işe yarayan asistan

    Ne işe yarar: Soru sormak, bir konuyu basitçe anlatmasını istemek, bir metni özetletmek, kodundaki hatayı bulmak, sunum fikri çıkarmak.

    Ücretsiz sürüm: OpenAI’ın en küçük modeliyle sınırsız yazılı sohbet, sınırlı dosya yükleme, görsel üretme ve sesli konuşma. Derin araştırma gibi özellikler sınırlı. Ücretsiz hesaplarda yanıtların altında reklam görünebiliyor.

    Öğrenci ipucu: Ayarlar’daki Veri Kontrolleri bölümüne bak. Ücretsiz hesaplarda sohbetlerin modeli eğitmek için kullanılması varsayılan olarak açık; istemiyorsan buradan kapatabilirsin.

    2. Gemini: Google hesabınla hemen başla

    Ne işe yarar: ChatGPT’ye benzer bir asistan; Gmail, Drive ve Docs gibi Google araçlarıyla birlikte çalışabilmesi ayrıca işe yarıyor.

    Ücretsiz sürüm: Google hesabı olan herkes kullanabiliyor.

    Öğrenci teklifi: Google, üniversite öğrencilerine 12 aylık ücretsiz Google AI Plus denemesi ve AI Pro için indirim sunuyor. 18 yaşını doldurmuş olman ve öğrenciliğini SheerID üzerinden belgelemen gerekiyor; belgede adın, üniversitenin adı ve güncel kayıt tarihi görünmeli. Google’ın yardım sayfasında Türkiye, YouTube Premium Student ile birlikte gelen AI Pro paketinin geçerli olduğu ülkeler arasında; diğer seçeneklerin Türkiye’de görünüp görünmediğini kendi hesabından kontrol et.

    Dikkat: Deneme bitince plan otomatik olarak ücretli hale geliyor. Takvimine bir hatırlatıcı koy.

    3. Claude: uzun metin ve düzgün yazı

    Ne işe yarar: Uzun bir PDF’i ya da makaleyi okuyup soru sormak, yazını düzeltmek ya da açıklamak, kod yazarken adım adım anlatmasını istemek.

    Ücretsiz sürüm: Sohbet, dosya ve görsel yükleme var; kullanım sınırına ulaşınca bir süre beklemen gerekiyor.

    Öğrenci ipucu: “Cevabı söyleme, beni sorularla doğru cevaba götür” diye başla. Bir konuyu gerçekten öğrenmek istediğinde bu yöntem hazır cevaptan çok daha işe yarıyor; aynı cümle diğer asistanlarda da çalışır.

    4. Gemini Notebook (eski adıyla NotebookLM): kendi notlarınla çalışan asistan

    Ne işe yarar: Ders notlarını, PDF’lerini, sunumlarını yüklüyorsun ve sadece bu kaynaklara dayanarak cevap veriyor. Her cevabın hangi kaynağın neresinden geldiğini gösteriyor. Kaynaklarından özet, çalışma rehberi ve podcast tadında sesli özet çıkarabiliyor.

    Ücretsiz sürüm: Google hesabıyla ücretsiz; not defteri ve kaynak sayısında sınır var. Google, Temmuz 2026’da NotebookLM’in adını Gemini Notebook olarak değiştirdi; eski not defterlerin yerinde duruyor.

    Öğrenci ipucu: Sınav haftası için en kullanışlı araç bu olabilir. Bir dersin bütün notlarını tek bir not defterine yükle ve “Bu notlara göre bana 10 soruluk bir test hazırla” de.

    5. Perplexity: kaynak gösteren arama

    Ne işe yarar: Arama motoru ile sohbet asistanının karışımı. Bir soruya cevap verirken web’de arama yapıyor ve kullandığı kaynakların linklerini gösteriyor.

    Ücretsiz sürüm: Temel arama sınırsız; daha kapsamlı “Pro” aramalar günlük sınırlı. Doğrulanmış öğrenciler için indirimli bir plan da var.

    Öğrenci ipucu: Ödev ya da sunum için kaynak ararken buradan başla, ama verdiği linkleri açıp kendin oku. Kaynak göstermesi, kaynağı doğru özetlediği anlamına gelmiyor.

    6. Microsoft Copilot: Windows’ta ve Edge’de hazır

    Ne işe yarar: Genel amaçlı bir asistan; Windows’ta ve Edge tarayıcısında zaten kurulu geliyor. Web sayfası özetlemek ve görsel üretmek için pratik.

    Ücretsiz sürüm: Microsoft hesabıyla ücretsiz kullanılabiliyor.

    Öğrenci ipucu: Üniversiten Microsoft 365 kullanıyorsa okul hesabınla giriş yapmayı dene; bazı kurumlar öğrencilerine ek özellikler açıyor.

    7. GitHub Copilot: kod yazan öğrenciler için

    Ne işe yarar: VS Code gibi kod editörlerinin içinde çalışıyor. Sen yazarken sonraki satırları öneriyor, kodunu açıklıyor, hataları bulmana yardım ediyor.

    Ücretsiz sürüm: Herkese açık bir ücretsiz plan var; aylık kod tamamlama ve sohbet hakkı sınırlı.

    Öğrenci teklifi: GitHub Education’a öğrenci olarak başvurup onay alırsan Copilot Student’ı ücretsiz etkinleştirebiliyorsun. GitHub uygunluğunu her ay yeniden kontrol ediyor; onaydan sonra avantajın hesabına yansıması birkaç gün sürebiliyor. O süreçte sadece ücretli seçenekler görürsen satın alma, birkaç gün bekle.

    Öğrenci ipucu: Programlamayı yeni öğreniyorsan önerileri hemen kabul etme. Önce kendin yaz, takıldığın yerde kullan. Yoksa kod çalışır ama sen öğrenmemiş olursun.

    Hepsi bir tabloda

    AraçEn iyi olduğu işÖğrenci teklifi
    ChatGPTGenel sorular, açıklama, beyin fırtınasıYok
    GeminiGoogle araçlarıyla birlikte çalışmak12 ay ücretsiz AI Plus denemesi, AI Pro indirimi
    ClaudeUzun belgeler, yazı ve kod açıklamaYok
    Gemini NotebookKendi ders notlarınla çalışmakYok; ücretsiz sürümü yeterince geniş
    PerplexityKaynak gösteren araştırmaİndirimli öğrenci planı
    Microsoft CopilotWindows ve Edge içinde hızlı yardımOkulunun anlaşmasına bağlı
    GitHub CopilotKod yazmakDoğrulanmış öğrencilere ücretsiz

    Kullanırken dikkat et

    • Yanılabilirler. Bu araçlar emin bir dille yanlış bilgi verebiliyor. Bir sayıyı, tarihi ya da alıntıyı ödevine koymadan önce aslından kontrol et.
    • Okulunun kurallarını öğren. Yapay zekâ kullanımına izin veren de, yasaklayan da, “kullandıysan belirt” diyen de dersler var. Emin değilsen hocana sor.
    • Kişisel bilgi paylaşma. Kimlik numarası, şifre, başkalarına ait kişisel bilgiler sohbet kutusuna yazılmaz.
    • Öğrenmenin yerine koyma. En iyi kullanım, aracı bir öğretmen gibi kullanmak: “Bunu bana açıkla”, “Nerede hata yaptım?”, “Beni test et.”

  • Kod Kartı: Counter ile Kelime Saymak

    Kod Kartı: Counter ile Kelime Saymak

    Bir önceki kartta kelime sayacını get() ile kurmuştuk: boş sözlük, for döngüsü, sayac.get(k, 0) + 1. Python’un hazır gelen collections modülünde aynı işi tek satırda yapan bir araç var: Counter.

    Kod

    from collections import Counter
    kelimeler = ["python", "veri", "python", "bilim"]
    sayac = Counter(kelimeler)
    print(sayac) # Counter({'python': 2, 'veri': 1, 'bilim': 1})
    print(sayac.most_common(2)) # [('python', 2), ('veri', 1)]
    print(sayac["python"]) # 2
    print(sayac["java"]) # 0

    Counter bir listeyi alıyor ve her elemanın kaç kez geçtiğini tutan bir sözlük döndürüyor. most_common(n) en sık geçen n elemanı büyükten küçüğe veriyor. Eşit sayıları olanlar listede ilk görüldükleri sırayla geliyor; “veri”nin “bilim”den önce gelmesinin sebebi bu.

    Son satıra dikkat: Normal bir sözlükte olmayan anahtar KeyError verirdi. Counter ise 0 döndürüyor, çünkü “hiç görülmedi” ile “0 kez görüldü” aynı şey. Bu get(k, 0) ile yaptığımızın hazır hali.

    Metinde de çalışır

    Counter‘a bir metin verirsen harfleri sayar:

    print(Counter("bilgisayar").most_common(2)) # [('i', 2), ('a', 2)]

    Birkaç kullanışlı özellik

    sayac.update(["veri", "veri"]) # yeni elemanları sayıma ekle
    print(sayac) # Counter({'veri': 3, 'python': 2, 'bilim': 1})
    print(sum(sayac.values())) # 6 toplam kelime
    print(len(sayac)) # 3 farklı kelime
    a = Counter(elma=3, muz=1)
    b = Counter(elma=1, kiraz=2)
    print(a + b) # Counter({'elma': 4, 'kiraz': 2, 'muz': 1})
    print(a - b) # Counter({'elma': 2, 'muz': 1})

    İki sayacı toplayabilir ya da birinden diğerini çıkarabilirsin. Çıkarmada sıfır ya da eksi kalanlar listeden düşüyor; kirazın sonuçta olmamasının sebebi bu.

    Dikkat: saymadan önce temizle

    Counter ne verirsen onu sayar. Metni temizlemeden verirsen sonuç yanıltır:

    metin = "Python öğrenmek eğlenceli. python ile veri analizi de eğlenceli!"
    print(Counter(metin.split()).most_common(2))
    # [('Python', 1), ('öğrenmek', 1)] "Python" ile "python" farklı sayıldı
    temiz = [k.strip(".,!?").lower() for k in metin.split()]
    print(Counter(temiz).most_common(2))
    # [('python', 2), ('eğlenceli', 2)]

    Büyük-küçük harf ve noktalama yüzünden aynı kelime farklı sayılıyor. Türkçe metinlerde lower() yerine Python Dersi 11’deki tr_lower fonksiyonunu kullanmayı da unutma.

    Sözlükleri Python Dersi 8’de, get() kartını Kod Kartı #06’da, metin temizliğini Python Dersi 11’de anlattım.

  • Bilgisayar Mühendisliği mi Yazılım Mühendisliği mi? Farklar ve Seçim Rehberi

    Bilgisayar Mühendisliği mi Yazılım Mühendisliği mi? Farklar ve Seçim Rehberi

    Tercih listesine bakarken iki satır yan yana duruyor: Bilgisayar Mühendisliği ve Yazılım Mühendisliği. İkisi de yazılım üretiyor, ikisinin de mezunu kod yazıyor. Peki fark ne ve hangisini seçmelisin?

    Kısa cevap: İki bölüm büyük ölçüde örtüşüyor; fark, hangi konuya daha çok ağırlık verdiklerinde. Bilgisayar mühendisliği bilgisayarın kendisini, yazılım mühendisliği ise büyük yazılımların nasıl planlanıp inşa edildiğini merkeze alıyor. Bu yazıda farkı dersler, iş hayatı ve karar verirken kendine sorman gereken sorular üzerinden açacağım.

    Bilgisayar mühendisliğinin ne olduğunu, neler okunduğunu ve mezunların nerelerde çalıştığını 31 Ekim’deki yazıda ayrıntılı anlattım. Bu yazı onun devamı; ilk kez okuyorsan önce ona göz atabilirsin.

    Ortak noktalar: ilk iki yıl birbirine çok benziyor

    Hangi bölümü seçersen seç, temel şunlar olacak:

    • Programlama: Genellikle C, C++, Java ya da Python gibi bir dille başlayıp nesne yönelimli programlamaya geçilir.
    • Veri yapıları ve algoritmalar: Listeler, ağaçlar, graflar, sıralama ve arama. Teknik mülakatların da en çok sorduğu konu.
    • Matematik: Kalkülüs, lineer cebir, ayrık matematik, olasılık ve istatistik.
    • Veritabanı: SQL ve veritabanı tasarımı.

    Bu yüzden ilk yıllarda iki bölümün öğrencisi aynı kitaplardan çalışıp aynı ödevlere takılabilir. Ayrışma genelde üçüncü yıl civarında belirginleşir.

    Bilgisayar mühendisliği: makinenin içine doğru

    Bilgisayar mühendisliği yazılımı öğretirken onun üzerinde çalıştığı makineyi de öğretir. Yazılım mühendisliğinde daha az yer alan dersler:

    • Sayısal tasarım ve mantık devreleri: Bilgisayarın 0 ve 1’lerle nasıl hesap yaptığı.
    • Bilgisayar mimarisi: İşlemci, bellek ve önbellek nasıl çalışır.
    • İşletim sistemleri: Programların aynı anda nasıl çalıştığı, belleğin nasıl paylaştırıldığı.
    • Bilgisayar ağları: Verinin bir bilgisayardan diğerine nasıl gittiği.
    • Biçimsel diller ve derleyiciler: Yazdığın kodun makine diline nasıl çevrildiği.
    • Gömülü sistemler: Bir akıllı saatin, bir arabadaki kontrol biriminin içindeki yazılım.

    Seçmeli derslerde yapay zeka, bilgisayarlı görü, güvenlik, dağıtık sistemler gibi alanlara yönelebilirsin. Genel olarak daha teorik ve donanıma daha yakın bir eğitim.

    Yazılım mühendisliği: yazılımın hayat döngüsü

    Yazılım mühendisliği “tek başına çalışan bir program” ile “yıllarca onlarca kişinin geliştirdiği, milyonlarca kişinin kullandığı bir sistem” arasındaki farka odaklanır. Öne çıkan dersler:

    • Gereksinim analizi: Müşterinin ya da kullanıcının ne istediğini doğru anlamak ve yazıya dökmek.
    • Yazılım tasarımı ve mimarisi: Sistemi parçalara ayırmak, tasarım kalıpları.
    • Yazılım testi ve kalite: Hatayı kullanıcıdan önce bulmak.
    • Yazılım proje yönetimi: Zaman, maliyet, risk ve ekip.
    • Süreç modelleri: Şelale modeli, çevik (agile) yöntemler, Scrum.
    • Bakım ve evrim: Yayımlanmış bir yazılımı bozmadan değiştirmek.

    Bölümlerin çoğunda ekip halinde yürütülen dönem projeleri önemli bir yer tutar. Genel olarak daha uygulamalı ve sürece odaklı bir eğitim.

    Yan yana

    Bilgisayar MühendisliğiYazılım Mühendisliği
    Merkezdeki soruBilgisayar nasıl çalışır, problemi nasıl verimli çözerim?Büyük bir yazılımı ekip olarak nasıl planlayıp inşa ederim?
    Ağırlıklı derslerMimari, işletim sistemleri, ağlar, derleyicilerGereksinim, tasarım, test, proje yönetimi
    DonanımTemel düzeyde varÇok az ya da yok
    Eğitimin tonuDaha teorikDaha uygulamalı, süreç odaklı
    Avantajlı olduğu alanlarGömülü sistemler, sistem programlama, ağ, araştırmaYazılım geliştirme, test, yazılım mimarisi, proje yönetimi

    Tablodaki “avantajlı” kelimesi “sadece onlar yapabilir” demek değil. İki bölümün mezunları da bu alanların hepsinde çalışıyor; fark, başlangıçta hazır gelen bilgide.

    İş hayatında fark ne kadar hissediliyor?

    Yazılım geliştirici ilanlarını okursan çoğunda şu kalıbı görürsün: “Bilgisayar Mühendisliği, Yazılım Mühendisliği veya ilgili bölümlerden mezun.” Özel sektörde işe alım genelde diplomadaki bölüm adından çok şunlara bakıyor:

    • Staj ve iş deneyimi
    • GitHub’da ya da portfolyonda gösterebildiğin projeler
    • Teknik mülakattaki performansın (veri yapıları, algoritmalar, sistem tasarımı)
    • Ekip içinde çalışabilme ve iletişim

    Farkın daha çok hissedildiği yerler donanıma yakın işler: gömülü yazılım, çip ve sistem tasarımı, ağ altyapısı. Bu alanlarda bilgisayar mühendisliği eğitimi seni bir adım öne taşır.

    Kamuda durum biraz farklı. Kamu ilanlarında hangi bölümlerin kabul edildiği ilandan ilana değişebiliyor ve başvuru şartlarında bölüm adı tek tek sayılabiliyor. Kamuda çalışmak gibi net bir hedefin varsa, tercih yapmadan önce hedeflediğin kurumun geçmiş ilanlarını okuyup hangi bölümleri kabul ettiğine bak. KPSS ve kamu bilişim kadroları hakkında daha önce yazdığım genel rehber de burada işine yarayabilir.

    Karar verirken kendine sor

    Aşağıdaki sorulara dürüst cevap vermek, iki bölüm arasında karararsız kaldığında işini kolaylaştırır:

    1. Bir bilgisayarın içinde ne olduğunu merak ediyor musun? İşlemcinin nasıl çalıştığı, bir programın bellekte nasıl durduğu ilgini çekiyorsa bilgisayar mühendisliği sana daha çok şey verir.
    2. Teoriyle mi, ürünle mi heyecanlanıyorsun? Bir algoritmanın neden hızlı olduğunu kanıtlamak mı, yoksa insanların kullandığı bir uygulamayı baştan sona çıkarmak mı seni daha çok çekiyor?
    3. Ekip, plan ve süreç konuları sana sıkıcı mı geliyor, ilginç mi? İlginç geliyorsa yazılım mühendisliğinin derslerinden keyif alma ihtimalin yüksek.
    4. Araştırma ya da akademi düşünüyor musun? Yapay zeka gibi alanlarda yüksek lisans yapmayı düşünüyorsan, bilgisayar mühendisliğinin daha geniş teorik temeli işine yarar. Yazılım mühendisliğinden de bu yola girilir; sadece bazı eksikleri kendin tamamlaman gerekebilir.
    5. İki bölüm arasında mı, iki üniversite arasında mı seçiyorsun? Çoğu zaman asıl farkı bölümün adı değil, o üniversitedeki müfredat, hocalar, laboratuvar imkanları ve staj bağlantıları yaratır.

    Tercih yapmadan önce yapman gerekenler

    • Ders planını oku. Aynı isimli bölümler farklı üniversitelerde çok farklı müfredata sahip olabiliyor. Üniversitenin sitesinde bölümün dört yıllık ders planını ve seçmeli ders listesini bul.
    • YÖK Atlas’a bak. Programın puan, sıralama ve kontenjan bilgilerini yıllara göre karşılaştırabilirsin.
    • Öğrencilerle konuş. Bölümün öğrencilerine sosyal medyadan ulaşmak çoğu zaman tanıtım broşüründen daha dürüst bilgi verir.
    • Staj, çift anadal ve yan dal imkanlarını sor. Bir bölümde okuyup diğerinin derslerini almak çoğu üniversitede mümkün.

    Yanlış seçersem ne olur?

    Bu iki bölüm arasında yanlış seçim yapmak zor, çünkü birinden diğerinin alanına geçmek oldukça mümkün. Bilgisayar mühendisliği okuyup yazılım mimarisinde uzmanlaşan da, yazılım mühendisliği okuyup sistem programlamaya yönelen de var. Eksik kalan dersleri seçmeli derslerle, yüksek lisansla ya da kendi kendine öğrenerek tamamlayabilirsin. Bu blogdaki Python dersleri de tam bu tür bir kendi kendine öğrenme yolculuğu için var.

    Bir cümlede

    Bilgisayar mühendisliği bilgisayarın nasıl çalıştığını, yazılım mühendisliği büyük yazılımların nasıl inşa edildiğini merkeze alır; ikisi de seni yazılım dünyasına götürür, asıl farkı senin merakın ve seçtiğin üniversite yaratır.

    Devamını oku

  • String İşlemleri: Metinlerle Çalışmak (Python Dersi 11)

    String İşlemleri: Metinlerle Çalışmak (Python Dersi 11)

    Bir uygulamaya adını yazdığında, bir arama kutusuna kelime girdiğinde ya da bir tweet atarken karakter sayısının azaldığını gördüğünde arka planda hep aynı şey çalışıyor: metin işlemleri. Python’da metne string (kısaca str) deniyor ve bu derste metinleri kesmeyi, bölmeyi, aramayı, değiştirmeyi ve düzgün biçimlendirmeyi öğreneceğiz. Bir de Türkçe yazan herkesin bir gün karşılaşacağı bir tuzağa bakacağız: I ve İ harfleri.

    Kodların hepsi Colab’da hazır: Colab’da Aç

    Metin bir karakter dizisidir

    Python’a göre bir metin, sıraya dizilmiş karakterlerden oluşuyor. Bu yüzden Ders 7’de listelerde öğrendiğin indeksleme ve dilimleme metinlerde de aynen çalışıyor:

    s = "Merhaba Dünya"
    print(len(s)) # 13 (boşluk da bir karakter)
    print(s[0]) # M
    print(s[-1]) # a
    print(s[0:7]) # Merhaba
    print(s[::-1]) # aynüD abahreM

    Son satırdaki [::-1] metni tersine çeviriyor: baştan sona, -1 adımla, yani geriye doğru.

    Metinler değiştirilemez

    Listelerden önemli bir farkı var: Bir metnin tek bir karakterini değiştiremezsin.

    s[0] = "m"
    # TypeError: 'str' object does not support item assignment

    Bu ders boyunca göreceğin bütün metotlar aslı değiştirmiyor, yeni bir metin döndürüyor. Değişikliği saklamak istiyorsan sonucu bir değişkene atamalısın: s = s.lower().

    Büyük-küçük harf ve boşluklar

    print(s.upper()) # MERHABA DÜNYA
    print(s.lower()) # merhaba dünya
    print("adana kebap".title()) # Adana Kebap
    print("ADANA".capitalize()) # Adana
    print(" ayşe ".strip() + "|") # ayşe|

    strip() baştaki ve sondaki boşlukları siliyor. Ders 10’daki sayı tahmin oyununda kullanıcı girişini temizlemek için kullanmıştık. Formlardan, dosyalardan gelen metinlerde baştaki ve sondaki boşluklar en sık karşılaşılan sorunlardan biri.

    Türkçe karakter tuzağı: I ve İ

    Bu bölümü atlama, çünkü Türkçe metinlerle çalışan herkesin başına gelir:

    print("istanbul".upper()) # ISTANBUL (İSTANBUL olmalıydı)
    print("ISPARTA".lower()) # isparta (ısparta olmalıydı)

    Python’un upper ve lower metotları İngilizce kurallarını uyguluyor. İngilizcede küçük i’nin büyüğü I, büyük I’nın küçüğü i. Türkçede ise dört ayrı harf var: ı, I, i, İ. Üstelik "İSTANBUL".lower() ekranda “istanbul” gibi görünse de içinde görünmez fazladan bir nokta işareti taşıyor; uzunluğu 8 değil 9 çıkıyor ve “istanbul” ile karşılaştırınca eşit sayılmıyor.

    Küçük bir çözüm: dönüşümden önce bu harfleri kendin değiştir.

    def tr_lower(metin):
    return metin.replace("I", "ı").replace("İ", "i").lower()
    def tr_upper(metin):
    return metin.replace("i", "İ").replace("ı", "I").upper()
    print(tr_lower("ISPARTA İZMİR")) # ısparta izmir
    print(tr_upper("istanbul ılgaz")) # İSTANBUL ILGAZ

    Bir kullanıcı adı araması, bir şehir listesi ya da Türkçe bir metindeki kelimeleri saymak gibi işlerde bu fark sonuçları doğrudan değiştiriyor.

    Bölmek ve birleştirmek: split ve join

    meyveler = "elma,armut,muz"
    liste = meyveler.split(",")
    print(liste) # ['elma', 'armut', 'muz']
    print(" - ".join(liste)) # elma - armut - muz
    print("python veri bilim".split()) # ['python', 'veri', 'bilim']

    split bir metni verdiğin ayırıcıdan bölüp liste yapıyor; ayırıcı vermezsen boşluklardan bölüyor. join tam tersini yapıyor: Bir listeyi aradaki metinle birleştiriyor. join‘in yazımı ilk başta ters gelebilir; ayırıcı başta, liste parantezin içinde.

    Aramak ve değiştirmek

    kelime = "bilgisayar"
    print(kelime.count("a")) # 2
    print(kelime.find("say")) # 5 (kaçıncı sırada başlıyor)
    print(kelime.find("x")) # -1 (bulunamadı)
    print("say" in kelime) # True
    print("merhaba".replace("a", "4")) # merh4b4
    print("ayse@ornek.com".endswith(".com")) # True
    print("Dr. Can".startswith("Dr.")) # True

    Sadece “var mı, yok mu?” diye soruyorsan in en okunaklı yol. Nerede olduğunu da bilmek istiyorsan find.

    f-string ile biçimlendirmek

    f-string’leri Ders 4’ten ve f-string kod kartından tanıyorsun. Süslü parantezin içine : koyup biçim de verebilirsin:

    ad = "zeynep"
    pi = 3.14159
    print(f"Merhaba {ad.title()}!") # Merhaba Zeynep!
    print(f"{pi:.2f}") # 3.14
    print(f"[{ad:>10}]") # [ zeynep] sağa yasla
    print(f"[{ad:<10}]") # [zeynep ] sola yasla

    Mini program: metin analizcisi

    Öğrendiklerimizi bir fonksiyonda birleştirelim. Bir metnin karakter sayısını, kelime sayısını, en uzun kelimesini ve en sık geçen kelimesini bulalım:

    def metin_analizi(metin):
    """Bir metnin kelime sayısını, en uzun kelimesini ve en sık geçen kelimesini döndürür."""
    kelimeler = [k.strip(".,!?;:").lower() for k in metin.split()]
    sayac = {}
    for k in kelimeler:
    sayac[k] = sayac.get(k, 0) + 1
    return {
    "karakter": len(metin),
    "kelime": len(kelimeler),
    "en_uzun": max(kelimeler, key=len),
    "en_sik": max(sayac, key=sayac.get),
    }
    metin = "Python öğrenmek eğlenceli. Python ile veri analizi de eğlenceli!"
    for ad, deger in metin_analizi(metin).items():
    print(f"{ad:<10} {deger}")
    karakter 64
    kelime 9
    en_uzun eğlenceli
    en_sik python

    İlk satırdaki liste üreteci her kelimenin ucundaki noktalama işaretlerini strip ile siliyor ve küçük harfe çeviriyor. Bunu yapmasaydık “eğlenceli.” ile “eğlenceli!” iki farklı kelime sayılırdı. Gerçek veriyle çalışırken metin işleminin büyük kısmı bu tür temizlikten oluşuyor.

    İki küçük program daha:

    def palindrom_mu(metin):
    """Boşlukları ve noktalamayı yok sayarak metin tersten de aynı mı diye bakar."""
    temiz = "".join(h for h in tr_lower(metin) if h.isalnum())
    return temiz == temiz[::-1]
    print(palindrom_mu("Ey Edip Adanada pide ye")) # True
    print(palindrom_mu("Python")) # False
    def maskele(eposta):
    kullanici, alan = eposta.split("@")
    return kullanici[0] + "*" * (len(kullanici) - 1) + "@" + alan
    print(maskele("ayse.yilmaz@ornek.com")) # a**********@ornek.com

    isalnum() bir karakterin harf ya da rakam olup olmadığını söylüyor; boşlukları ve noktalamayı eleyerek sadece harfleri bırakıyoruz. "*" * 10 metni 10 kez tekrarlıyor. E-posta maskeleme, birçok uygulamanın şifre sıfırlama ekranında gördüğün “a***@ornek.com” yazısının basit bir hali.

    [AFFILIATE: yeni başlayanlar için Python kitabı ya da kursu]

    Alıştırmalar

    1. Kullanıcının adını ve soyadını ayrı ayrı alıp “Soyad, Ad” biçiminde, soyadı büyük harfle yazdır (örnek: YILMAZ, Ayşe). Türkçe karakterlere dikkat.
    2. Bir cümledeki sesli harflerin sayısını bulan sesli_say(cumle) fonksiyonu yaz.
    3. "2026-11-04" metnini split ile parçalayıp "04.11.2026" biçimine çevir.
    4. Bir şifrenin en az 8 karakter olduğunu, içinde en az bir rakam ve en az bir büyük harf bulunduğunu kontrol eden sifre_guclu_mu(sifre) fonksiyonu yaz.

    Cevaplar Colab not defterinin sonunda.

    Bu derste ne öğrendik?

    • Metinler indekslenip dilimlenebilir ama değiştirilemez; metotlar yeni bir metin döndürür.
    • upper, lower, title, strip ile harf ve boşluk düzenlenir.
    • Türkçede I ve İ için upper ve lower yanlış sonuç verir; dönüşümden önce harfleri kendin değiştir.
    • split metni listeye, join listeyi metne çevirir.
    • in, find, count, replace, startswith, endswith ile arama ve değiştirme yapılır.
    • f-string’de : ile biçim verilir: {pi:.2f}, {ad:>10}.

    Sıradaki ders

    Python Dersi 12’de kümeleri ve liste üreteçlerini öğreniyoruz.

    Devamını oku

  • R Nedir, Python Varken Neden R? (R Dersi 1)

    R Nedir, Python Varken Neden R? (R Dersi 1)

    Blogda Python serisi devam ederken bugün yanına yeni bir seri ekliyoruz: R dersleri. Her salı ve perşembe bir R dersi yayımlanacak; Python dersleri de her zamanki gibi sürecek.

    İlk soru belli: Python bu kadar yaygınken neden bir dil daha? Bu derste R’ın ne olduğunu, nerede kullanıldığını ve Python’dan nerede ayrıldığını anlatacağım. Bir de ilk R kodlarını yazacağız, böylece farkı kendi gözünle göreceksin.

    R nedir?

    R, istatistiksel hesaplama ve veri analizi için geliştirilmiş, ücretsiz ve açık kaynaklı bir programlama dili. 1990’larda Yeni Zelanda’daki Auckland Üniversitesi’nde iki istatistikçi, Ross Ihaka ve Robert Gentleman tarafından başlatıldı. Adı da kısmen iki yaratıcısının isimlerinin baş harfinden geliyor.

    Bu köken R’ı anlamanın anahtarı. Python her işe yarayan genel amaçlı bir dil olarak doğdu; veri analizi sonradan eklenen kütüphanelerle geldi. R ise doğrudan istatistikçiler için, istatistikçiler tarafından tasarlandı. Ortalama, regresyon, hipotez testi gibi işler dilin içine gömülü.

    R’ın gücünün büyük kısmı CRAN (Comprehensive R Archive Network) adı verilen paket deposundan geliyor. Dünyanın dört bir yanındaki araştırmacıların yazdığı çok sayıda paket burada; yeni bir istatistik yöntemi çoğu zaman ilk R paketi olarak yayımlanıyor.

    R nerelerde kullanılıyor?

    • Akademik araştırma: Tez ve makalelerdeki istatistiksel analizler.
    • Sağlık ve ilaç: Biyoistatistik, klinik araştırmalar, epidemiyoloji.
    • Finans ve risk: Zaman serileri, risk modelleri.
    • Anket ve sosyal bilimler: Anket verisinin analizi ve raporlanması.
    • Veri görselleştirme: ggplot2 paketi, veri görselleştirmenin en bilinen araçlarından biri.
    • Raporlama: Kod, grafik ve yazıyı tek bir belgede birleştiren R Markdown ve Quarto.

    İlk R kodların

    Python derslerinden tanıdığın not örneğiyle başlayalım:

    notlar <- c(70, 85, 40, 90, 45)
    mean(notlar) # 66
    notlar + 5 # 75 90 45 95 50
    notlar[notlar >= 50] # 70 85 90

    İlk satırda iki yeni şey var:

    • <- R’da atama işareti, Python’daki = gibi. = de çalışıyor ama R topluluğunda gelenek <-.
    • c() birden fazla değeri bir araya getirip bir vektör oluşturuyor. Vektör R’ın temel veri yapısı; R Dersi 4’te ayrıntılı bakacağız.

    Asıl ilginç olan ikinci ve üçüncü satırlar. notlar + 5 bütün notlara tek seferde 5 ekliyor. Python’da aynı iş için bir döngü ya da liste üreteci yazman gerekirdi:

    # Python'da
    notlar = [70, 85, 40, 90, 45]
    print([n + 5 for n in notlar])
    print([n for n in notlar if n >= 50])

    R’da işlemler varsayılan olarak vektörün bütün elemanlarına uygulanıyor. Buna vektörizasyon deniyor ve R’da kod yazmanın doğal yolu bu.

    Dikkat: R saymaya 1’den başlar

    notlar[1] # 70, yani ilk eleman

    Python’da ilk eleman notlar[0] idi. R’da ise notlar[1]. Python’dan gelenlerin ilk haftalarda en çok takıldığı yer burası; notlar[0] yazarsan R hata vermez, boş bir sonuç döndürür.

    Tek satırda özet

    summary(notlar)
       Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
         40      45      70      66      85      90

    En küçük, en büyük, ortalama, medyan ve çeyrekler tek komutla. Bu, R’ın istatistik için tasarlandığının küçük ama güzel bir örneği.

    Tablolarla çalışmak: data.frame

    R’da tablo verisi için hazır bir yapı var: data.frame. Python’da bunun için pandas kütüphanesini yüklemen gerekiyor; R’da dilin içinde geliyor.

    ogrenciler <- data.frame(
    ad = c("Ayşe", "Mert", "Zeynep", "Can", "Elif"),
    bolum = c("Bilgisayar", "Elektrik", "Bilgisayar", "Elektrik", "Bilgisayar"),
    notu = notlar
    )
    ogrenciler[ogrenciler$notu >= 50, ] # geçen öğrenciler
    aggregate(notu ~ bolum, data = ogrenciler, FUN = mean)
           bolum     notu
    1 Bilgisayar 51.66667
    2   Elektrik 87.50000

    $ işareti tablodan bir sütun seçiyor: ogrenciler$notu. Son satırdaki notu ~ bolum ifadesi R’ın formül yazımı; “notu bölüme göre” diye okunuyor. Bu yazımı birazdan bir kez daha göreceğiz.

    R’ın asıl parladığı yer: istatistiksel modeller

    R, içinde hazır veri setleriyle geliyor. Bunlardan biri mtcars: 32 arabanın ağırlık, motor gücü ve yakıt tüketimi gibi bilgileri. “Araba ağırlaştıkça yakıt verimi nasıl değişiyor?” sorusunu tek satırla cevaplayabiliriz:

    model <- lm(mpg ~ wt, data = mtcars)
    coef(model)
    (Intercept) wt
    37.29 -5.34

    lm doğrusal regresyon (linear model) kuruyor. Sonuç şunu söylüyor: Bu veri setinde arabaların ağırlığı her 1000 pound arttığında yakıt verimi galon başına ortalama 5,34 mil düşüyor. summary(model) yazarsan da modelin istatistiksel olarak anlamlı olup olmadığını gösteren tam bir rapor alıyorsun.

    Python’da aynı işi yapabilirsin, ama önce birkaç kütüphane yüklemen ve veriyi hazırlaman gerekiyor. R’da regresyon, t-testi, varyans analizi gibi yöntemlerin hepsi dilin bir parçası.

    Python ile R yan yana

    PythonR
    DoğuşuGenel amaçlı programlama diliİstatistik ve veri analizi dili
    Güçlü olduğu yerYazılım geliştirme, otomasyon, makine öğrenimi, yapay zekaİstatistiksel modeller, akademik analiz, görselleştirme, raporlama
    Tablo verisipandas kütüphanesiyledata.frame dilin içinde
    İlk elemanliste[0]vektor[1]
    Atama=<-
    Tipik kullanıcıYazılımcı, veri bilimci, ML mühendisiİstatistikçi, araştırmacı, veri analisti

    Peki hangisini öğrenmeli?

    Bu bir “ya o ya bu” sorusu değil. İki dil çoğu zaman aynı ekipte, hatta aynı projede birlikte kullanılıyor.

    • Yazılım geliştirme, otomasyon ya da yapay zeka hedefliyorsan Python’la devam et; R’ı sonra ekleyebilirsin.
    • İstatistik, akademi, sağlık araştırmaları ya da anket analizi gibi alanlara yöneliyorsan R seni çok hızlandırır.
    • Veri analisti olmak istiyorsan ikisini de tanımak CV’nde fark yaratır. Hedeflediğin ilanları oku, hangi dilin istendiğine bak.

    Bir dili iyi öğrendikten sonra ikincisi çok daha kolay geliyor. Değişken, döngü, fonksiyon, tablo gibi kavramlar aynı; değişen sadece yazım. Bu yüzden R serisini Python serisiyle paralel götürüyoruz: Python’da öğrendiğin bir kavramın R’daki karşılığını görmek ikisini de pekiştirecek.

    R’ı nerede çalıştıracağım?

    Üç yol var, ikisi kurulum gerektirmiyor:

    • Google Colab: Python dersleri için kullandığımız Colab’da R da çalışıyor. Yeni bir not defteri aç, çalışma zamanı türünü R olarak değiştir.
    • Posit Cloud: RStudio’nun tarayıcıda çalışan sürümü. Ücretsiz bir hesapla başlayabilirsin.
    • R ve RStudio kurulumu: Kendi bilgisayarında çalışmak için. R Dersi 2’de adım adım anlatıyorum.

    Bu dersteki kodları şimdiden Colab’da deneyebilirsin.

    Bu derste ne öğrendik?

    • R, istatistikçiler tarafından istatistik için tasarlanmış, ücretsiz ve açık kaynaklı bir dil.
    • R’da atama <- ile yapılır, vektörler c() ile kurulur ve saymaya 1’den başlanır.
    • İşlemler bütün vektöre birden uygulanır: vektörizasyon.
    • Tablo verisi için data.frame, istatistiksel modeller için lm gibi fonksiyonlar dilin içinde.
    • Python ile R rakip değil; hedefine göre biri ya da ikisi.

    Sıradaki ders

    R Dersi 2’de R ve RStudio’yu kendi bilgisayarına kuruyoruz.

    Devamını oku

  • SQL Sorularına Hazırlık 1: SELECT, WHERE, GROUP BY ve JOIN Soru Tipleri

    SQL Sorularına Hazırlık 1: SELECT, WHERE, GROUP BY ve JOIN Soru Tipleri

    Sınav ve Mülakat Serisi 1/8

    Veri analisti, veri bilimci ya da yazılım geliştirici ilanlarının çoğunda SQL isteniyor ve teknik mülakatlarda neredeyse her zaman birkaç SQL sorusu karşına çıkıyor. Soruların biçimi farklı olsa da arkasında hep aynı birkaç kalıp var. Bu yazıda en temel dört konuyu, yani filtreleme, gruplama, tablo birleştirme ve sıralamayı, soru tiplerine ayırarak çalışacağız.

    Her soru tipinde önce kısa bir hatırlatma, sonra çözümlü bir örnek, ardından da en sık düşülen tuzak var. Yazının sonunda cevaplarıyla birlikte 10 alıştırma sorusu bulacaksın.

    Not: Buradaki soruların hiçbiri gerçek bir sınavdan ya da mülakattan alınmadı. Hepsi konuyu pekiştirmek için hazırladığım örnekler; veriler de hayali.

    SQL’in ne olduğunu ilk kez öğreniyorsan önce Veritabanı Nedir? SQL ve NoSQL Farkı yazısına göz at.

    Örnek veritabanı

    Tüm soruları iki küçük tablo üzerinden çözeceğiz. Sekiz çalışan ve dört departman var:

    calisanlar

    idaddepartman_idmaassehir
    1Ayşe152000Adana
    2Mert145000İstanbul
    3Zeynep261000İzmir
    4Can248000Adana
    5Elif339000Ankara
    6BurakNULL41000İstanbul
    7Deniz158000Ankara
    8Selin2NULLİstanbul

    departmanlar

    idad
    1Yazılım
    2Veri
    3İnsan Kaynakları
    4Pazarlama

    Dikkat: Burak’ın departmanı yok, Selin’in maaşı boş, Pazarlama’da hiç çalışan yok. Bu üç detayı bilerek koydum; soru hazırlayanlar tuzakları tam da bu tür boşluklara kurar.

    Tabloları kendin kurup sorguları denemek için bu kodu Colab’da çalıştırabilirsin. Python’un içinde gelen sqlite3 modülünü kullanıyor, kurulum gerekmiyor:

    import sqlite3
    db = sqlite3.connect(":memory:")
    db.executescript("""
    CREATE TABLE departmanlar (id INTEGER PRIMARY KEY, ad TEXT);
    CREATE TABLE calisanlar (id INTEGER PRIMARY KEY, ad TEXT, departman_id INTEGER,
    maas INTEGER, sehir TEXT);
    INSERT INTO departmanlar VALUES (1,'Yazılım'),(2,'Veri'),(3,'İnsan Kaynakları'),(4,'Pazarlama');
    INSERT INTO calisanlar VALUES
    (1,'Ayşe',1,52000,'Adana'), (2,'Mert',1,45000,'İstanbul'),
    (3,'Zeynep',2,61000,'İzmir'), (4,'Can',2,48000,'Adana'),
    (5,'Elif',3,39000,'Ankara'), (6,'Burak',NULL,41000,'İstanbul'),
    (7,'Deniz',1,58000,'Ankara'), (8,'Selin',2,NULL,'İstanbul');
    """)
    def sorgu(sql):
    for satir in db.execute(sql):
    print(satir)
    sorgu("SELECT ad, maas FROM calisanlar WHERE maas > 50000")

    Önce bir kavram: SQL hangi sırayla çalışır?

    Sorguyu SELECT ile yazmaya başlıyoruz, ama veritabanı onu başka bir sırayla çalıştırıyor:

    1. FROM ve JOIN: Hangi tablolardan?
    2. WHERE: Hangi satırlar kalsın?
    3. GROUP BY: Satırlar nasıl gruplansın?
    4. HAVING: Hangi gruplar kalsın?
    5. SELECT: Hangi sütunlar gösterilsin?
    6. ORDER BY: Nasıl sıralansın?
    7. LIMIT: Kaç satır gösterilsin?

    Bu sırayı bilmek, aşağıdaki tuzakların çoğunu açıklıyor. Örneğin WHERE gruplamadan önce çalıştığı için içinde COUNT ya da AVG kullanamazsın.

    Soru tipi 1: Filtreleme (WHERE)

    Soru: Maaşı 50.000’den yüksek olan çalışanları maaşa göre büyükten küçüğe listele.

    SELECT ad, maas
    FROM calisanlar
    WHERE maas > 50000
    ORDER BY maas DESC;
    Zeynep 61000
    Deniz 58000
    Ayşe 52000

    WHERE ile birlikte en sık kullanılanlar:

    • IN ('Adana', 'Ankara'): Listedeki değerlerden biri.
    • BETWEEN 40000 AND 55000: İki değer arasında, uçlar dahil.
    • LIKE 'A%': A ile başlayan. % herhangi sayıda karakter, _ tek bir karakter demek.
    • AND, OR, NOT: Koşulları birleştirmek. Karışık koşullarda parantez kullan.

    Tuzak: NULL eşittirle aranmaz

    Maaşı girilmemiş çalışanı bulmak isteyelim:

    SELECT ad FROM calisanlar WHERE maas = NULL; -- hiç sonuç dönmez!
    SELECT ad FROM calisanlar WHERE maas IS NULL; -- Selin

    NULL “bilinmiyor” demek. “Bilinmeyen bir şey bilinmeyen bir şeye eşit mi?” sorusunun cevabı da “bilinmiyor”, yani doğru değil. Bu yüzden NULL her zaman IS NULL ya da IS NOT NULL ile aranır. Mülakatlarda çok sevilen bir soru.

    Soru tipi 2: Gruplama (GROUP BY ve HAVING)

    Soru: Her departmandaki çalışan sayısını ve ortalama maaşı bul.

    SELECT departman_id, COUNT(*) AS kisi, ROUND(AVG(maas)) AS ort_maas
    FROM calisanlar
    GROUP BY departman_id;
    NULL 1 41000
    1 3 51667
    2 3 54500
    3 1 39000

    GROUP BY aynı departman_id‘ye sahip satırları bir araya topluyor, COUNT ve AVG gibi toplama fonksiyonları da her grup için tek bir değer hesaplıyor. Departmanı olmayan Burak, NULL adında kendi grubunu oluşturdu.

    Tuzak 1: COUNT(*) ile COUNT(sütun) aynı şey değil

    SELECT COUNT(*), COUNT(maas) FROM calisanlar; -- 8, 7

    COUNT(*) satırları sayar. COUNT(maas) ise sadece maaşı NULL olmayan satırları sayar.

    Tuzak 2: AVG boş değerleri atlar

    Veri departmanında üç kişi var ama ortalama 54.500 çıktı. Hesaplarsan: (61.000 + 48.000) / 2 = 54.500. Selin’in boş maaşı hesaba hiç katılmadı. Boş maaş sıfır sayılsaydı ortalama 36.333 olurdu. “Ortalama maaş kaç?” sorusunda bu farkı bilmek seni diğer adaylardan ayırır.

    WHERE mi, HAVING mi?

    Soru: En az 3 çalışanı olan departmanları listele.

    SELECT departman_id, COUNT(*) AS kisi
    FROM calisanlar
    GROUP BY departman_id
    HAVING COUNT(*) >= 3;
    1 3
    2 3

    Kural basit: Tek tek satırları elemek için WHERE, gruplamadan sonra grupları elemek için HAVING. WHERE COUNT(*) >= 3 yazarsan hata alırsın, çünkü WHERE çalıştığında henüz grup yok.

    Soru tipi 3: Tabloları birleştirmek (JOIN)

    Soru: Her çalışanın adını ve departmanının adını göster.

    SELECT c.ad, d.ad AS departman
    FROM calisanlar c
    INNER JOIN departmanlar d ON c.departman_id = d.id;

    Bu sorgu 7 satır döndürüyor. Burak yok! INNER JOIN sadece iki tabloda da eşleşmesi olan satırları getiriyor. Burak’ın departmanı olmadığı için elendi.

    Herkesi görmek istiyorsan LEFT JOIN kullan:

    SELECT c.ad, d.ad AS departman
    FROM calisanlar c
    LEFT JOIN departmanlar d ON c.departman_id = d.id;

    LEFT JOIN soldaki tablonun (calisanlar) bütün satırlarını getirir. Eşleşme yoksa sağdaki sütunlar NULL olur. Artık 8 satır var ve Burak’ın departmanı NULL görünüyor.

    Sorgulardaki c ve d tabloların kısa adları (alias). İki tabloda da ad sütunu olduğu için hangisini istediğimizi c.ad ve d.ad diye belirtmek zorundayız.

    Klasik soru: Eşleşmeyenleri bulmak

    Soru: Hiç çalışanı olmayan departmanları bul.

    SELECT d.ad
    FROM departmanlar d
    LEFT JOIN calisanlar c ON c.departman_id = d.id
    WHERE c.id IS NULL;
    Pazarlama

    Mülakatların en sevilen kalıplarından biri: LEFT JOIN ile her şeyi getir, sonra eşleşmesi olmayanları IS NULL ile süzgüle. “Hiç sipariş vermemiş müşteriler”, “hiç derse kaydolmamış öğrenciler” gibi soruların hepsi bu kalıpla çözülüyor.

    Tuzak: LEFT JOIN’den sonra COUNT(*)

    Her departmandaki çalışan sayısını, çalışanı olmayanlar dahil bulalım:

    -- Yanlış: Pazarlama 1 görünür
    SELECT d.ad, COUNT(*) AS kisi
    FROM departmanlar d
    LEFT JOIN calisanlar c ON c.departman_id = d.id
    GROUP BY d.ad;
    -- Doğru: Pazarlama 0 görünür
    SELECT d.ad, COUNT(c.id) AS kisi
    FROM departmanlar d
    LEFT JOIN calisanlar c ON c.departman_id = d.id
    GROUP BY d.ad;

    LEFT JOIN Pazarlama için içi NULL dolu bir satır üretiyor. COUNT(*) o satırı da sayıyor; COUNT(c.id) ise NULL olduğu için saymıyor. Tuzak 1’deki kural burada da işe yarıyor.

    Soru tipi 4: En yüksek N ve “ikinci en yüksek”

    Soru: En yüksek maaş alan 3 çalışanı bul.

    SELECT ad, maas
    FROM calisanlar
    ORDER BY maas DESC
    LIMIT 3;

    Soru: İkinci en yüksek maaşı alan çalışan kim?

    Bu sorunun iki yaygın çözümü var:

    -- 1) Sırala, birini atla, sonrakini al
    SELECT ad, maas FROM calisanlar
    ORDER BY maas DESC
    LIMIT 1 OFFSET 1;
    -- 2) En yüksekten küçük olanların en yükseği
    SELECT ad, maas FROM calisanlar
    WHERE maas < (SELECT MAX(maas) FROM calisanlar)
    ORDER BY maas DESC
    LIMIT 1;

    İkisi de Deniz’i (58.000) buluyor. Farkı şu: En yüksek maaşı iki kişi paylaşsaydı, birinci yöntem ikinci kişiyi yine en yüksek maaşla getirirdi; ikinci yöntem ise gerçekten bir alt maaş basamağını bulurdu. Mülakatta “maaşlar eşit olursa ne olur?” diye sorulması çok olası.

    İkinci yöntemdeki parantez içindeki sorguya alt sorgu deniyor. Alt sorgulara ve bu tür soruları çok daha rahat çözen pencere fonksiyonlarına serinin 5. yazısında bakacağız.

    Hepsi bir arada: çözümlü örnek

    Soru: İzmir dışındaki çalışanları dikkate al. Ortalama maaşı 45.000’den yüksek olan departmanların adını ve ortalama maaşını, büyükten küçüğe sıralayarak listele.

    Soruyu parçalara ayıralım:

    • “Departmanın adı” → iki tabloya da ihtiyacımız var: JOIN.
    • “İzmir dışındaki çalışanlar” → satır filtresi: WHERE.
    • “Departmanların ortalama maaşı” → GROUP BY ve AVG.
    • “Ortalaması 45.000’den yüksek olan” → grup filtresi: HAVING.
    • “Büyükten küçüğe” → ORDER BY ... DESC.
    SELECT d.ad, ROUND(AVG(c.maas)) AS ort
    FROM calisanlar c
    JOIN departmanlar d ON c.departman_id = d.id
    WHERE c.sehir <> 'İzmir'
    GROUP BY d.ad
    HAVING AVG(c.maas) > 45000
    ORDER BY ort DESC;
    Yazılım 51667
    Veri 48000

    Zeynep İzmir’de olduğu için WHERE onu eledi; Veri’de geriye Can ve maaşı boş Selin kaldı, ortalama 48.000 oldu. İnsan Kaynakları’nın ortalaması 39.000 olduğu için HAVING onu eledi. Burak’ın departmanı olmadığı için JOIN onu en başta dışarıda bıraktı.

    Uzun bir soruyla karşılaştığında hep böyle yap: Soruyu cümle cümle oku, her cümleyi bir SQL parçasına çevir.

    [AFFILIATE: SQL alıştırma platformu ya da SQL kursu]

    10 alıştırma sorusu

    Aynı iki tabloyu kullan. Cevaplara bakmadan önce kendin dene; Colab’daki sorgu() fonksiyonuyla sonucunu kontrol edebilirsin.

    1. İstanbul’da çalışanların adlarını listele.
    2. Maaşı 45.000 ile 55.000 arasında (uçlar dahil) olanları ada göre sırala.
    3. Adında “e” harfi geçen çalışanları bul.
    4. Departmanı olmayan kaç çalışan var?
    5. Her şehirde kaç çalışan olduğunu, kalabalıktan aza doğru sırala.
    6. En yüksek ve en düşük maaş arasındaki fark kaç?
    7. En az 2 çalışanı olan şehirlerin ortalama maaşını bul.
    8. Veri departmanındaki çalışanların adlarını listele (departman adıyla filtrele, id ile değil).
    9. Her departmandaki en yüksek maaşı departman adıyla birlikte göster.
    10. 2’den az çalışanı olan departmanları, hiç çalışanı olmayanlar dahil listele.

    Cevaplar

    -- 1) Mert, Burak, Selin
    SELECT ad FROM calisanlar WHERE sehir = 'İstanbul';
    -- 2) Ayşe 52000, Can 48000, Mert 45000
    SELECT ad, maas FROM calisanlar
    WHERE maas BETWEEN 45000 AND 55000
    ORDER BY ad;
    -- 3) Ayşe, Deniz, Elif, Mert, Selin, Zeynep
    -- Not: Elif büyük E ile başlıyor. SQLite'ta LIKE, İngilizce harflerde
    -- büyük-küçük harf ayırmaz; bazı veritabanlarında ayırır.
    SELECT ad FROM calisanlar WHERE ad LIKE '%e%';
    -- 4) 1
    SELECT COUNT(*) FROM calisanlar WHERE departman_id IS NULL;
    -- 5) İstanbul 3, Adana 2, Ankara 2, İzmir 1
    SELECT sehir, COUNT(*) AS kisi FROM calisanlar
    GROUP BY sehir
    ORDER BY kisi DESC;
    -- 6) 22000 (61000 - 39000; Selin'in boş maaşı hesaba girmez)
    SELECT MAX(maas) - MIN(maas) AS fark FROM calisanlar;
    -- 7) Adana 50000, Ankara 48500, İstanbul 43000
    -- (İstanbul'da 3 kişi var ama Selin'in maaşı boş; ortalama Mert ve Burak'tan)
    SELECT sehir, ROUND(AVG(maas)) AS ort FROM calisanlar
    GROUP BY sehir
    HAVING COUNT(*) >= 2
    ORDER BY ort DESC;
    -- 8) Can, Selin, Zeynep
    SELECT c.ad FROM calisanlar c
    JOIN departmanlar d ON c.departman_id = d.id
    WHERE d.ad = 'Veri';
    -- 9) Veri 61000, Yazılım 58000, İnsan Kaynakları 39000
    SELECT d.ad, MAX(c.maas) AS en_yuksek FROM departmanlar d
    JOIN calisanlar c ON c.departman_id = d.id
    GROUP BY d.ad
    ORDER BY en_yuksek DESC;
    -- 10) İnsan Kaynakları 1, Pazarlama 0
    SELECT d.ad, COUNT(c.id) AS kisi FROM departmanlar d
    LEFT JOIN calisanlar c ON c.departman_id = d.id
    GROUP BY d.ad
    HAVING COUNT(c.id) < 2;

    Bu yazıdan aklında kalması gerekenler

    • NULL eşittirle değil, IS NULL ile aranır.
    • COUNT(*) satırları, COUNT(sütun) dolu değerleri sayar. AVG boşları atlar.
    • Satır filtresi WHERE, grup filtresi HAVING.
    • INNER JOIN eşleşmeyenleri eler, LEFT JOIN soldaki herkesi tutar.
    • “Hiç … olmayanlar” sorusu: LEFT JOIN + IS NULL.
    • “İkinci en yüksek” sorusunda eşit değerleri düşün.

    Serinin bir sonraki yazısında başka bir konunun soru tiplerine geçiyoruz. SQL’in devamı, yani alt sorgular ve pencere fonksiyonları, 5. yazıda.

    Devamını oku