Bir diziyi bitirdin, ekranın altında hemen “Bunu sevdiysen bunları da izle” listesi beliriyor. Bu listeyi hazırlayan şey bir öneri sistemi. Gerçek platformların öneri sistemleri milyonlarca kullanıcının verisiyle çalışıyor ve çok karmaşık. Ama temel fikir, birkaç satır Python’la kurulabilecek kadar sade.
Bu yazıda 20 dizilik küçük bir katalogla kendi öneri sistemimizi yazıyoruz. Python Dersi 12’de öğrendiğimiz kümeler burada ana malzeme olacak.
Kodların hepsi Colab’da hazır: Colab’da Aç
Veri hakkında: Katalogdaki dizi adları gerçek, ama etiketleri ben verdim; öznel ve eksik olabilirler. Netflix’in verisi, görselleri ya da logosu kullanılmıyor. Bu sistem Netflix’in kendi öneri sistemini taklit etmiyor, sadece öneri sistemlerinin temel fikrini gösteriyor.
Öneri sistemleri nasıl çalışır?
İki temel yaklaşım var:
- İçerik tabanlı öneri: “Bu dizi bilim kurgu ve gizem, sen de bilim kurgu ve gizem seviyorsun, o zaman bunu da seversin.” İçeriğin özelliklerine bakıyor.
- İşbirlikçi filtreleme: “Seninle benzer şeyleri izleyen kişiler şunu da izledi.” İçeriğe hiç bakmadan, kullanıcıların davranışlarına bakıyor.
Büyük platformlar ikisini ve daha fazlasını birlikte kullanıyor. Bizim elimizde kullanıcı verisi olmadığı için birincisini kuracağız.
1. Katalog: her dizi bir etiket kümesi
Her diziyi birkaç etiketten oluşan bir küme olarak tanımlayalım. Toplam 20 dizi var; birkaçını gösterelim:
KATALOG = { "Stranger Things": {"bilim kurgu", "korku", "gençlik", "80'ler", "gizem"}, "Dark": {"bilim kurgu", "gizem", "zaman yolculuğu", "aile", "Almanya"}, "Black Mirror": {"bilim kurgu", "teknoloji", "antoloji", "distopya"}, "Squid Game": {"gerilim", "hayatta kalma", "Kore", "distopya"}, "The Crown": {"drama", "tarih", "biyografi", "gerçek hikâye"}, # ... toplam 20 dizi, tam liste not defterinde}
Neden liste değil de küme? Çünkü birazdan iki dizinin ortak etiketlerini bulacağız, bu da tam olarak bir küme kesişimi.
2. İki dizi ne kadar benziyor? Jaccard benzerliği
Dark ile Stranger Things’i karşılaştıralım:
- Ortak etiketler (
&, kesişim): bilim kurgu, gizem → 2 - İkisindeki bütün farklı etiketler (
|, birleşim): 8
İki sayıyı birbirine bölünce 2 / 8 = 0,25 çıkıyor. Bu orana Jaccard benzerliği deniyor. 0 hiç ortak etiket yok, 1 tamamen aynı demek.
def jaccard(a, b): """İki kümenin ortak eleman sayısının, toplam farklı eleman sayısına oranı.""" return len(a & b) / len(a | b)print(jaccard(KATALOG["Dark"], KATALOG["Stranger Things"])) # 0.25
Neden sadece ortak etiket sayısına bakmıyoruz da birleşime bölüyoruz? Çünkü çok etiketi olan bir dizi, sadece etiketi çok diye her şeye “benzer” çıkmasın. Bölme işlemi bunu dengeliyor.
3. “Bunu sevdiysen” önerileri
Bir diziyi katalogdaki diğer bütün dizilerle karşılaştırıp en benzer beşini sıralayalım:
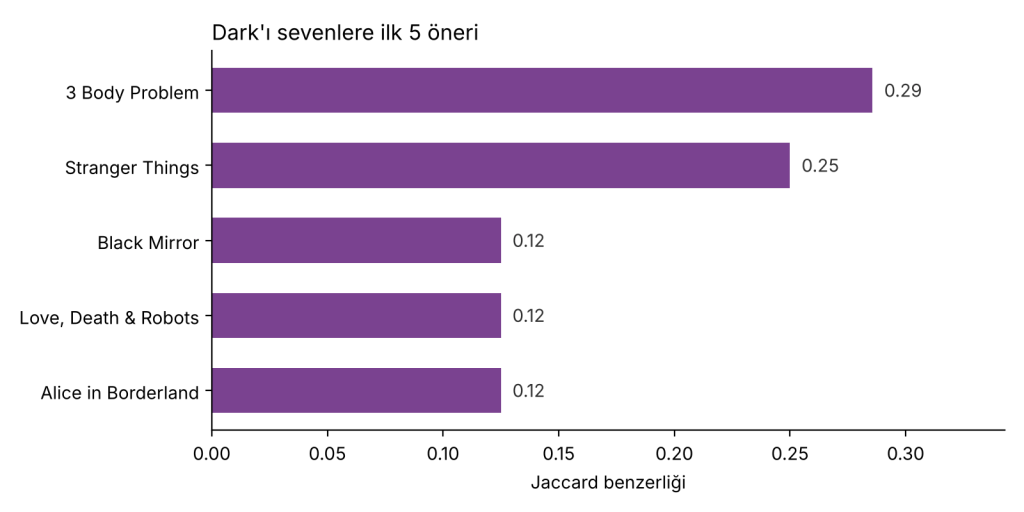
def benzerleri(dizi, n=5): hedef = KATALOG[dizi] puanlar = {d: jaccard(hedef, etiket) for d, etiket in KATALOG.items() if d != dizi} return sorted(puanlar.items(), key=lambda x: -x[1])[:n]for ad, puan in benzerleri("Dark"): print(f"{ad:<22} {puan:.2f}")
3 Body Problem 0.29Stranger Things 0.25Black Mirror 0.12Love, Death & Robots 0.12Alice in Borderland 0.12
Sözlük üreteci (Ders 12) her diziye bir puan veriyor; sorted ve key=lambda x: -x[1] de puana göre büyükten küçüğe sıralıyor. Squid Game için ilk sırada Alice in Borderland (0,33), The Crown için Narcos (0,60) çıkıyor.
4. Birden fazla diziden zevk profili çıkarmak
Tek bir diziye bakmak yerine sevdiğin birkaç diziden bir zevk profili çıkaralım. Kod Kartı #07’deki Counter burada işe yarıyor: Sevdiğin dizilerin etiketlerini sayıyoruz, sonra her diziye etiketlerinin bu profildeki toplam ağırlığına göre puan veriyoruz.
from collections import Counterdef profil_oner(begenilenler, n=5): profil = Counter() for dizi in begenilenler: profil.update(KATALOG[dizi]) puanlar = { d: sum(profil[e] for e in etiket) / len(etiket) for d, etiket in KATALOG.items() if d not in begenilenler } return profil, sorted(puanlar.items(), key=lambda x: -x[1])[:n]profil, oneriler = profil_oner(["Dark", "Black Mirror", "Mindhunter"])
Love, Death & Robots 1.003 Body Problem 0.75Ozark 0.75Stranger Things 0.60Squid Game 0.50
Bu üç dizide “bilim kurgu” iki kez geçtiği için profilde en ağır etiket o. Love, Death & Robots’un dört etiketinden üçü (bilim kurgu, teknoloji, antoloji) profilde var ve ilk sıraya yerleşiyor.
Sistemimiz nerede yanılıyor?
Sonuçlara dikkatli bakınca sistemin zayıf yanları hemen görünüyor. Bunlar gerçek öneri sistemlerinin de uğraştığı sorunlar:
- Etiketler kaba. The Crown’ı sevene ilk öneri Narcos, çünkü ikisi de “drama, biyografi, gerçek hikâye”. Ama bir kraliyet ailesi dramını seven herkes uyuşturucu kartellerini anlatan bir diziyi sevmeyebilir. İçerik tabanlı bir sistem, verdiğin etiketler kadar akıllı.
- Tek bir etiket fazla ağır basabiliyor. Profil örneğinde Ozark üçüncü sırada; sebeplerinden biri Dark’tan gelen “aile” etiketi. Oysa Dark’ı sevmemizin sebebi muhtemelen aile değil, zaman yolculuğu.
- Eşitlikler. Dark için üç dizi aynı puanda (0,12). Aralarındaki sırayı sadece katalogdaki yazım sırası belirliyor.
- Hep aynı şeyler. Sadece benzer içerik öneren bir sistem, seni bilim kurgu dışına hiç çıkarmayabilir. Buna filtre balonu deniyor.
- Yeni dizi sorunu. Henüz etiketlenmemiş bir dizi hiç önerilmez. İşbirlikçi filtrelemede de benzer bir sorun var: Kimsenin izlemediği yeni bir dizi için davranış verisi yok. Buna soğuk başlangıç (cold start) sorunu deniyor.
Kendin dene
- Kataloğa sevdiğin üç diziyi kendi etiketleriyle ekle ve
profil_onerile kendine öneri al. - The Crown için Narcos neden en benzer çıkıyor? Etiketleri değiştirerek bunu düzelt.
profil_oneriçinde etiket sayısına bölmeyi kaldır. Sonuçlar nasıl değişiyor, neden?- Jaccard yerine sadece ortak etiket sayısını (
len(a & b)) kullan ve sonuçları karşılaştır.
Bu projede ne öğrendik?
- Öneri sistemlerinin iki temel yaklaşımı: içerik tabanlı ve işbirlikçi filtreleme.
- Kümelerle iki öğenin benzerliğini Jaccard oranıyla ölçmek.
- Birden fazla beğeniden
Counterile bir profil çıkarmak. - Bir modelin sonuçlarına bakıp zayıf yanlarını bulmak: kaba etiketler, filtre balonu, soğuk başlangıç.
Bir yanıt yazın