
Pekiştirmeli öğrenme (reinforcement learning, RL) üzerine okudukça hep aynı şeyi hissettim: kavramlar bir tahtada anlatılınca anlaşılıyor, ama kendi ortamını kurmadan oturmuyor. Bu yüzden hazır bir oyun almak yerine klasik Yılan oyununu sıfırdan, Gymnasium ortamı olarak yazdım ve bir ajana oynamayı öğrettim.
Bu yazıda şunlar var:
- RL’nin temel kavramları, bu oyun üzerinden
- Gymnasium ile özel bir ortam yazmak: gözlem, eylem ve ödül tasarımı
- İki kıyas çizgisi: rastgele oynayan ajan ve elle yazılmış kuralları izleyen ajan
- Tablo tabanlı Q-learning ve ilk denemede neden kurallı ajanı geçemediği
- Gözleme üç bilgi ekleyince ortalama skorun nasıl %57 arttığı
Sonucu en başta söyleyeyim: 10×10’luk tahtada rastgele oynayan ajan ortalama 0,2 yem yiyebildi, elle yazılmış kurallar 19,1 yem, eğittiğim son ajan ise 27,6 yem. Kodun tamamı Colab’da hazır ve sadece numpy ile gymnasium kullanıyor: Colab’da Aç

RL’nin dört kelimesi, bu oyun üzerinden
Pekiştirmeli öğrenme, bir köpeğe numara öğretmeye benzer. Köpeğe “otur” dediğinde ne yapacağını kelimelerle anlatamazsın; doğru bir şey yaptığında bir ödül maması verirsin. Köpek zamanla hangi davranışın mama getirdiğini kendisi çözer. Yılan oyununda da kimse yılana “şöyle oyna” demiyor: binlerce oyun oynuyor ve hangi durumda hangi hamlenin puan getirdiğini deneme yanılmayla öğreniyor.
RL’de bir ajan, bir ortamla tekrar tekrar etkileşime girerek ne yapması gerektiğini kendisi bulur. Kimse ona doğru cevabı göstermez; sadece yaptığı şeyin sonucunda bir puan alır. Yılan oyununda bu döngü şöyle işliyor:
| Kavram | Genel tanım | Yılan oyununda |
|---|---|---|
| Durum (state) | Ajanın o an dünyayı nasıl gördüğü | Önüm dolu mu, yem hangi tarafta, hangi yöne gidiyorum |
| Eylem (action) | Ajanın seçebileceği hamleler | Düz git, sağa dön, sola dön |
| Ödül (reward) | Her hamleden sonra gelen puan | Yem +10, çarpıp ölmek −10 |
| Politika (policy) | “Bu durumda şunu yap” kuralı | Eğitimin sonunda öğrenilen şey |
Ajanın amacı tek bir hamlede değil, oyunun sonuna kadar toplayacağı toplam ödülü büyütmek. Bu yüzden bazen hemen ödül getirmeyen bir hamleyi seçmesi gerekiyor: yeme doğrudan gitmek yerine önce kendine yer açmak gibi.
Kısmi görüş: ajan tahtayı görmüyor
Burada küçük ama önemli bir tasarım kararı var. Ajanın tahtanın tamamını görmesini sağlayabilirdim (10×10 = 100 kare, her biri boş, gövde ya da yem). Ama o zaman olası durum sayısı astronomik olur ve basit bir tablo ile öğrenmek imkânsızlaşır. Bunun yerine ajana birkaç özet bilgi veriyorum. Bu, matematiksel olarak tam bir MDP (Markov karar süreci) yerine kısmi gözlemli bir problem (POMDP) demek: ajan, kararlarını etkileyen her şeyi göremiyor. Yazının ikinci yarısında bunun bedelini somut olarak göreceğiz.
Ortamı kurmak: Gymnasium ile kendi oyununu yazmak
Gymnasium, RL ortamları için standart bir arayüz. Bir ortamın bu arayüze uyması için dört şey yeterli:
action_space: Ajan hangi eylemleri seçebilir?observation_space: Ajan ne görür?reset(): Yeni bir oyun başlatır, ilk gözlemi döndürür.step(eylem): Bir hamle oynatır ve beş şey döndürür: yeni gözlem, ödül, oyun bitti mi (terminated), oyun yarıda kesildi mi (truncated), ek bilgi.
Bu arayüze uyunca, ileride hazır bir algoritma kütüphanesini (örneğin Stable-Baselines3) ortamı hiç değiştirmeden kullanabiliyorsun.
Bunu bir prize benzetebilirsin. Priz standart olduğu için hangi cihazı alırsan al, takıp çalıştırabilirsin. Oyunumuzu Gymnasium kalıbına uygun yazınca da başkalarının yazdığı hazır öğrenme algoritmaları bu oyuna hiçbir değişiklik yapmadan “takılabiliyor”.
Tasarım kararları
Eylemler göreceli. “Yukarı, aşağı, sağ, sol” yerine “düz, sağa dön, sola dön” kullandım. Böylece yılanın kendi üstüne geri dönmesi gibi anlamsız bir hamle hiç mümkün olmuyor ve ajanın öğrenmesi gereken bir hata ortadan kalkıyor.
Gözlem 11 evet/hayır bilgisi. Önüm/sağım/solum tehlikeli mi (3), hangi yöne gidiyorum (4), yem solda/sağda/yukarıda/aşağıda mı (4). 11 bit, 2¹¹ = 2048 olası durum demek; bu, basit bir tabloya sığan bir sayı.
Ödül şekillendirme (reward shaping). Yem +10, ölüm −10. Bunlar seyrek ödüller: ajan ilk başta rastgele dolaşırken yeme çok nadir denk gelir. Öğrenmeyi hızlandırmak için yeme yaklaşan her adıma +0,1, uzaklaşana −0,1 ekledim. Bu seçimin gerçekten işe yarayıp yaramadığını aşağıda ayrıca test ediyorum.
Bunu saklambaçtaki “sıcak, soğuk” ipuçlarına benzetebilirsin: çocuk saklanan kişiye yaklaştıkça “ısınıyorsun” deriz ki rastgele dolaşmasın.
Sonsuz döngü koruması. Ajan bazen ölmeden aynı yerde daireler çizmeyi öğreniyor; bu da ölüm cezasından kaçmanın bir yolu. Uzun süre yem yemezse oyun truncated olarak kesiliyor.
Kod
import numpy as npimport gymnasium as gymfrom gymnasium import spaces# Yönler: 0 sağ, 1 aşağı, 2 sol, 3 yukarı (saat yönünde sıralı)YONLER = [(1, 0), (0, 1), (-1, 0), (0, -1)]class YilanOyunu(gym.Env): def __init__(self, boyut=10, yakinlik_odulu=0.1, alan_bilgisi=False): super().__init__() self.boyut = boyut self.yakinlik_odulu = yakinlik_odulu self.alan_bilgisi = alan_bilgisi # True: 3 "sıkışır mıyım?" bilgisi daha ekle self.action_space = spaces.Discrete(3) # 0 düz, 1 sağa dön, 2 sola dön self.observation_space = spaces.MultiBinary(14 if alan_bilgisi else 11) def _carpar_mi(self, nokta): x, y = nokta duvar = not (0 <= x < self.boyut and 0 <= y < self.boyut) kendine = nokta in self.govde_kume and nokta != self.govde[-1] # kuyruk o adımda çekilir return duvar or kendine def _ileri(self, yon): dx, dy = YONLER[yon] x, y = self.govde[0] return (x + dx, y + dy) def _gozlem(self): bas = self.govde[0] sag, sol = (self.yon + 1) % 4, (self.yon - 1) % 4 g = [ self._carpar_mi(self._ileri(self.yon)), self._carpar_mi(self._ileri(sag)), self._carpar_mi(self._ileri(sol)), self.yon == 0, self.yon == 1, self.yon == 2, self.yon == 3, self.yem[0] < bas[0], self.yem[0] > bas[0], self.yem[1] < bas[1], self.yem[1] > bas[1], ] # alan_bilgisi=True ise buraya 3 bilgi daha eklenir (aşağıda) return np.array(g, dtype=np.int8) def reset(self, seed=None, options=None): super().reset(seed=seed) # self.np_random'ı tohumlar o = self.boyut // 2 self.govde = [(o, o), (o - 1, o), (o - 2, o)] # baş en başta self.govde_kume = set(self.govde) self.yon, self.skor, self.ac_adim = 0, 0, 0 self._yem_koy() return self._gozlem(), {"skor": 0} def step(self, eylem): if eylem == 1: self.yon = (self.yon + 1) % 4 elif eylem == 2: self.yon = (self.yon - 1) % 4 once = self._uzaklik() yeni_bas = self._ileri(self.yon) self.ac_adim += 1 if self._carpar_mi(yeni_bas): return self._gozlem(), -10.0, True, False, {"skor": self.skor} self.govde.insert(0, yeni_bas) self.govde_kume.add(yeni_bas) if yeni_bas == self.yem: self.skor += 1 self.ac_adim = 0 odul = 10.0 self._yem_koy() else: self.govde_kume.discard(self.govde.pop()) # kuyruk bir kare çekilir odul = self.yakinlik_odulu if self._uzaklik() < once else -self.yakinlik_odulu kesildi = self.ac_adim > 100 * len(self.govde) # sonsuz dönmeyi engelle return self._gozlem(), odul, False, kesildi, {"skor": self.skor}
Not defterinde _yem_koy, _uzaklik, tahtayı metin olarak çizen render ve tahta tamamen dolunca oyunu kazandıran kontrol de var; yer kaplamasın diye burada göstermedim.
Ortamı yazdıktan sonra ilk iş Gymnasium’un kendi kontrol aracını çalıştırmak:
from gymnasium.utils.env_checker import check_envcheck_env(YilanOyunu(), skip_render_check=True) # hata vermezse arayüz doğru
Bu araç gözlemin observation_space ile uyuşup uyuşmadığını, reset‘in tohumla tekrar üretilebilir olup olmadığını ve step‘in doğru sayıda değer döndürüp döndürmediğini kontrol ediyor. Benim ortamım sorunsuz geçti.
Bunu prizin test cihazı gibi düşünebilirsin: cihazı takmadan önce prizin kurallara uygun bağlandığını kontrol ediyor.
Kıyas çizgileri: önce kimi geçmesi gerekiyor?
Bir RL ajanının “iyi” olup olmadığını tek başına skoruna bakarak söyleyemezsin. 20 yem iyi mi, kötü mü? Bu yüzden eğitime başlamadan önce iki kıyas çizgisi kurdum:
- Rastgele ajan: Her adımda üç eylemden birini rastgele seçer. Alt sınır.
- Kural tabanlı ajan: Benim elle yazdığım basit bir kural: “Tehlikeli olmayan yönler arasından yeme yaklaştıranı seç.” RL’nin bunu geçemiyorsa, o problem için RL’ye gerek yok demektir.
def kural_ajani(gozlem, rng): """Tehlikeli olmayan yönler arasından yeme yaklaştıranı seç.""" on, sag, sol = gozlem[0], gozlem[1], gozlem[2] yon = int(np.argmax(gozlem[3:7])) # 0 sağ, 1 aşağı, 2 sol, 3 yukarı yem_sol, yem_sag, yem_yukari, yem_asagi = gozlem[7:11] istenen = [] # yeme götüren mutlak yönler if yem_sag: istenen.append(0) if yem_asagi: istenen.append(1) if yem_sol: istenen.append(2) if yem_yukari: istenen.append(3) adaylar = [] for eylem, tehlike, yeni_yon in [(0, on, yon), (1, sag, (yon + 1) % 4), (2, sol, (yon - 1) % 4)]: if not tehlike: adaylar.append((yeni_yon in istenen, eylem)) if not adaylar: return 0 # her yer dolu: düz git ve kaybet adaylar.sort(reverse=True) # yeme götürenler öne return adaylar[0][1]
Her ajanı 300 oyunda, her seferinde aynı tohumlarla (aynı yem sıralarıyla) oynattım:
| Ajan | Ortalama yem | Medyan | En iyi oyun |
|---|---|---|---|
| Rastgele | 0,16 | 0 | 2 |
| Kural tabanlı | 19,13 | 19 | 37 |
Rastgele ajan neredeyse hiç yem yiyemiyor; çoğu oyunda birkaç adımda duvara çarpıyor. Basit kural ise şaşırtıcı derecede iyi. Çıtayı bu belirliyor: eğittiğim ajanın 19’u geçmesi lazım.
Q-learning: bir tablo ve bir güncelleme kuralı
Q-learning’in fikri şu: her durum ve her eylem için bir sayı tut. Bu sayı, “bu durumda bu eylemi yaparsam, oyunun sonuna kadar toplam ne kadar ödül beklerim?” sorusunun tahmini. Adı Q değeri. Ajan her durumda Q değeri en yüksek eylemi seçer.
Bizim durumda tablo 2048 satır (durum) ve 3 sütundan (eylem) oluşuyor. Başta hepsi sıfır. Her hamleden sonra oynanan hücre şu kuralla güncelleniyor:
Bunu kocaman bir not defteri gibi düşün. Her satırda bir durum yazıyor (örneğin “önüm boş, yem solumda”), yanında üç hamlenin puan tahmini var. Başta bütün puanlar sıfır, ajan hiçbir şey bilmiyor. Her hamleden sonra ne olduğuna bakıp o satırdaki puanı biraz güncelliyor: sola dönünce yem yediyse “bu durumda sola dönmek iyiymiş” diye not alıyor. Binlerce oyundan sonra not defteri doluyor ve ajan her durumda puanı en yüksek hamleyi seçiyor.
Q[s, a] ← Q[s, a] + α · ( r + γ · max Q[s', ·] − Q[s, a] )
r + γ · max Q[s', ·]hedef: az önce aldığın ödül artı yeni durumdan beklenen en iyi gelecek. Bu, Bellman denkleminden geliyor.γ(gama, 0,9) geleceğe ne kadar önem verdiğin. 0 olsa ajan sadece o anki ödüle bakardı.α(alfa, 0,1) öğrenme hızı: tahmini hedefe doğru ne kadar kaydırdığın.
Keşif mi, bildiğini mi?
Ajan hep en iyi bildiği eylemi seçerse, başta sıfırlarla dolu tablo yüzünden hiçbir şey keşfedemez. Çözüm ε-açgözlü (epsilon-greedy) politika: ε olasılıkla rastgele bir eylem, geri kalanında en iyi bilinen eylem. ε 1’den başlıyor ve her oyundan sonra %0,5 azalıyor; yaklaşık 900 oyundan sonra en alt değerine (0,01) iniyor. Yani ajan başta keşfediyor, zamanla öğrendiğini kullanıyor.
Yeni bir şehre taşındığını düşün. İlk haftalarda farklı sokaklardan gidip gelirsin, sonra en kısa yolu bulunca hep onu kullanırsın. Ama ara sıra yine yeni bir sokak denersin, belki daha kısası vardır. ε-açgözlü politika tam olarak bu dengeyi kuruyor.
def q_ogren(env, bolum=5000, alfa=0.1, gama=0.9, eps_bas=1.0, eps_son=0.01, eps_azalma=0.995, tohum=0): rng = np.random.default_rng(tohum) Q = np.zeros((2 ** env.observation_space.n, 3)) eps = eps_bas gecmis = [] for b in range(bolum): g, _ = env.reset(seed=tohum + b) s = durum_no(g) # 11 biti tek bir tamsayıya çevir bitti = kesildi = False while not (bitti or kesildi): if rng.random() < eps: a = int(rng.integers(3)) # keşif else: a = int(np.argmax(Q[s])) # bildiğini kullan g, r, bitti, kesildi, bilgi = env.step(a) s2 = durum_no(g) hedef = r if bitti else r + gama * np.max(Q[s2]) # Bellman hedefi Q[s, a] += alfa * (hedef - Q[s, a]) s = s2 eps = max(eps_son, eps * eps_azalma) gecmis.append(bilgi["skor"]) return Q, np.array(gecmis)def durum_no(gozlem): """[1,0,0,1,...] gibi bitleri tek bir sayıya çevirir: tablonun satır numarası.""" return int("".join(map(str, gozlem)), 2)
Oyun bittiğinde (bitti) geleceği hesaba katmıyoruz, çünkü ölümden sonra gelecek yok. Ama oyun süre yüzünden kesildiğinde (kesildi) katıyoruz: ajan ölmedi, sadece biz durdurduk. Gymnasium’un terminated ve truncated‘ı ayrı tutmasının sebebi tam olarak bu.
İlk sonuç: kuralları geçemedi
5.000 oyunluk eğitim yaklaşık 10 saniye sürdü. Sonucun şansa bağlı olmadığını görmek için eğitimi üç farklı tohumla tekrarlayıp her ajanı 300’er oyunda test ettim:
| Ajan | Ortalama yem | Medyan | En iyi oyun |
|---|---|---|---|
| Kural tabanlı | 19,13 | 19 | 37 |
| Q-ajan (11 bilgi) | 17,65 | 17 | 47 |
Q-ajan bazı oyunlarda kurallı ajandan çok daha uzun yaşıyor (en iyi oyun 47), ama ortalamada geride. Üç tohumun ortalamaları 17,7, 17,4 ve 17,9; yani bu bir şans meselesi değil.
Benim tahminim şuydu: yılan uzadıkça kendi gövdesinin oluşturduğu bir “çuval”ın içine giriyor, çıkışı kalmayınca ölüyor. 11 bilgi bunu görmesine izin vermiyor: sadece bir kare ötesini biliyor. Bu tahmini bir sonraki bölümde test ediyorum. Ayrıca tablo değerlerine baktığımda 2048 durumun sadece 256’sının ziyaret edildiğini gördüm. Çünkü kombinasyonların çoğu imkânsız: yılan aynı anda iki yöne gidemez, yem de aynı anda hem solda hem sağda olamaz. Yani asıl sınır tablonun boyutu değil, ajanın neyi görebildiği.
Ödül şekillendirme işe yaradı mı?
Yaklaşma/uzaklaşma ödülünü kapatıp aynı eğitimi tekrarladım (tek tohum, 200 test oyunu). Şekillendirmeli ajan 16,7, şekillendirmesiz ajan 17,6 ortalama yem yedi. Öğrenme eğrileri de neredeyse üst üste. Bu ortamda şekillendirmenin anlamlı bir farkı olmadı: yem gözlemde zaten görünür olduğu için ajan seyrek ödül sorunuyla pek karşılaşmıyor. Bunu “her zaman şekillendir” kuralı yerine “test et, sonra karar ver” diye not ettim.
Basitçe söylersek: “sıcak, soğuk” ipuçları bu oyunda gereksizdi, çünkü ajan yemin hangi tarafta olduğunu zaten görebiliyordu. Saklanan kişiyi zaten gören birine “ısınıyorsun” demek bir şey katmaz.
Ajana “sıkışır mıyım?” diye sormayı öğretmek
Tahminimi test etmek için gözleme üç bilgi daha ekledim: düz, sağa ya da sola gidersem, gideceğim kareden ulaşabileceğim boş alan gövdemden küçük mü? Küçükse o yön bir tuzak: oraya girersem er geç kendi kuyruğuma sıkışırım.
Günlük hayattan düşünürsek: ilk ajan bir sokakta sadece önündeki adıma bakıyordu, sokak çıkmaz mı değil mi bilmiyordu. Yeni bilgi ona “bu sokak çıkmaz” levhasını gösteriyor.
Bu bilgiyi hesaplamak için taşma doldurma (flood fill) algoritmasını kullandım. Paint programlarındaki boya kovası da aynı şeyi yapar: bir kareden başlar, duvara ya da gövdeye çarpana kadar komşu kareleri tek tek boyar ve kaç kare boyadığını sayar.
def _serbest_alan(self, baslangic): """O kareden başlayıp kaç boş kareye ulaşılabilir? (taşma doldurma / flood fill)""" engel = set(self.govde[:-1]) # kuyruk bir sonraki adımda çekileceği için hariç gorulen, yigin = {baslangic}, [baslangic] while yigin: x, y = yigin.pop() for dx, dy in YONLER: n = (x + dx, y + dy) if n not in gorulen and n not in engel and 0 <= n[0] < self.boyut and 0 <= n[1] < self.boyut: gorulen.add(n) yigin.append(n) return len(gorulen)# _gozlem() içinde, alan_bilgisi=True ise:for yon in (self.yon, sag, sol): hedef = self._ileri(yon) g.append(not self._carpar_mi(hedef) and self._serbest_alan(hedef) < len(self.govde))
Gözlem 11 bitten 14 bite çıktı, tablo 2.048 satırdan 16.384 satıra. Q-learning kodunda tek bir satır bile değişmedi; tablo boyutu env.observation_space.n‘den okunduğu için kendiliğinden büyüdü. Ortamı Gymnasium arayüzüne uydurmanın faydası burada görünüyor.
Grafik nasıl okunur? Yatay eksen ajanın kaçıncı eğitim oyununda olduğunu, dikey eksen o dönemde oyun başına ortalama kaç yem yediğini gösteriyor. Gri çizgi ilk ajan, mavi çizgi “sıkışır mıyım?” bilgisi verilen ajan. Kesikli yatay çizgi de elle yazdığım basit kuralın skoru, yani geçilmesi gereken çıta.
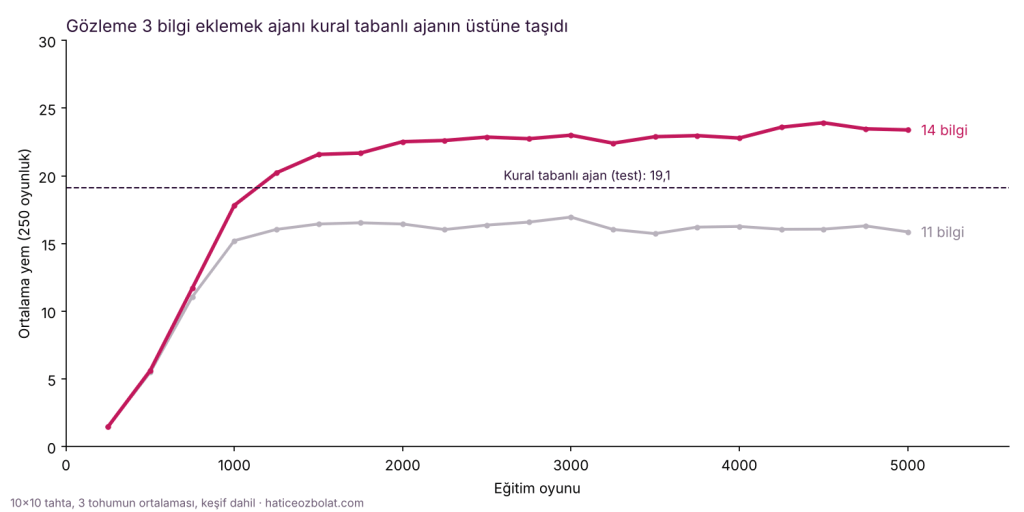
Grafikteki değerler eğitim sırasındaki ortalamalar; ajan hâlâ arada rastgele hamle yaptığı için test skorlarından biraz düşük. İlk 750 oyunda iki ajan aynı hızla öğreniyor, çünkü yılan kısayken sıkışma riski yok. Yılan uzamaya başladığında 11 bilgili ajan 16 civarında duruyor, 14 bilgili ajan ise yükselmeye devam ediyor.
Bedeli hız: taşma doldurma her adımda üç kez çalıştığı için eğitim yaklaşık 10 saniyeden 2,5-3 dakikaya çıktı.
Sonuçlar
Eğitimden sonra keşif kapalı (ε = 0) her ajanı 300 oyunda test ettim. Q-ajanları için bu, üç tohumun her biri için 300 oyun, toplam 900 oyun demek.
| Ajan | Ortalama yem | Medyan | En iyi oyun | Standart sapma |
|---|---|---|---|---|
| Rastgele | 0,16 | 0 | 2 | 0,4 |
| Kural tabanlı | 19,13 | 19 | 37 | 5,8 |
| Q-ajan (11 bilgi) | 17,65 | 17 | 47 | 6,2 |
| Q-ajan (14 bilgi) | 27,64 | 28 | 47 | 7,9 |
14 bilgili ajan kural tabanlı ajandan ortalamada %44, 11 bilgili Q-ajandan %57 daha fazla yem yedi. Üç tohumun ortalamaları 27,5, 27,7 ve 27,7; sonuç tutarlı.
Bir uyarı: kural tabanlı ajana bu üç yeni bilgiyi vermedim. Ona da “tuzak olan yöne gitme” kuralı eklense farkın bir kısmı kapanabilir. Bu yüzden sonucu “RL kurallardan iyidir” diye değil, “ajanın ne gördüğü, hangi algoritmayı kullandığından daha çok fark yarattı” diye okuyorum.
Bu projeden öğrendiklerim
- Önce kıyas çizgisi. Kurallı ajanı yazmasaydım 17,65’lik ilk ajanı başarılı sanacaktım. Basit bir kuralı geçemeyen bir RL ajanı, çözüm değil.
- Gözlem tasarımı algoritmadan önce gelir. Q-learning kodunda hiçbir şey değiştirmeden, sadece ajanın gördüğü bilgiyi zenginleştirerek en büyük artışı aldım.
- Tek tohum yetmez. RL sonuçları rastgelelikten çok etkilenir. Üç tohum henüz az ama hiç yoktan iyi.
- Her “iyi bilinen” teknik test edilmeli. Ödül şekillendirme bu ortamda fark yaratmadı.
- Eğitim skoru ile test skoru farklıdır. Eğitim sırasında ajan keşif için arada rastgele hamle yaptığı için skorlar daha düşük görünür.
Sınırlar ve sonraki adımlar
Not defteri yöntemi küçük problemlerde işe yarıyor, ama ajan tahtanın tamamını görseydi o kadar çok farklı durum olurdu ki hiçbir deftere sığmazdı. Bu yüzden bir sonraki adımda not defteri yerine, daha önce görmediği durumlar için de tahmin yapabilen bir yapay sinir ağı kullanacağım.
- Tablo büyüyünce çöküyor. Ajan tahtanın tamamını görseydi durum sayısı tabloya sığmazdı. Bir sonraki adım, tablo yerine bir sinir ağı kullanan DQN (Deep Q-Network): tahtayı bir görüntü gibi alıp Q değerlerini tahmin eden bir model.
- Hazır kütüphane. Ortam Gymnasium arayüzüne uyduğu için Stable-Baselines3 ile PPO ya da DQN’i birkaç satırda deneyebilirim.
- Yılan hâlâ kendini sıkıştırıyor. 14 bilgi sadece bir adım sonrasını kontrol ediyor. Kuyruğunu takip etme gibi daha uzun vadeli stratejiler henüz öğrenilmedi; en iyi oyun hâlâ 47 yemde, 100 karelik tahtanın yarısında bitiyor.
Bir yanıt yazın