
Hogwarts’a gelen her öğrenci başına eski bir şapka takıyor ve şapka birkaç saniye içinde karar veriyor: Gryffindor, Ravenclaw, Hufflepuff ya da Slytherin. Bir veri bilimci gözüyle bakınca Seçmen Şapkası aslında bir sınıflandırma modeli: girdi olarak bir öğrenciyi alıyor, çıktı olarak dört etiketten birini veriyor.
Bu yazıda kendi şapkamızı iki kez kuracağız. Önce elle yazılmış kurallarla, sonra örneklerden öğrenen bir karar ağacıyla. Yolda makine öğreniminin üç temel fikrine değeceğiz: eğitim ve test verisi, modelin nerede yanıldığını görmek ve aşırı öğrenme.
Hogwarts Legacy oyununda şapka beni Ravenclaw’a göndermişti. Bu yazı için de aklımdaki soru şuydu: Bu kararı bir model verseydi, neye bakarak verirdi?
Kodların hepsi Colab’da hazır, kurulum gerekmiyor: Colab’da Aç
Veri hakkında: Yazıdaki öğrencilerin hepsi hayali. Veriyi kod kendisi üretiyor; kitaplardan ya da filmlerden hiçbir karakter, metin veya görsel kullanmıyoruz.
Şapkaya ne soruyoruz?
Her öğrenciyi dört özellikle tarif edelim ve her birine 0 ile 10 arasında puan verelim: cesaret, zeka, sadakat ve hırs. Her binanın öne çıkardığı bir özellik var: Gryffindor cesareti, Ravenclaw zekayı, Hufflepuff sadakati, Slytherin hırsı.

Makine öğrenimi dilinde bu dört puan öznitelik (feature), bina adı ise etiket (label). Modelin işi özniteliklere bakıp etiketi tahmin etmek.
1. Kural tabanlı şapka
En akla yatkın kural: öğrencinin en yüksek özelliğine bak, o özelliğin binasına gönder.
OZELLIKLER = ["cesaret", "zeka", "sadakat", "hirs"]BINALAR = {"Gryffindor": "cesaret", "Ravenclaw": "zeka", "Hufflepuff": "sadakat", "Slytherin": "hirs"}def kural_sapka(ogrenci): """En yüksek puanlı özelliğe bakıp binayı seçer.""" en_guclu = max(OZELLIKLER, key=lambda o: ogrenci[o]) for bina, ozellik in BINALAR.items(): if ozellik == en_guclu: return binaprint(kural_sapka({"cesaret": 9, "zeka": 6, "sadakat": 7, "hirs": 4}))# Gryffindorprint(kural_sapka({"cesaret": 5.2, "zeka": 5.4, "sadakat": 5.1, "hirs": 5.3}))# Ravenclaw
İlk öğrencide sorun yok. İkincisine bak: dört özelliği de neredeyse eşit, zekası sadece 0,1 puan önde diye Ravenclaw’a gidiyor. Kuralın bu öğrenci hakkında “emin değilim” deme imkanı yok. İnsan eliyle yazılan kuralların genel derdi bu: düşündüğün durumlarda çalışıyor, düşünmediğin durumlarda sessizce yanılıyor.
max satırındaki key=lambda o: ogrenci[o] ifadesi, “özellik adlarını karşılaştırırken her birinin puanına bak” demek. Fonksiyonları bugünkü Python Dersi 9’da anlattım; lambda ise tek satırlık, isimsiz bir fonksiyon.
2. Hayali öğrenciler üretmek
Model örneklerden öğreneceği için bize etiketli veri lazım. Her binadan 60, toplam 240 hayali öğrenci üretelim. Gryffindor, Ravenclaw ve Slytherin öğrencilerinde binanın özelliği belirgin şekilde yüksek olsun.
Hufflepuff’a bir büküm ekleyelim. Hufflepuff, kapısını herkese açan bina olarak bilinir. Bu yüzden öğrencilerin yarısında sadakat yüksek, diğer yarısında ise hiçbir özellik öne çıkmıyor. Kural tabanlı şapka bu ikinci grubu bilmiyor; bakalım model fark edebilecek mi?
import numpy as npimport pandas as pdrng = np.random.default_rng(42)satirlar = []for bina, baskin in BINALAR.items(): for i in range(60): if bina == "Hufflepuff" and i % 2 == 1: # Dengeli öğrenci: hiçbir özellik öne çıkmıyor ogr = {o: rng.normal(5, 0.7) for o in OZELLIKLER} ogr["sadakat"] = rng.normal(5.5, 0.7) else: ogr = {o: rng.normal(4.5, 1.2) for o in OZELLIKLER} ogr[baskin] = rng.normal(8, 1) ogr = {o: float(np.clip(round(v, 1), 0, 10)) for o, v in ogr.items()} ogr["bina"] = bina satirlar.append(ogr)df = pd.DataFrame(satirlar)print(df.groupby("bina")[OZELLIKLER].mean().round(1))
            cesaret  zeka  sadakat  hirs
bina
Gryffindor      7.8   4.4      4.5   4.6
Hufflepuff      4.8   4.9      6.5   4.4
Ravenclaw       4.3   8.1      4.6   4.3
Slytherin       4.6   4.6      4.5   7.8
rng.normal(8, 1), ortalaması 8 olan ve çoğunlukla 7 ile 9 arasına düşen rastgele bir sayı üretiyor. np.clip puanları 0 ile 10 arasında tutuyor. default_rng(42) içindeki 42 sayesinde kodu her çalıştırdığında aynı öğrenciler üretiliyor, böylece sen de yazıdaki sonuçların aynısını görüyorsun.
3. Eğitim ve test verisi
Bir modeli, öğrendiği örneklerle sınamak sınavdan önce cevap anahtarını vermeye benzer. Bu yüzden veriyi ikiye ayırıyoruz: model 180 öğrenciden öğrenecek, hiç görmediği 60 öğrenciyle sınanacak.
from sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_scoreX = df[OZELLIKLER]y = df["bina"]X_egitim, X_test, y_egitim, y_test = train_test_split( X, y, test_size=0.25, random_state=42, stratify=y)kural_tahmin = [kural_sapka(ogr) for ogr in X_test.to_dict("records")]print(f"Kural tabanlı şapkanın doğruluğu: {accuracy_score(y_test, kural_tahmin):.0%}")# Kural tabanlı şapkanın doğruluğu: 83%
stratify=y, test grubunda her binadan eşit sayıda (15’er) öğrenci olmasını sağlıyor. Kural tabanlı şapka 60 test öğrencisinin 50’sini doğru yerleştirdi. Kötü değil; şimdi bunu geçmeye çalışalım.
4. Karar ağacı: şapkaya örneklerden öğretmek
Karar ağacı, veriye bakıp kendi evet-hayır sorularını oluşturan bir model. “Zeka 6,35’ten büyük mü?” diye sorar, cevaba göre bir dala geçer, sonra yeni bir soru sorar. Yani yaptığı şey bizim if-else kuralımıza çok benziyor; farkı, kuralları bizim yerimize veriden çıkarması.
from sklearn.tree import DecisionTreeClassifier, export_textmodel = DecisionTreeClassifier(max_depth=3, random_state=42)model.fit(X_egitim, y_egitim)tahmin = model.predict(X_test)print(f"Karar ağacının doğruluğu: {accuracy_score(y_test, tahmin):.0%}")# Karar ağacının doğruluğu: 88%
max_depth=3, ağacın en fazla üç soru üst üste sorabileceği anlamına geliyor. fit öğrenme adımı, predict tahmin adımı. Ağaç 60 öğrencinin 53’ünü doğru yerleştirdi.
Karar ağacının güzel tarafı, öğrendiği kuralları okuyabilmemiz:
print(export_text(model, feature_names=OZELLIKLER))
|--- zeka <= 6.35| |--- hirs <= 6.45| | |--- cesaret <= 5.85| | | |--- class: Hufflepuff| | |--- cesaret > 5.85| | | |--- class: Gryffindor| |--- hirs > 6.45| | |--- cesaret <= 8.30| | | |--- class: Slytherin| | |--- cesaret > 8.30| | | |--- class: Gryffindor|--- zeka > 6.35| |--- hirs <= 7.30| | |--- cesaret <= 7.50| | | |--- class: Ravenclaw| | |--- cesaret > 7.50| | | |--- class: Gryffindor| |--- hirs > 7.30| | |--- class: Slytherin
Bu çıktıdaki en ilginç detay şu: ağaç sadakati hiç sormuyor. Hufflepuff’ı “zekası, hırsı ve cesareti yüksek olmayan öğrenci” diye tarif ediyor. Biz veriyi üretirken Hufflepuff’ın yarısını dengeli öğrencilerden oluşturmuştuk; model de bunu bulmuş ve öteki üç binaya girmeyenleri Hufflepuff’a gönderen bir kural çıkarmış. Kural tabanlı şapkanın bilmediği şeyi örneklerden öğrendi.
5. Şapka nerede yanılıyor?
Doğruluk tek bir sayı; hangi binaların karıştığını söylemiyor. Bunun için karışıklık matrisine (confusion matrix) bakıyoruz. Satırlar gerçek binayı, sütunlar modelin tahminini gösteriyor:
| Gerçek \ Tahmin | Gryffindor | Ravenclaw | Hufflepuff | Slytherin |
|---|---|---|---|---|
| Gryffindor | 14 | 0 | 0 | 1 |
| Ravenclaw | 1 | 14 | 0 | 0 |
| Hufflepuff | 1 | 3 | 11 | 0 |
| Slytherin | 0 | 0 | 1 | 14 |
Köşegendeki sayılar doğru tahminler. Hataların çoğu Hufflepuff satırında: 15 Hufflepuff öğrencisinin 3’ü Ravenclaw’a gitmiş. Bunlar büyük ihtimalle zekası biraz yüksek çıkan dengeli öğrenciler. Gerçek bir projede bir sonraki adım bu örneklere tek tek bakmak olurdu.
6. Ağacı büyütmek her zaman iyi mi?
Derinlik 3 yerine 10 olsa daha mı iyi olur? Farklı derinlikleri deneyip hem eğitim hem test doğruluğuna bakalım:
for d in [1, 2, 3, 4, 5, 6, 8, 10]: m = DecisionTreeClassifier(max_depth=d, random_state=42).fit(X_egitim, y_egitim) egitim = accuracy_score(y_egitim, m.predict(X_egitim)) test = accuracy_score(y_test, m.predict(X_test)) print(f"derinlik {d:>2}: eğitim {egitim:.0%}, test {test:.0%}")
derinlik 1: eğitim 49%, test 47%derinlik 2: eğitim 72%, test 67%derinlik 3: eğitim 94%, test 88%derinlik 4: eğitim 97%, test 90%derinlik 5: eğitim 98%, test 90%derinlik 6: eğitim 99%, test 90%derinlik 8: eğitim 100%, test 90%derinlik 10: eğitim 100%, test 90%
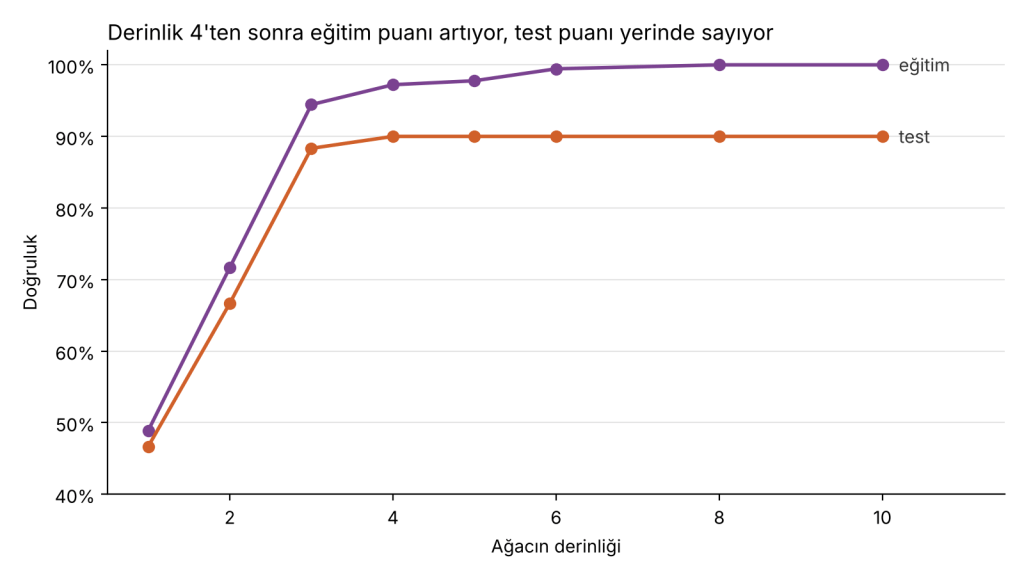
Derinlik 8’de ağaç eğitim verisindeki her öğrenciyi doğru yerleştiriyor, ama yeni öğrencilerde derinlik 4’ten hiç daha iyi değil. Ekstra sorular genel bir kural öğrenmiyor, eğitimdeki tek tek öğrencileri ezberliyor. Buna aşırı öğrenme (overfitting) deniyor ve makine öğreniminde eğitim puanına tek başına güvenmememizin sebebi bu. Bizim örneğimizde zararı yok gibi görünüyor; daha gürültülü gerçek verilerde ise ezberleyen model test puanını da düşürebilir. Derinlik 3 de 4’e çok yakın sonuç veriyor ve kuralları bir bakışta okunabiliyor; yazıda bu yüzden onu seçtim.
7. Berabere kalınca ne olur?
Model, tahminin yanında her bina için bir olasılık da veriyor. Bunu bir fonksiyona saralım:
def sapka(cesaret, zeka, sadakat, hirs): ogr = pd.DataFrame([{"cesaret": cesaret, "zeka": zeka, "sadakat": sadakat, "hirs": hirs}]) olasiliklar = model.predict_proba(ogr)[0] for bina, p in sorted(zip(model.classes_, olasiliklar), key=lambda x: -x[1]): if p > 0: print(f"{bina:<11} {p:.0%}") print("Şapkanın kararı:", model.predict(ogr)[0])sapka(cesaret=9, zeka=5, sadakat=4, hirs=5)
Gryffindor 89%Hufflepuff 9%Slytherin 2%Şapkanın kararı: Gryffindor
Şimdi cesareti ve hırsı tam olarak eşit bir öğrenci deneyelim:
berabere = {"cesaret": 8, "zeka": 5, "sadakat": 5, "hirs": 8}print("Kural tabanlı şapka:", kural_sapka(berabere))sapka(**berabere)
Kural tabanlı şapka: GryffindorSlytherin 98%Hufflepuff 2%Şapkanın kararı: Slytherin
İki şapka iki farklı binayı seçti ve ikisinin de sebebi ilginç. Kural tabanlı şapka Gryffindor diyor, çünkü max eşitlikte listede önce gelen özelliği seçiyor. Yani kararı öğrenci değil, benim listeyi yazma sıram verdi. Karar ağacı ise %98 eminlikle Slytherin diyor, çünkü kurallarından biri “hırs yüksekse ve cesaret 8,30’u geçmiyorsa Slytherin”.
Buradan çıkacak ders şu: Modelin %98 demesi gerçekten bu kadar emin olduğu anlamına gelmiyor. Karar ağacı olasılığı, öğrencinin düştüğü yapraktaki eğitim örneklerinin oranından hesaplıyor. O yaprakta neredeyse hep Slytherin öğrencileri olduğu için sayı yüksek çıkıyor. Tam sınırdaki bir öğrenci için bile. Olasılık çıktısını okurken bunu akılda tutmak gerekiyor.
8. Kendi şapkanı tak
Not defterinin sonunda dört soruluk küçük bir test var. Her özelliğe kendine 0 ile 10 arası puan veriyorsun, şapka da kararını ve olasılıkları yazıyor:
puanlar = {}for o in OZELLIKLER: puanlar[o] = float(input(f"{o} (0-10): "))sapka(**puanlar)
sapka(**puanlar) satırındaki iki yıldız, sözlükteki anahtarları isimli argümanlara çeviriyor. Yani sapka(cesaret=..., zeka=..., ...) yazmakla aynı şey.
Bu projede ne öğrendik?
- Sınıflandırma: özniteliklere bakıp bir etiket tahmin etmek.
- Kural tabanlı sistemler düşündüğün durumlarda çalışır; örneklerden öğrenen model, senin görmediğin kalıpları bulabilir.
- Modeli her zaman görmediği verilerle sına.
- Karışıklık matrisi, hatanın nerede olduğunu gösterir.
- Eğitim puanı yüzde 100 olan model iyi bir model olmayabilir; aşırı öğrenmeye dikkat.
- Olasılık çıktısı her zaman gerçek bir eminlik ölçüsü değil.
Kendin dene
max_depthdeğerini 2 ve 5 yapıp kuralların nasıl değiştiğine bak.default_rng(42)içindeki 42’yi değiştir. Sonuçlar ne kadar oynuyor?- Veriye beşinci bir özellik ekle (örneğin merak) ve hangi binada yüksek olacağına sen karar ver.
- Karar ağacı yerine
KNeighborsClassifier(n_neighbors=5)dene ve olasılıkların nasıl değiştiğini karşılaştır.
Bir yanıt yazın