Etiket: #veribilimi #pythoneğitimi

  • Monopoly’de En Değerli Kareler: Monte Carlo Simülasyonu

    Monopoly’de En Değerli Kareler: Monte Carlo Simülasyonu

    Monopoly oynarken herkesin bir teorisi vardır: “Laciverti al, oyun biter.” “Demiryolları sağlam para.” “Kahverengi sadece başlangıç için.” Peki bu teoriler ne kadar doğru?

    Bir arsanın değerli olması için önce oyuncuların ona basması gerekiyor. Bu yazıda tek bir soruya cevap arıyoruz: Monopoly tahtasında en çok hangi karelere basılıyor? Cevabı formülle değil, oyunu bilgisayara bir milyon tur oynatarak bulacağız.
    Tüm kodlar Colab’da, tek tıkla açılıyor: Colab’da aç

    Monte Carlo nedir?

    Bir şeyin ihtimalini hesaplamak zorsa, onu çok kez rastgele deneyip sonuçları sayabilirsin. Buna Monte Carlo simülasyonu deniyor. Adını Monaco’daki ünlü kumarhane semtinden alıyor; rastgelelik ve şans üzerine kurulu bir yöntem için yerinde bir isim.

    Önce cevabını bildiğimiz bir soruyla deneyelim: İki zar atınca toplamın 7 gelme ihtimali kaç? Matematikle cevap 6/36, yani yaklaşık yüzde 16,67.

    import random
    from collections import Counter
    def zar_toplami_dene(atis_sayisi, tohum=1):
    rnd = random.Random(tohum)
    sayac = Counter(rnd.randint(1, 6) + rnd.randint(1, 6) for _ in range(atis_sayisi))
    return sayac[7] / atis_sayisi * 100
    for n in [100, 10_000, 1_000_000]:
    print(f"{n:>9,} atış -> 7 gelme oranı: %{zar_toplami_dene(n):.2f}")
          100 atış -> 7 gelme oranı: %20.00
       10,000 atış -> 7 gelme oranı: %16.75
    1,000,000 atış -> 7 gelme oranı: %16.65

    100 atışta sonuç %20 çıkıyor, epey sapmış. Bir milyon atışta gerçek değere neredeyse yapışıyor. Monte Carlo’nun bütün fikri bu: Yeterince çok denersen rastgelelik dengelenir.

    Monopoly’de kartlar, hapis ve çift zar kuralları yüzünden formül çok karışık. Ama simülasyonun mantığı aynı kalıyor.

    Tahtayı ve kuralları koda dökmek

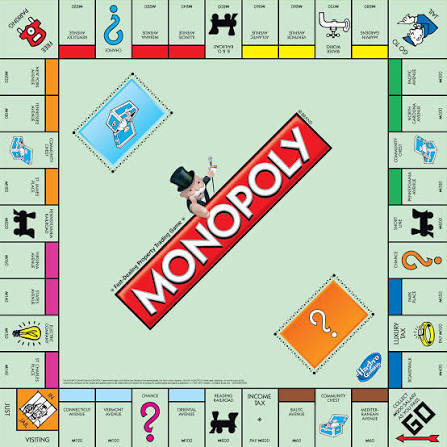
    Tahtada 40 kare var. Klasik ABD tahtasının kare adlarını bir listeye yazıyoruz; listenin sırası tahtadaki sıra. Simülasyona koyduğumuz kurallar:

    • İki zar atılır, toplam kadar ilerlenir.
    • Çift atan bir daha atar; üst üste üçüncü çift hapse gönderir.
    • Hapse Gir karesine gelen hapse gider.
    • 16 Şans kartından 10’u oyuncuyu bir yere gönderir: Başlangıç, Illinois Ave, St. Charles Place, Reading Demiryolu, Boardwalk, hapis, en yakın şirket, iki kez en yakın demiryolu ve 3 kare geri.
    • 16 Kamu Fonu kartından 2’si oyuncuyu gönderir: Başlangıç ve hapis.
    • Kartlar karıştırılır, çekilen kart destenin altına gider.

    Kartları birer metin listesi olarak tutuyoruz. Bir kart çekmek, listenin başındaki elemanı alıp sona koymak demek:

    k = sans.pop(0)
    sans.append(k)
    konum = sans_karti(k, konum)

    Simülasyonun kalbi olan simule() fonksiyonu yaklaşık 30 satır. Her turda zar atıyor, kuralları uyguluyor ve piyonun durduğu kareyi bir Counter‘a yazıyor. Kodun tamamı not defterinde; burada sonuçlara bakalım.

    Bir milyon tur sonra

    Eşit ihtimal olsaydı her kareye yüzde 2,5 düşerdi. Ama tahta hiç de eşit değil. Hapisten hemen çıkan bir oyuncu için en çok basılan 10 kare:

    SıraKareBasılma oranı
    1Hapis%6,15
    2Illinois Ave%3,19
    3Başlangıç%3,09
    4New York Ave%3,06
    5B&O Demiryolu%3,06
    6Reading Demiryolu%2,97
    7Pennsylvania Demiryolu%2,93
    8Tennessee Ave%2,92
    9Ücretsiz Otopark%2,91
    10Su İdaresi%2,83

    Bu tablodan üç şey çıkıyor:

    • Hapis açık ara birinci. Oraya giden üç yol var: Hapse Gir karesi, Şans ve Kamu Fonu kartları, üst üste üç çift. Başka hiçbir kare bu kadar “trafik” almıyor.
    • Illinois Ave en çok basılan arsa. Şans destesindeki kartlardan biri doğrudan oraya gönderiyor.
    • Demiryolları listede üç kez var. İki Şans kartı “en yakın demiryoluna git” diyor.

    Listenin en altında ise Şans kareleri var: Buraya gelen oyuncuların çoğu çektiği kartla başka yere gidiyor. Hapse Gir karesinin oranı ise sıfır, çünkü oraya gelen piyon anında hapse taşınıyor.

    Renk grupları: hangisi önde?

    Monopoly’de asıl para, bir renk grubunun tamamını alıp ev kurmaktan geliyor. Grupların kare sayısı farklı (2 ya da 3), o yüzden adil karşılaştırma için arsa başına oranı hesaplıyoruz:

    GRUPLAR = {
    "Kahverengi": [1, 3], "Açık mavi": [6, 8, 9], "Pembe": [11, 13, 14], "Turuncu": [16, 18, 19],
    "Kırmızı": [21, 23, 24], "Sarı": [26, 27, 29], "Yeşil": [31, 32, 34], "Lacivert": [37, 39],
    }
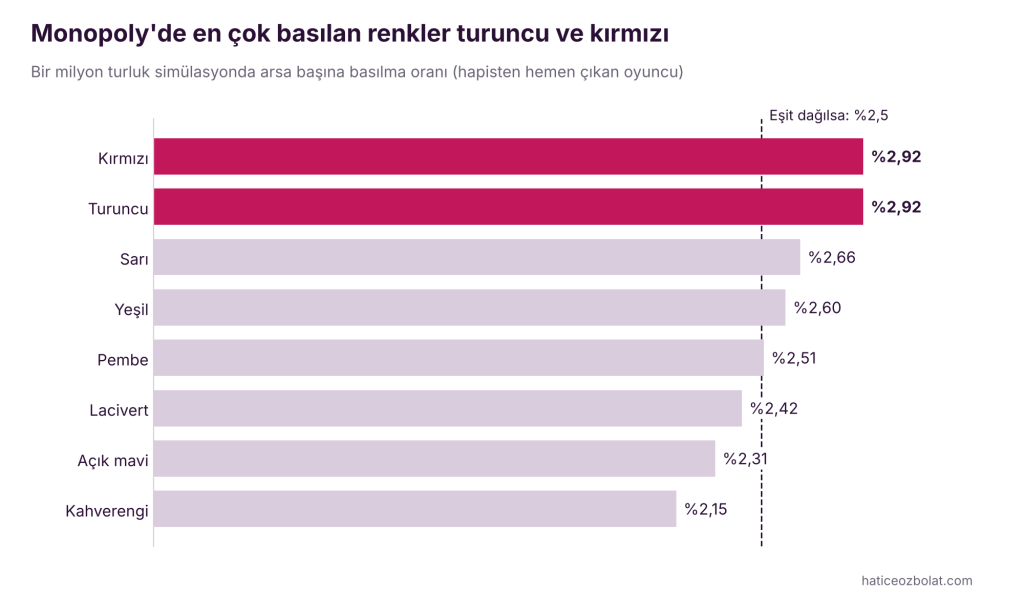
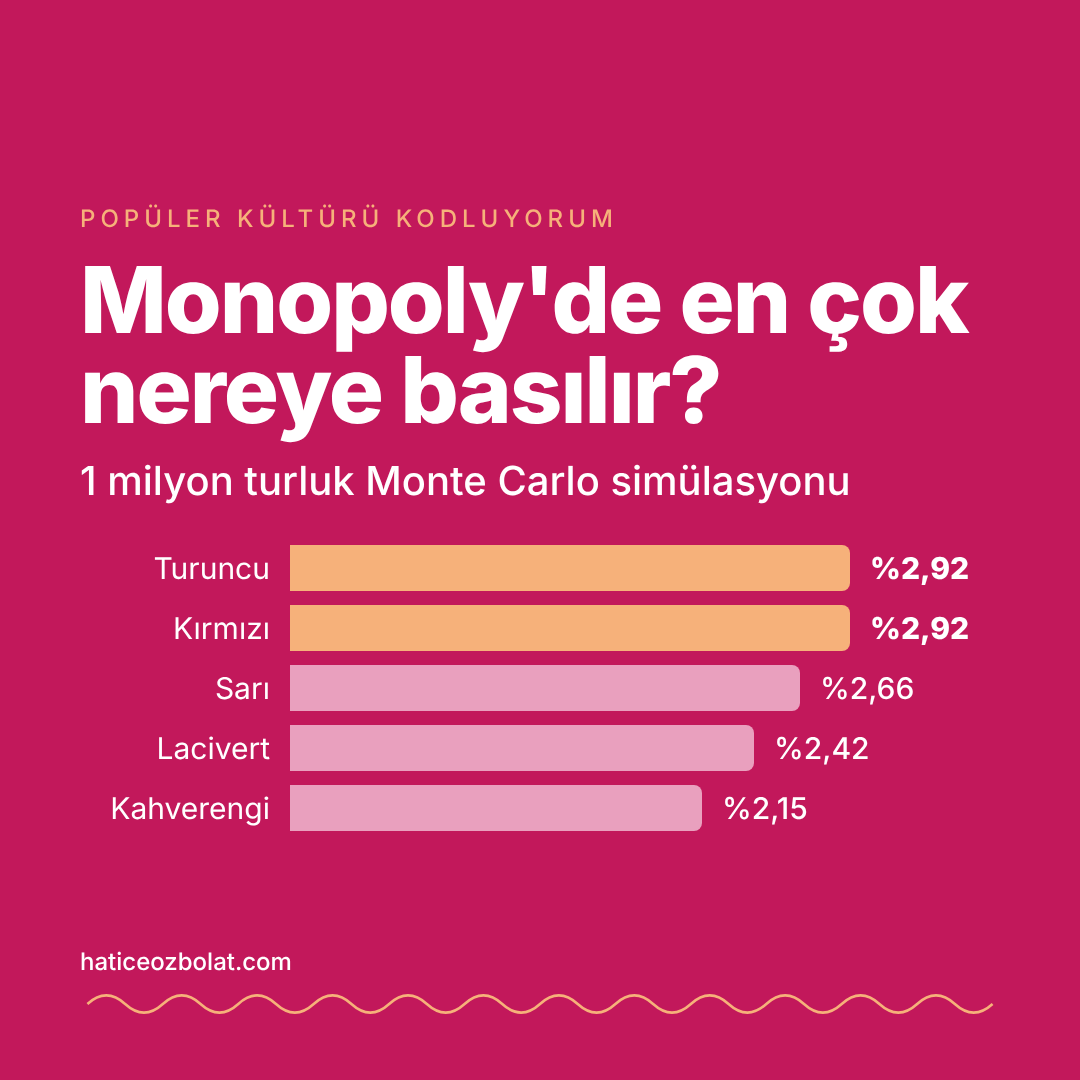
    Monopoly renk gruplarında arsa başına basılma oranı. Turuncu ve kırmızı %2,92 ile başta; sonra sarı %2,66, yeşil %2,60, pembe %2,51, lacivert %2,42, açık mavi %2,31 ve kahverengi %2,15. Eşit dağılımda oran %2,5 olurdu.

    Turuncu ve kırmızı başa baş önde, kahverengi en geride. Asıl sürpriz lacivert: Oyunun en pahalı grubu, ama arsa başına basılma oranı ortalamanın altında. Boardwalk’ı bir Şans kartı kurtarıyor; Park Place ise kendi başına kalıyor.

    Turuncunun sırrı: hapisten çıkış

    Hapis tahtada 10. kare ve oyuncular oraya çok sık gidiyor. Hapisten çıkan oyuncu iki zar atıyor. Turuncu kareler hapisten tam 6, 8 ve 9 kare ileride.

    İki zarda hangi toplamın kaç farklı yolla gelebildiğine bakalım:

     2: █  1/36
     3: ██  2/36
     4: ███  3/36
     5: ████  4/36
     6: █████  5/36
     7: ██████  6/36
     8: █████  5/36
     9: ████  4/36
    10: ███  3/36
    11: ██  2/36
    12: █  1/36

    6, 8 ve 9 toplamları en sık gelenlerden. Toplarsak: (5 + 5 + 4) / 36, yani hapisten çıkan bir oyuncunun tek atışta turuncu bir kareye basma ihtimali yüzde 38,9. Hapis ne kadar kalabalıksa turuncu o kadar kazanıyor.

    Kırmızının arkasındaki güç ise Şans destesi: Illinois Ave kartı.

    Hapiste beklersen ne değişir?

    Oyunun sonlarına doğru oyuncular genelde hapiste kalmayı tercih eder. Tahta evlerle dolmuştur ve dolaşmak pahalıdır; hapiste otururken kira ödemezsin ama kira toplamaya devam edersin. Aynı simülasyonu “çift atana kadar bekle” stratejisiyle çalıştırdığımızda:

    • Hapis karesinin payı yüzde 6,15’ten yüzde 11,50’ye çıkıyor.
    • Turuncu arsa başına yüzde 2,77 ile kırmızının (yüzde 2,73) önüne geçiyor.

    Yani oyun ilerledikçe turuncunun avantajı büyüyor. “Turuncuyu al” tavsiyesinin arkasındaki matematik bu.

    Sınırlar

    Bu simülasyon sadece basılma ihtimalini ölçüyor. Bir grubun gerçekten ne kadar kârlı olduğu arsanın fiyatına, ev maliyetine ve kiraya da bağlı; bunları modele katmadık. Kuralların da klasik sürümünü kullandık, evdeki özel kurallar (Ücretsiz Otopark’ta para toplamak gibi) sonucu değiştirmiyor ama farklı bir tahta sürümü değiştirebilir.

    Yine de basılmayan bir arsadan kira alamazsın. O yüzden bu tablo iyi bir başlangıç noktası.

    Devamını oku: Netflix’te Ne İzlesem? Basit Bir Öneri Sistemi Yazmak

    Kendin dene

    1. TUR değerini 1.000’e indir. Sonuçlar ne kadar oynuyor? Kaç turdan sonra sıralama oturuyor?
    2. Şans destesinden Illinois kartını çıkar. Illinois Ave hâlâ en çok basılan arsa mı?
    3. Demiryollarını bir grup olarak ekle ([5, 15, 25, 35]). Arsa başına oranları nasıl?
    4. Hapiste en fazla bir tur beklenebilsin. Turuncunun avantajına ne oluyor?

    Devamını oku: Futbol Veri Projesi 1: Maç Verisini Toplamak ve Temizlemek

    Monopoly, Hasbro’nun tescilli markasıdır. Bu yazı oyunla resmî bir bağlantı taşımıyor; kare adları klasik ABD tahtasından, görseller kendi grafiklerimiz.
  • Futbol Veri Projesi 1: Maç Verisini Toplamak ve Temizlemek

    Futbol Veri Projesi 1: Maç Verisini Toplamak ve Temizlemek

    Veri analizi denince akla genelde grafikler ve modeller geliyor. Ama gerçek bir projede zamanın büyük kısmı ondan önceki aşamaya gidiyor: veriyi bulmak, indirmek, tabloya çevirmek ve temizlemek. Bu iki bölümlük hafta sonu projesinde Süper Lig’in 2024-25 sezonunu inceleyeceğiz. Bu ilk bölüm tamamen o görünmeyen ama en önemli işe ayrıldı.

    Sonunda elimizde her satırı bir maç olan, kontrol edilmiş, temiz bir CSV dosyası olacak. Bir de veriye ilk bakış: Ev sahibi olmak gerçekten avantaj mı?

    Bu projeyi seçmemin küçük bir hikâyesi var. Ben Beşiktaşlıyım ve yeni stadımız yapılırken bir dönem kendi stadımız olmadan oynadık. İç saha maçlarını kendi evinde oynayamamak bir takım için ne demek? Ev sahibi olmak gerçekten bir avantaj mı, yoksa sadece taraftarların inandığı bir şey mi? Bu soruların cevabını veride aramak istedim. Bu ilk bölüm o yolculuğun hazırlık kısmı.

    Kodların hepsi Colab’da hazır: Colab’da Aç

    Veri nereden geliyor?

    Veriyi openfootball projesinden alıyoruz. Bu proje, dünyanın birçok liginin maç sonuçlarını gönüllülerin derlediği açık dosyalarda topluyor ve GitHub’da yayımlıyor. Lisansı CC0, yani verinin üzerinde telif hakkı yok; istediğin gibi kullanabilirsin.

    Bir uyarı: Bu resmî bir kaynak değil. Gönüllüler tarafından derlendiği için eksik ya da hatalı kayıtlar olabilir. Zaten bu bölümün amacı da tam olarak bunları bulmak.

    Veri setini seçerken her zaman lisansına bak. “İnternette buldum” demek, onu bir projede ya da yazıda kullanabileceğin anlamına gelmiyor.

    1. Veriyi indirmek

    Veri tek bir JSON dosyasında. Python’un requests kütüphanesiyle indiriyoruz:

    import requests
    URL = "https://raw.githubusercontent.com/openfootball/football.json/master/2024-25/tr.1.json"
    cevap = requests.get(URL, timeout=30)
    cevap.raise_for_status()
    ham = cevap.json()
    print(ham["name"]) # Turkish Süper Lig 2024/25
    print(len(ham["matches"]), "maç") # 342 maç

    raise_for_status() bir güvenlik kemeri: Sunucu bir hata döndürürse (sayfa bulunamadı gibi) program burada durup hatayı söylüyor. Python Dersi 13’teki raise‘in hazır bir örneği.

    Tek bir maç kaydı şöyle görünüyor:

    {
    "round": "Matchday 1",
    "date": "2024-08-09",
    "time": "21:00",
    "team1": "Galatasaray",
    "team2": "Hatayspor",
    "score": {"ht": [0, 0], "ft": [2, 1]}
    }

    team1 ev sahibi, team2 deplasman. ft (full time) maç sonu, ht (half time) ilk yarı skoru. Bu yapı, Python Dersi 8’de öğrendiğimiz sözlük ve listelerin iç içe geçmiş hali.

    2. JSON’dan tabloya

    Pandas’ın json_normalize fonksiyonu iç içe sözlükleri düzleştirip tabloya çeviriyor:

    import pandas as pd
    import numpy as np
    df = pd.json_normalize(ham["matches"])
    print(df.shape) # (342, 8)

    score sözlüğünün içindeki iki alan score.ft ve score.ht adında iki ayrı sütuna dönüştü. Ama her hücrede halâ [2, 1] gibi bir liste var; bunu da ayırmamız gerekecek.

    3. Sütunları düzenlemek

    df = df.rename(columns={
    "round": "hafta", "team1": "ev", "team2": "deplasman",
    "score.ft": "skor", "score.ht": "ilk_yari", "status": "durum",
    })
    df["hafta"] = df["hafta"].str.extract(r"(\d+)").astype(int)
    df["tarih"] = pd.to_datetime(df["date"] + " " + df["time"])
    def ayir(skor, i):
    """[ev, deplasman] listesinden i. elemanı alır; skor yoksa NaN döndürür."""
    return skor[i] if isinstance(skor, list) else np.nan
    df["ev_gol"] = df["skor"].apply(ayir, i=0)
    df["dep_gol"] = df["skor"].apply(ayir, i=1)
    df["iy_ev"] = df["ilk_yari"].apply(ayir, i=0)
    df["iy_dep"] = df["ilk_yari"].apply(ayir, i=1)
    df["hukmen"] = df["durum"].eq("awarded")

    Bu blokta üç önemli temizlik adımı var:

    • “Matchday 1” metninden 1 sayısına: str.extract(r"(\d+)") metnin içindeki rakamları çekiyor. Metin olarak kalırsa “Matchday 10” sıralamada “Matchday 2″den önce gelirdi.
    • Tarih ve saati tek bir zaman sütununa: to_datetime ile gerçek bir tarih tipine çevirince haftanın gününü, ayı ya da iki maç arasındaki gün sayısını kolayca hesaplayabiliyoruz.
    • Skor listelerini ayırmak: ayir fonksiyonu listeden golü alıyor. Skor yoksa hata vermek yerine NaN (boş değer) döndürüyor. Bu yüzden isinstance ile önce gerçekten bir liste olup olmadığına bakıyoruz.

    4. Eksik değerler: verinin anlatmadığı hikaye

    df.isna().sum()
    ev_gol 4
    dep_gol 4
    iy_ev 30
    iy_dep 30

    Veride üç farklı sorun çıktı:

    • Skoru olmayan 4 maç: Hepsi 38. haftada. Kaynak veride bu maçların skoru girilmemiş. Bu maçları analizden çıkaracağız, ama bunu yazıda açıkça söylemek şart: Sonuçlarımız 342 değil, 338 maça dayanacak.
    • İlk yarı skoru olmayan 30 maç: Bu 30 maçın 4’ü yukarıdaki skoru hiç olmayan maçlar. Geri kalan 26 maçta maç sonucu var ama ilk yarı skoru yok. Maç sonucuyla ilgili analizlerde bu bir sorun değil; ilk yarıyla ilgili bir soru sorarsak bu maçları dışarıda bırakmamız gerekecek.
    • Hükmen sonuçlanan 1 maç: 23. haftadaki Galatasaray-Adana Demirspor maçı veride awarded (hükmen) olarak işaretli, skoru 3-0. Bu skor sahada atılan gollerden gelmiyor. Puan tablosunu hesaplarken bu maç sayılmalı, ama “maç başına gol” gibi sahayla ilgili bir istatistiğe katılmamalı.

    Eksik değerlerde verilecek kararların (silmek, doldurmak, ayrı tutmak) tek bir doğru cevabı yok. Doğru cevap sorduğun soruya bağlı. Ama her durumda kural aynı: Ne yaptığını ve neden yaptığını yaz.

    5. Tutarlılık kontrolleri

    Eksik değerler sadece bir tür sorun. Veri “tam” görünüp yanlış da olabilir. Bunu yakalamak için veri hakkında bildiğimiz gerçeklerle karşılaştırıyoruz:

    print("Haftadaki maç sayıları:", df.groupby("hafta").size().unique())
    print("Takım sayısı:", pd.concat([df["ev"], df["deplasman"]]).nunique())
    print("Takım başına maç:", pd.concat([df["ev"], df["deplasman"]]).value_counts().unique())
    print("Aynı ev-deplasman eşleşmesi en fazla:", df.groupby(["ev", "deplasman"]).size().max(), "kez")
    Haftadaki maç sayıları: [9]
    Takım sayısı: 19
    Takım başına maç: [36]
    Aynı ev-deplasman eşleşmesi en fazla: 1 kez

    Hepsi beklendiği gibi: 19 takımlı bir ligde her hafta bir takım bay geçiyor, kalan 18 takım 9 maç yapıyor. Her takım diğer 18 takımla bir iç sahada, bir deplasmanda oynadığı için 36 maç yapıyor. Aynı eşleşme iki kez yazılmamış. Ayrıca takım adları tutarlı: “Fenerbahçe” ile “Fenerbahce” gibi aynı takımın iki farklı yazımı olsaydı, takım sayısı 19’dan fazla çıkardı.

    Bu kontroller sıkıcı görünebilir ama veri analizinin en değerli dakikaları bunlar. Hatalı bir veriyle yapılan en güzel grafik bile yanlış bir şey söyler.

    6. Yeni sütunlar ve temiz dosya

    Skoru olan 338 maçı alıp iki yeni sütun ekliyoruz: toplam gol ve maçın sonucu.

    oynanan = df.dropna(subset=["ev_gol", "dep_gol"]).copy()
    oynanan[["ev_gol", "dep_gol"]] = oynanan[["ev_gol", "dep_gol"]].astype(int)
    oynanan["toplam_gol"] = oynanan["ev_gol"] + oynanan["dep_gol"]
    oynanan["sonuc"] = np.select(
    [oynanan["ev_gol"] > oynanan["dep_gol"], oynanan["ev_gol"] < oynanan["dep_gol"]],
    ["Ev sahibi", "Deplasman"],
    default="Beraberlik",
    )
    oynanan.to_csv("super_lig_2024_25_temiz.csv", index=False)

    np.select bir dizi koşulu sırayla kontrol ediyor: Ev sahibinin golü fazlaysa “Ev sahibi”, deplasmanınki fazlaysa “Deplasman”, hiçbiri değilse “Beraberlik”. Python Dersi 5’teki if-elif-else‘in bütün sütuna tek seferde uygulanan hali.

    Neden temiz veriyi ayrı bir dosyaya kaydediyoruz? Bir sonraki bölümde analize doğrudan bu dosyadan başlayacağız. Temizlik adımlarını her seferinde tekrarlamak hem zaman kaybı hem de hata riski.

    7. İlk bakış: ev sahibi avantajı var mı?

    Temiz veriyle ilk soruyu soralım. Hükmen maçı bu kez dışarıda bırakıyoruz, çünkü sahada oynananlara bakıyoruz:

    sahada = oynanan[~oynanan["hukmen"]]
    print(f"Maç başına gol: {sahada['toplam_gol'].mean():.2f}")
    print(sahada["sonuc"].value_counts(normalize=True).round(3))
    Sahada oynanan maç: 337
    Maç başına gol: 2.93
    Ev sahibi gol ortalaması: 1.66
    Deplasman gol ortalaması: 1.27
    Ev sahibi 0.484
    Deplasman 0.282
    Beraberlik 0.234

    Verideki maçların neredeyse yarısını ev sahibi kazanmış, deplasman ekibi ise dört maçtan sadece birinden biraz fazlasını. Ev sahipleri maç başına deplasman takımlarından yaklaşık 0,4 gol fazla atmış. Bu tek sezonluk bir gözlem; ev sahibi avantajının nedenleri ve takımlar arasındaki farklar, ikinci bölümün konusu.

    Sezonun en golü maçı: 36. haftada Çaykur Rizespor 6-3 Göztepe.

    Bu bölümde ne yaptık?

    • Açık lisanslı bir veri kaynağı bulduk ve lisansını kontrol ettik.
    • JSON’u indirip json_normalize ile tabloya çevirdik.
    • Hafta numarasını, tarihi ve skorları kullanılabilir sütunlara dönüştürdük.
    • Eksik skorları, eksik ilk yarı skorlarını ve hükmen maçı bulup her biri için bir karar verdik.
    • Veriyi bildiğimiz gerçeklerle karşılaştırarak tutarlılığını kontrol ettik.
    • Temiz veriyi kaydedip ilk soruyu sorduk.

    Kendin dene

    1. URL’deki tr.1 yerine en.1 yazarak aynı sezonun Premier Lig verisini indir ve aynı temizliği uygula. Hangi kontroller farklı sonuç veriyor?
    2. İlk yarı skoru olan maçlarda, ilk yarıyı önde kapatan takım maçı kaç kez kazanmış?
    3. Haftalara göre maç başına gol ortalamasını hesapla. Sezon ilerledikçe değişiyor mu?
    4. Ev sahibi kazanma oranı en yüksek olan takım hangisi?

    Sıradaki bölüm

    Futbol Veri Projesi 2’de temiz veriden puan tablosunu hesaplıyoruz, takımların iç saha ve deplasman performansını karşılaştırıyoruz. Bir de önemli bir uyarıyı konuşacağız: Maç sonuçlarından hesaplanan bir puan tablosu, eksik maçlar ve puan silme cezaları gibi nedenlerle resmî tablodan farklı olabilir.

    Devamını oku

  • Kümeler ve Liste Üreteçleri (Python Dersi 12)

    Kümeler ve Liste Üreteçleri (Python Dersi 12)

    Bir listede kaç farklı eleman var? İki sınıfın ortak öğrencileri kimler? Geçen haftaki alışveriş listesinde olup bu haftakinde olmayanlar hangileri? Bu soruların hepsini döngülerle de çözebilirsin, ama Python’da bunlar için hazır bir veri yapısı var: küme (set). Dersin ikinci yarısında da liste, sözlük ve kümeleri tek satırda kurmanı sağlayan üreteçlere bakacağız.

    Kodların hepsi Colab’da hazır: Colab’da Aç

    Küme: tekrarsız eleman topluluğu

    Küme süslü parantezle yazılıyor ve her elemanı sadece bir kez tutuyor:

    sehirler = {"Adana", "Mersin", "Adana", "Hatay"}
    print(sehirler) # {'Hatay', 'Adana', 'Mersin'}
    print(len(sehirler)) # 3

    İki kez yazdığımız Adana bir kez kaldı. Bu özellik en çok bir listedeki tekrarları atmak için kullanılıyor:

    ziyaretler = ["Adana", "İzmir", "Adana", "Ankara", "İzmir", "Adana"]
    farkli = set(ziyaretler)
    print(farkli, len(farkli)) # {'Ankara', 'İzmir', 'Adana'} 3

    Kümede sıra yoktur

    Çıktıdaki sıranın yazdığımız sırayla aynı olmadığını fark ettin mi? Kümeler sırayı tutmaz; kodu her çalıştırdığında farklı bir sıra bile görebilirsin. Bu yüzden indeksle eleman alamazsın:

    sehirler[0]
    # TypeError: 'set' object is not subscriptable

    Sıralı bir sonuç istiyorsan sorted(sehirler) kullan; sana sıralı bir liste döndürür.

    Eklemek, silmek, aramak

    sehirler.add("Osmaniye")
    sehirler.add("Adana") # zaten var, bir şey değişmez
    sehirler.discard("Hatay")
    sehirler.discard("Rize") # yok ama hata vermez
    print("Mersin" in sehirler) # True

    remove da eleman siler, ama eleman yoksa hata verir. discard ise sessizce geçer.

    Tuzak: boş küme

    bos = set()
    print(type(bos), type({})) # <class 'set'> <class 'dict'>

    {} boş bir sözlük oluşturur, boş küme değil. Boş küme için set() yazman gerekiyor.

    Küme işlemleri

    Matematikte gördüğün birleşim, kesişim ve fark işlemleri Python’da tek bir işaretle yapılıyor:

    python_sinifi = {"Ayşe", "Mert", "Zeynep", "Can"}
    r_sinifi = {"Zeynep", "Can", "Elif"}
    print(python_sinifi | r_sinifi) # birleşim: en az birinde olanlar
    print(python_sinifi & r_sinifi) # kesişim: ikisinde de olanlar → Zeynep, Can
    print(python_sinifi - r_sinifi) # fark: sadece Python'da olanlar → Ayşe, Mert
    print(python_sinifi ^ r_sinifi) # simetrik fark: sadece birinde olanlar → Ayşe, Mert, Elif
    İşaretAdıSoru
    |BirleşimEn az birinde olanlar kimler?
    &Kesişimİkisinde de olanlar kimler?
    -FarkBirincide olup ikincide olmayanlar kimler?
    ^Simetrik farkSadece birinde olanlar kimler?

    SQL Hazırlık 1 yazısındaki “hiç çalışanı olmayan departmanlar” sorusunu hatırla. Aslında o da bir fark işlemiydi: tüm departmanlar eksi çalışanı olan departmanlar.

    Liste üreteci

    Liste üretecini kod kartında kısaca görmüştük: bir listeden yeni bir listeyi tek satırda kurmak. Hatırlayalım ve bir adım ileri gidelim:

    notlar = [70, 85, 40, 90, 45]
    gecenler = [n for n in notlar if n >= 50]
    # [70, 85, 90]
    artirilmis = [n + 5 for n in notlar]
    # [75, 90, 45, 95, 50]
    harfler = ["Geçti" if n >= 50 else "Kaldı" for n in notlar]
    # ['Geçti', 'Geçti', 'Kaldı', 'Geçti', 'Kaldı']

    Son örneğe dikkat: if sona gelirse filtreler (bazı elemanları atar). if ... else başa gelirse dönüştürür (her eleman için iki seçenekten birini seçer, hiçbirini atmaz). Bu ikisini karıştırmak liste üreteçlerindeki en sık hata.

    Sözlük ve küme üreteçleri

    Aynı yazım süslü parantezle sözlük ve küme de üretiyor:

    isimler = ["Ayşe", "Mert", "Zeynep"]
    uzunluklar = {isim: len(isim) for isim in isimler}
    # {'Ayşe': 4, 'Mert': 4, 'Zeynep': 6}
    notlar_sozluk = {"Ayşe": 85, "Mert": 45, "Zeynep": 92}
    gecenler = {isim: puan for isim, puan in notlar_sozluk.items() if puan >= 50}
    # {'Ayşe': 85, 'Zeynep': 92}
    epostalar = ["ayse@gmail.com", "mert@outlook.com", "can@gmail.com"]
    alanlar = {e.split("@")[1] for e in epostalar}
    # {'gmail.com', 'outlook.com'}

    Fark iki noktada: Başta anahtar: değer varsa sözlük, sadece tek bir değer varsa küme üretiyorsun. Son örnekte iki tane gmail.com olmasına rağmen sonuçta bir tane var, çünkü küme tekrarı tutmuyor. split("@")[1] Ders 11’den: e-postayı @ işaretinden böl, ikinci parçayı al.

    Mini program: iki listeyi karşılaştırmak

    def karsilastir(liste1, liste2):
    """İki listenin ortak, yalnızca birincide ve yalnızca ikincide olan elemanlarını döndürür."""
    a, b = set(liste1), set(liste2)
    return {
    "ortak": sorted(a & b),
    "sadece_1": sorted(a - b),
    "sadece_2": sorted(b - a),
    }
    gecen_hafta = ["süt", "ekmek", "yumurta", "peynir", "süt"]
    bu_hafta = ["ekmek", "domates", "peynir", "zeytin"]
    for ad, liste in karsilastir(gecen_hafta, bu_hafta).items():
    print(f"{ad:<9} {liste}")
    ortak ['ekmek', 'peynir']
    sadece_1 ['süt', 'yumurta']
    sadece_2 ['domates', 'zeytin']

    Aynı fonksiyonla iki kullanıcının ortak takipçilerini, iki dersin ortak öğrencilerini ya da iki veri dosyası arasında kaybolan kayıtları bulabilirsin. Veri analizinde “Bu iki listede kim var, kim yok?” sorusu sürekli karşına çıkıyor.

    Bonus: kümede aramak neden çok hızlı?

    Bir listede in ile arama yaptığında Python baştan başlayıp elemanları tek tek kontrol ediyor. Bir milyon elemanlı bir listede son elemanı aramak, bir milyon karşılaştırma demek. Küme ise elemanları özel bir yapıda (hash tablosu) tutuyor ve aranan elemana neredeyse doğrudan gidiyor.

    Not defterinde bunu ölçen bir hücre var: Aynı bir milyon sayıyı bir listede ve bir kümede 100 kez aratıyor. Kodu test ederken küme binlerce kat hızlı çıktı; senin bilgisayarında ya da Colab’da sayı farklı olacak, ama fark her zaman çok büyük. Büyük bir veride “bu eleman var mı?” sorusunu çok kez soracaksan küme kullan.

    Alıştırmalar

    1. [3, 1, 3, 2, 1, 5] listesindeki tekrarları kaldır ve sonucu küçükten büyüğe sıralı bir liste olarak yazdır.
    2. 1’den 20’ye kadar olan sayılardan 3’e bölünebilenlerin karelerini liste üreteciyle bul.
    3. “programlama” ve “algoritma” kelimelerinde ortak olan harfleri bul.
    4. {"elma": 30, "muz": 45, "kiraz": 80} sözlüğünden fiyatı 40’tan büyük olanları sözlük üreteciyle seç ve fiyatlara %10 zam yap.

    Cevaplar Colab not defterinin sonunda.

    Bu derste ne öğrendik?

    • Küme her elemanı bir kez tutar ve sıra tutmaz; indeksle eleman alınamaz.
    • Boş küme set() ile kurulur; {} boş sözlüktür.
    • |, &, -, ^ ile birleşim, kesişim, fark ve simetrik fark alınır.
    • Liste üretecinde sondaki if filtreler, baştaki if ... else dönüştürür.
    • Aynı yazımla sözlük ({k: v for ...}) ve küme ({x for ...}) üretilir.
    • Kümede in ile arama, listede aramaktan çok daha hızlıdır.

    Sıradaki ders

    Python Dersi 13’te programlarımızın hata karşısında çökmemesini sağlıyoruz: try ve except.

    Devamını oku

  • Harry Potter’ın Seçmen Şapkası: Basit Bir Sınıflandırma Modeli

    Harry Potter’ın Seçmen Şapkası: Basit Bir Sınıflandırma Modeli

    Hogwarts’a gelen her öğrenci başına eski bir şapka takıyor ve şapka birkaç saniye içinde karar veriyor: Gryffindor, Ravenclaw, Hufflepuff ya da Slytherin. Bir veri bilimci gözüyle bakınca Seçmen Şapkası aslında bir sınıflandırma modeli: girdi olarak bir öğrenciyi alıyor, çıktı olarak dört etiketten birini veriyor.

    Bu yazıda kendi şapkamızı iki kez kuracağız. Önce elle yazılmış kurallarla, sonra örneklerden öğrenen bir karar ağacıyla. Yolda makine öğreniminin üç temel fikrine değeceğiz: eğitim ve test verisi, modelin nerede yanıldığını görmek ve aşırı öğrenme.

    Hogwarts Legacy oyununda şapka beni Ravenclaw’a göndermişti. Bu yazı için de aklımdaki soru şuydu: Bu kararı bir model verseydi, neye bakarak verirdi?

    Kodların hepsi Colab’da hazır, kurulum gerekmiyor: Colab’da Aç

    Veri hakkında: Yazıdaki öğrencilerin hepsi hayali. Veriyi kod kendisi üretiyor; kitaplardan ya da filmlerden hiçbir karakter, metin veya görsel kullanmıyoruz.

    Şapkaya ne soruyoruz?

    Her öğrenciyi dört özellikle tarif edelim ve her birine 0 ile 10 arasında puan verelim: cesaret, zeka, sadakat ve hırs. Her binanın öne çıkardığı bir özellik var: Gryffindor cesareti, Ravenclaw zekayı, Hufflepuff sadakati, Slytherin hırsı.

    Makine öğrenimi dilinde bu dört puan öznitelik (feature), bina adı ise etiket (label). Modelin işi özniteliklere bakıp etiketi tahmin etmek.

    1. Kural tabanlı şapka

    En akla yatkın kural: öğrencinin en yüksek özelliğine bak, o özelliğin binasına gönder.

    OZELLIKLER = ["cesaret", "zeka", "sadakat", "hirs"]
    BINALAR = {"Gryffindor": "cesaret", "Ravenclaw": "zeka",
    "Hufflepuff": "sadakat", "Slytherin": "hirs"}
    def kural_sapka(ogrenci):
    """En yüksek puanlı özelliğe bakıp binayı seçer."""
    en_guclu = max(OZELLIKLER, key=lambda o: ogrenci[o])
    for bina, ozellik in BINALAR.items():
    if ozellik == en_guclu:
    return bina
    print(kural_sapka({"cesaret": 9, "zeka": 6, "sadakat": 7, "hirs": 4}))
    # Gryffindor
    print(kural_sapka({"cesaret": 5.2, "zeka": 5.4, "sadakat": 5.1, "hirs": 5.3}))
    # Ravenclaw

    İlk öğrencide sorun yok. İkincisine bak: dört özelliği de neredeyse eşit, zekası sadece 0,1 puan önde diye Ravenclaw’a gidiyor. Kuralın bu öğrenci hakkında “emin değilim” deme imkanı yok. İnsan eliyle yazılan kuralların genel derdi bu: düşündüğün durumlarda çalışıyor, düşünmediğin durumlarda sessizce yanılıyor.

    max satırındaki key=lambda o: ogrenci[o] ifadesi, “özellik adlarını karşılaştırırken her birinin puanına bak” demek. Fonksiyonları bugünkü Python Dersi 9’da anlattım; lambda ise tek satırlık, isimsiz bir fonksiyon.

    2. Hayali öğrenciler üretmek

    Model örneklerden öğreneceği için bize etiketli veri lazım. Her binadan 60, toplam 240 hayali öğrenci üretelim. Gryffindor, Ravenclaw ve Slytherin öğrencilerinde binanın özelliği belirgin şekilde yüksek olsun.

    Hufflepuff’a bir büküm ekleyelim. Hufflepuff, kapısını herkese açan bina olarak bilinir. Bu yüzden öğrencilerin yarısında sadakat yüksek, diğer yarısında ise hiçbir özellik öne çıkmıyor. Kural tabanlı şapka bu ikinci grubu bilmiyor; bakalım model fark edebilecek mi?

    import numpy as np
    import pandas as pd
    rng = np.random.default_rng(42)
    satirlar = []
    for bina, baskin in BINALAR.items():
    for i in range(60):
    if bina == "Hufflepuff" and i % 2 == 1:
    # Dengeli öğrenci: hiçbir özellik öne çıkmıyor
    ogr = {o: rng.normal(5, 0.7) for o in OZELLIKLER}
    ogr["sadakat"] = rng.normal(5.5, 0.7)
    else:
    ogr = {o: rng.normal(4.5, 1.2) for o in OZELLIKLER}
    ogr[baskin] = rng.normal(8, 1)
    ogr = {o: float(np.clip(round(v, 1), 0, 10)) for o, v in ogr.items()}
    ogr["bina"] = bina
    satirlar.append(ogr)
    df = pd.DataFrame(satirlar)
    print(df.groupby("bina")[OZELLIKLER].mean().round(1))
                cesaret  zeka  sadakat  hirs
    bina
    Gryffindor      7.8   4.4      4.5   4.6
    Hufflepuff      4.8   4.9      6.5   4.4
    Ravenclaw       4.3   8.1      4.6   4.3
    Slytherin       4.6   4.6      4.5   7.8

    rng.normal(8, 1), ortalaması 8 olan ve çoğunlukla 7 ile 9 arasına düşen rastgele bir sayı üretiyor. np.clip puanları 0 ile 10 arasında tutuyor. default_rng(42) içindeki 42 sayesinde kodu her çalıştırdığında aynı öğrenciler üretiliyor, böylece sen de yazıdaki sonuçların aynısını görüyorsun.

    3. Eğitim ve test verisi

    Bir modeli, öğrendiği örneklerle sınamak sınavdan önce cevap anahtarını vermeye benzer. Bu yüzden veriyi ikiye ayırıyoruz: model 180 öğrenciden öğrenecek, hiç görmediği 60 öğrenciyle sınanacak.

    from sklearn.model_selection import train_test_split
    from sklearn.metrics import accuracy_score
    X = df[OZELLIKLER]
    y = df["bina"]
    X_egitim, X_test, y_egitim, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
    )
    kural_tahmin = [kural_sapka(ogr) for ogr in X_test.to_dict("records")]
    print(f"Kural tabanlı şapkanın doğruluğu: {accuracy_score(y_test, kural_tahmin):.0%}")
    # Kural tabanlı şapkanın doğruluğu: 83%

    stratify=y, test grubunda her binadan eşit sayıda (15’er) öğrenci olmasını sağlıyor. Kural tabanlı şapka 60 test öğrencisinin 50’sini doğru yerleştirdi. Kötü değil; şimdi bunu geçmeye çalışalım.

    4. Karar ağacı: şapkaya örneklerden öğretmek

    Karar ağacı, veriye bakıp kendi evet-hayır sorularını oluşturan bir model. “Zeka 6,35’ten büyük mü?” diye sorar, cevaba göre bir dala geçer, sonra yeni bir soru sorar. Yani yaptığı şey bizim if-else kuralımıza çok benziyor; farkı, kuralları bizim yerimize veriden çıkarması.

    from sklearn.tree import DecisionTreeClassifier, export_text
    model = DecisionTreeClassifier(max_depth=3, random_state=42)
    model.fit(X_egitim, y_egitim)
    tahmin = model.predict(X_test)
    print(f"Karar ağacının doğruluğu: {accuracy_score(y_test, tahmin):.0%}")
    # Karar ağacının doğruluğu: 88%

    max_depth=3, ağacın en fazla üç soru üst üste sorabileceği anlamına geliyor. fit öğrenme adımı, predict tahmin adımı. Ağaç 60 öğrencinin 53’ünü doğru yerleştirdi.

    Karar ağacının güzel tarafı, öğrendiği kuralları okuyabilmemiz:

    print(export_text(model, feature_names=OZELLIKLER))
    |--- zeka <= 6.35
    | |--- hirs <= 6.45
    | | |--- cesaret <= 5.85
    | | | |--- class: Hufflepuff
    | | |--- cesaret > 5.85
    | | | |--- class: Gryffindor
    | |--- hirs > 6.45
    | | |--- cesaret <= 8.30
    | | | |--- class: Slytherin
    | | |--- cesaret > 8.30
    | | | |--- class: Gryffindor
    |--- zeka > 6.35
    | |--- hirs <= 7.30
    | | |--- cesaret <= 7.50
    | | | |--- class: Ravenclaw
    | | |--- cesaret > 7.50
    | | | |--- class: Gryffindor
    | |--- hirs > 7.30
    | | |--- class: Slytherin

    Bu çıktıdaki en ilginç detay şu: ağaç sadakati hiç sormuyor. Hufflepuff’ı “zekası, hırsı ve cesareti yüksek olmayan öğrenci” diye tarif ediyor. Biz veriyi üretirken Hufflepuff’ın yarısını dengeli öğrencilerden oluşturmuştuk; model de bunu bulmuş ve öteki üç binaya girmeyenleri Hufflepuff’a gönderen bir kural çıkarmış. Kural tabanlı şapkanın bilmediği şeyi örneklerden öğrendi.

    5. Şapka nerede yanılıyor?

    Doğruluk tek bir sayı; hangi binaların karıştığını söylemiyor. Bunun için karışıklık matrisine (confusion matrix) bakıyoruz. Satırlar gerçek binayı, sütunlar modelin tahminini gösteriyor:

    Gerçek \ TahminGryffindorRavenclawHufflepuffSlytherin
    Gryffindor14001
    Ravenclaw11400
    Hufflepuff13110
    Slytherin00114

    Köşegendeki sayılar doğru tahminler. Hataların çoğu Hufflepuff satırında: 15 Hufflepuff öğrencisinin 3’ü Ravenclaw’a gitmiş. Bunlar büyük ihtimalle zekası biraz yüksek çıkan dengeli öğrenciler. Gerçek bir projede bir sonraki adım bu örneklere tek tek bakmak olurdu.

    6. Ağacı büyütmek her zaman iyi mi?

    Derinlik 3 yerine 10 olsa daha mı iyi olur? Farklı derinlikleri deneyip hem eğitim hem test doğruluğuna bakalım:

    for d in [1, 2, 3, 4, 5, 6, 8, 10]:
    m = DecisionTreeClassifier(max_depth=d, random_state=42).fit(X_egitim, y_egitim)
    egitim = accuracy_score(y_egitim, m.predict(X_egitim))
    test = accuracy_score(y_test, m.predict(X_test))
    print(f"derinlik {d:>2}: eğitim {egitim:.0%}, test {test:.0%}")
    derinlik 1: eğitim 49%, test 47%
    derinlik 2: eğitim 72%, test 67%
    derinlik 3: eğitim 94%, test 88%
    derinlik 4: eğitim 97%, test 90%
    derinlik 5: eğitim 98%, test 90%
    derinlik 6: eğitim 99%, test 90%
    derinlik 8: eğitim 100%, test 90%
    derinlik 10: eğitim 100%, test 90%

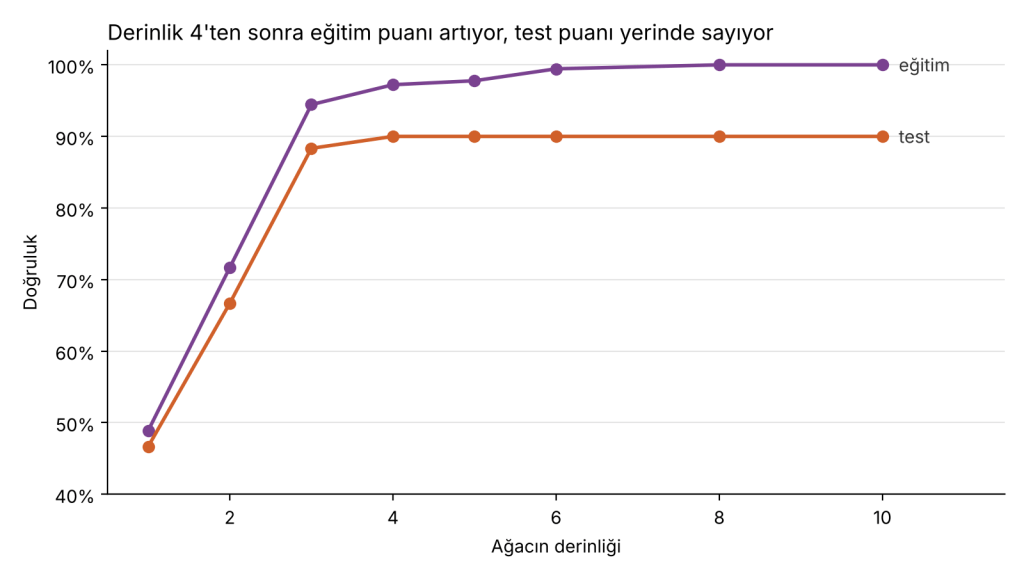
    Derinlik 8’de ağaç eğitim verisindeki her öğrenciyi doğru yerleştiriyor, ama yeni öğrencilerde derinlik 4’ten hiç daha iyi değil. Ekstra sorular genel bir kural öğrenmiyor, eğitimdeki tek tek öğrencileri ezberliyor. Buna aşırı öğrenme (overfitting) deniyor ve makine öğreniminde eğitim puanına tek başına güvenmememizin sebebi bu. Bizim örneğimizde zararı yok gibi görünüyor; daha gürültülü gerçek verilerde ise ezberleyen model test puanını da düşürebilir. Derinlik 3 de 4’e çok yakın sonuç veriyor ve kuralları bir bakışta okunabiliyor; yazıda bu yüzden onu seçtim.

    7. Berabere kalınca ne olur?

    Model, tahminin yanında her bina için bir olasılık da veriyor. Bunu bir fonksiyona saralım:

    def sapka(cesaret, zeka, sadakat, hirs):
    ogr = pd.DataFrame([{"cesaret": cesaret, "zeka": zeka, "sadakat": sadakat, "hirs": hirs}])
    olasiliklar = model.predict_proba(ogr)[0]
    for bina, p in sorted(zip(model.classes_, olasiliklar), key=lambda x: -x[1]):
    if p > 0:
    print(f"{bina:<11} {p:.0%}")
    print("Şapkanın kararı:", model.predict(ogr)[0])
    sapka(cesaret=9, zeka=5, sadakat=4, hirs=5)
    Gryffindor 89%
    Hufflepuff 9%
    Slytherin 2%
    Şapkanın kararı: Gryffindor

    Şimdi cesareti ve hırsı tam olarak eşit bir öğrenci deneyelim:

    berabere = {"cesaret": 8, "zeka": 5, "sadakat": 5, "hirs": 8}
    print("Kural tabanlı şapka:", kural_sapka(berabere))
    sapka(**berabere)
    Kural tabanlı şapka: Gryffindor
    Slytherin 98%
    Hufflepuff 2%
    Şapkanın kararı: Slytherin

    İki şapka iki farklı binayı seçti ve ikisinin de sebebi ilginç. Kural tabanlı şapka Gryffindor diyor, çünkü max eşitlikte listede önce gelen özelliği seçiyor. Yani kararı öğrenci değil, benim listeyi yazma sıram verdi. Karar ağacı ise %98 eminlikle Slytherin diyor, çünkü kurallarından biri “hırs yüksekse ve cesaret 8,30’u geçmiyorsa Slytherin”.

    Buradan çıkacak ders şu: Modelin %98 demesi gerçekten bu kadar emin olduğu anlamına gelmiyor. Karar ağacı olasılığı, öğrencinin düştüğü yapraktaki eğitim örneklerinin oranından hesaplıyor. O yaprakta neredeyse hep Slytherin öğrencileri olduğu için sayı yüksek çıkıyor. Tam sınırdaki bir öğrenci için bile. Olasılık çıktısını okurken bunu akılda tutmak gerekiyor.

    8. Kendi şapkanı tak

    Not defterinin sonunda dört soruluk küçük bir test var. Her özelliğe kendine 0 ile 10 arası puan veriyorsun, şapka da kararını ve olasılıkları yazıyor:

    puanlar = {}
    for o in OZELLIKLER:
    puanlar[o] = float(input(f"{o} (0-10): "))
    sapka(**puanlar)

    sapka(**puanlar) satırındaki iki yıldız, sözlükteki anahtarları isimli argümanlara çeviriyor. Yani sapka(cesaret=..., zeka=..., ...) yazmakla aynı şey.

    Bu projede ne öğrendik?

    • Sınıflandırma: özniteliklere bakıp bir etiket tahmin etmek.
    • Kural tabanlı sistemler düşündüğün durumlarda çalışır; örneklerden öğrenen model, senin görmediğin kalıpları bulabilir.
    • Modeli her zaman görmediği verilerle sına.
    • Karışıklık matrisi, hatanın nerede olduğunu gösterir.
    • Eğitim puanı yüzde 100 olan model iyi bir model olmayabilir; aşırı öğrenmeye dikkat.
    • Olasılık çıktısı her zaman gerçek bir eminlik ölçüsü değil.

    Kendin dene

    1. max_depth değerini 2 ve 5 yapıp kuralların nasıl değiştiğine bak.
    2. default_rng(42) içindeki 42’yi değiştir. Sonuçlar ne kadar oynuyor?
    3. Veriye beşinci bir özellik ekle (örneğin merak) ve hangi binada yüksek olacağına sen karar ver.
    4. Karar ağacı yerine KNeighborsClassifier(n_neighbors=5) dene ve olasılıkların nasıl değiştiğini karşılaştır.

    Devamını oku

  • Netflix İzleme Geçmişi Panosu 2: Streamlit ile Panoya Dönüştürmek

    Netflix İzleme Geçmişi Panosu 2: Streamlit ile Panoya Dönüştürmek

    İlk bölümde Netflix izleme geçmişimi indirip temizledim ve not defterinde ona sorular sordum: En çok hangi diziyi izlemişim, hangi günler daha çok izliyorum, maraton günüm hangisi? Ama not defteri, cevabı görmek için her seferinde kod çalıştırmayı gerektiriyor. Bu bölümde aynı kodu, tıklayıp filtreleyebileceğin bir web panosuna çeviriyoruz. Hem de HTML ya da JavaScript bilmeden, sadece Python ile.

    Uygulamanın tüm kodu GitHub’da: pop-kultur-kodluyorum / netflix-pano.

    Streamlit nedir?

    Streamlit, Python koduyla web uygulaması yapmayı sağlayan açık kaynak bir kütüphane. Veri bilimcilerin en sevdiği araçlardan biri, çünkü mantığı çok basit: Bir Python dosyası yazıyorsun, st.title("Merhaba") dersen sayfada başlık, st.bar_chart(veri) dersen grafik çıkıyor. Biri bir düğmeye bastığında ya da bir filtreyi değiştirdiğinde Streamlit dosyayı yukarıdan aşağı yeniden çalıştırır ve sayfayı günceller.

    Bu “her etkileşimde yeniden çalıştır” fikri başta garip gelebilir, ama işi çok kolaylaştırıyor: Kodu not defterinde yazar gibi yukarıdan aşağı yazıyorsun, gerisini Streamlit hallediyor.

    Kurulum

    Streamlit kendi bilgisayarında çalışır (Colab’da doğrudan çalışmaz). Terminalde:

    pip install streamlit pandas altair

    Kurulumu denemek için streamlit hello yazabilirsin; tarayıcında bir örnek uygulama açılır.

    Uygulamanın parçaları

    Uygulama tek bir dosya: app.py. Altı bölümden oluşuyor. Tamamı GitHub’da; burada her bölümün önemli satırlarını anlatıyorum.

    1. Temizleme fonksiyonları: ilk bölümden aynen

    Tarihleri çözen tarihi_coz ve diziyi filmden ayıran ayir fonksiyonlarını ilk bölümden hiç değiştirmeden taşıdım. Hepsini tek bir fonksiyonda topladım:

    @st.cache_data
    def veriyi_hazirla(ham):
    df = ham.rename(columns={"Title": "baslik", "Date": "tarih"})
    df["tarih"] = tarihi_coz(df["tarih"])
    df = df.dropna(subset=["tarih"])
    df[["isim", "tur"]] = df["baslik"].apply(lambda b: pd.Series(ayir(b)))
    # ... ikinci adım: tekrar eden ön ekleri dizi say
    return df

    @st.cache_data satırı bir dekoratör: fonksiyonun üstüne yapışan bir etiket gibi düşün. Streamlit’e “bu fonksiyonu aynı veriyle tekrar çağırırlarsa baştan hesaplama, önceki sonucu ver” diyor. Her filtre değişikliğinde dosya yeniden çalıştığı için bu önemli; yoksa binlerce satırı her tıklamada yeniden temizlerdik.

    2. Dosyayı almak

    dosya = st.file_uploader("NetflixViewingHistory.csv dosyanı yükle", type="csv")
    if dosya is None:
    st.info("Henüz dosya yüklemedin. Aşağıda hayali bir örnek veriyle gösteriyorum.")
    df = veriyi_hazirla(ornek_veri())
    else:
    df = veriyi_hazirla(pd.read_csv(dosya))

    st.file_uploader sayfaya bir dosya yükleme kutusu koyar. Kullanıcı henüz dosya seçmediyse None döner; o zaman pano boş kalmasın diye hayali bir örnek veri gösteriyoruz. Bu örnek veri tamamen uydurma dizi isimlerinden oluşuyor.

    3. Filtreler: kenar çubuğu

    with st.sidebar:
    yillar = sorted(df["tarih"].dt.year.unique())
    secilen_yillar = st.multiselect("Yıl", yillar, default=yillar)
    tur = st.radio("Tür", ["Hepsi", "Dizi", "Film"], horizontal=True)
    f = df[df["tarih"].dt.year.isin(secilen_yillar)]
    if tur != "Hepsi":
    f = f[f["tur"] == tur]

    with st.sidebar: bloğunun içine yazılan her şey sol taraftaki kenar çubuğuna gider. st.multiselect birden fazla yıl seçmeye, st.radio türlerden birini seçmeye yarıyor. Seçimler sıradan Python değişkenlerine düşüyor; sonra pandas ile tabloyu filtreliyoruz. Sayfanın geri kalanı hep bu filtrelenmiş f tablosunu kullanıyor, böylece bir filtre değişince tüm pano birlikte değişiyor.

    4. Özet kartları

    k1, k2, k3, k4 = st.columns(4)
    k1.metric("Toplam kayıt", len(f))
    k2.metric("Farklı dizi", f.loc[f["tur"] == "Dizi", "isim"].nunique())
    k3.metric("Film", int((f["tur"] == "Film").sum()))
    k4.metric("Maraton günü", f"{gunluk.max()} kayıt")

    st.columns(4) sayfayı dört eşit sütuna böler, metric da her sütuna büyük bir sayı koyar. Panonun en üstündeki özet buradan geliyor.

    5. Grafikler

    Streamlit’in kendi st.bar_chart fonksiyonu hızlı ama günlerin sırasını alfabetik yapıyor (Cuma, Cumartesi, Çarşamba…). Haftanın günlerini doğru sırada göstermek ve renkleri seçmek için Streamlit’le birlikte gelen Altair kütüphanesini kullandım. Aynı çubuk grafiği üç yerde kullanacağım için küçük bir fonksiyon yazdım:

    def cubuk(veri, x, y, renk=BOGURTLEN, sira=None, x_baslik="", y_baslik="Kayıt"):
    return (
    alt.Chart(veri)
    .mark_bar(color=renk, cornerRadiusEnd=4)
    .encode(
    x=alt.X(x, sort=sira, title=x_baslik),
    y=alt.Y(y, title=y_baslik),
    tooltip=[x, y],
    )
    )

    sort=sira parametresine ["Pazartesi", "Salı", ...] listesini verince günler doğru sıraya diziliyor. tooltip da fareyle çubuğun üzerine gelince sayıyı gösteriyor. Grafiği sayfaya koymak için st.altair_chart(grafik) yeterli. (GitHub’daki tam sürümde eksen biçimleri için birkaç ayar daha var.)

    En çok izlenen 10 dizi ise grafik değil tablo: st.dataframe(ilk10, hide_index=True). Uzun dizi isimleri tabloda daha rahat okunuyor.

    6. Bir diziye yakından bak

    diziler = f.loc[f["tur"] == "Dizi", "isim"].value_counts().index.tolist()
    secilen = st.selectbox("Dizi seç", diziler)
    d = f[f["isim"] == secilen]

    st.selectbox bir açılır menü koyar. Liste en çok izlenenden en aza doğru sıralı. Bir dizi seçince ilk ve son izleme tarihini ve o dizinin aylara göre grafiğini gösteriyoruz. Bir diziyi birkaç haftada bitirip bitirmediğini ya da yıllara yayıp yaymadığını bu grafikte görebiliyorsun.

    Çalıştırmak

    1. GitHub’dan netflix-pano klasörünü indir (ya da depoyu klonla).
    2. Terminalde o klasöre gir ve pip install -r requirements.txt yaz.
    3. streamlit run app.py yaz. Tarayıcında pano açılır.
    4. Netflix’ten indirdiğin NetflixViewingHistory.csv dosyasını yükleme kutusuna sürükle.

    Dosyayı Netflix’ten nasıl indireceğini ilk bölümde adım adım anlattım.

    Panoyu internete koymak

    Panoyu arkadaşlarınla paylaşmak istersen Streamlit Community Cloud’u kullanabilirsin: GitHub hesabınla giriş yapıp deponu ve app.py dosyasını seçiyorsun, uygulama birkaç dakika içinde bir web adresinde yayına giriyor. Uygulama kimsenin verisini kendi içinde taşımıyor; her ziyaretçi kendi dosyasını yüklüyor.

    Gizlilik notu: Uygulama yüklenen dosyayı hiçbir yere kaydetmiyor, sadece açık olan oturumda işliyor. Yine de ham CSV dosyanı GitHub gibi herkese açık bir yere koyma. İzleme geçmişi, ne zaman uyanık olduğuna kadar çok şey anlatır. Paylaşırken sadece toplamları ve grafikleri paylaş; ben de bu yazıda öyle yaptım.

    Panoda ne gördüm?

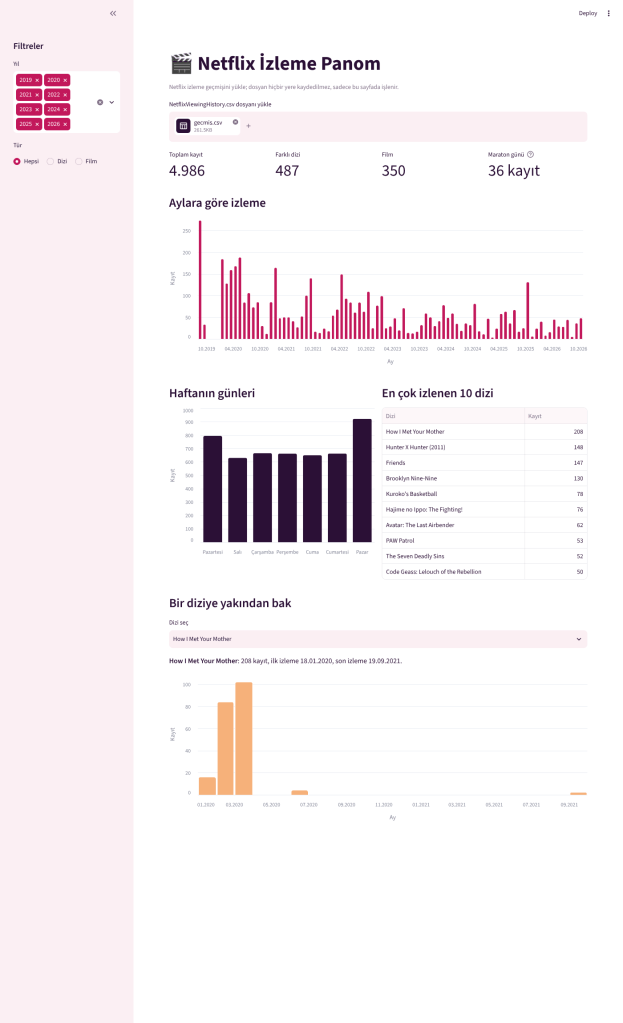
    Kendi verimi yükleyince pano şunları gösterdi:

    • Ağustos 2019’dan bu yana toplam 4.986 kayıt, 487 farklı dizi ve 350 film.
    • Haftanın en çok izlediğim günü Pazar, ikinci sırada Pazartesi. Hafta içinin diğer günleri birbirine çok yakın.
    • Maraton günümde 36 kayıt var.

    Kendin dene

    • Kenar çubuğuna bir saat filtresi ekleyemezsin, çünkü Netflix dosyasında saat yok. Ama bir ay filtresi ekleyebilirsin: st.slider ile 1-12 arası seçim yap.
    • “En çok izlenen 10 dizi” yerine kullanıcının kaç dizi görmek istediğini seçmesini sağla: st.number_input("Kaç dizi?", 5, 30, 10).
    • Bir arkadaşınla karşılaştır: İki dosya yükletip iki kişinin haftalık çubuklarını yan yana göster.

    Bir sonraki pop kültür projesinde Netflix verisini bir adım daha ileri taşıyıp basit bir öneri sistemi yazacağız: “Netflix’te Ne İzlesem?”

  • Squid Game’deki Cam Köprüyü Python ile Simüle Etmek: Hayatta Kalma Olasılığı

    Squid Game’deki Cam Köprüyü Python ile Simüle Etmek: Hayatta Kalma Olasılığı

    Squid Game’in cam köprü bölümünü izlerken aklımdan geçen ilk soru şuydu: sıranı seçebilseydin kaçıncı olmak isterdin? Bu yazıda bu soruyu Python’la cevaplıyorum. Önce oyunu 100.000 kez simüle edeceğiz, sonra aynı sonucu basit bir olasılık formülüyle doğrulayacağız.

    Kodun tamamı Colab’da hazır: Colab’da Aç

    Squid Game hakkında kısaca

    Squid Game, Hwang Dong-hyuk’un yarattığı, yazdığı ve yönettiği Güney Kore yapımı bir dizi. İlk sezonu 17 Eylül 2021’de Netflix’te dokuz bölüm olarak yayımlandı. Netflix’in açıklamasına göre ilk 28 günde 142 milyondan fazla hanede izlendi ve 1,65 milyar saatlik izlenmeye ulaştı.

    Hikâyede borca batık 456 kişi, büyük bir para ödülü için çocuk oyunlarından oluşan bir yarışmaya katılıyor. Oyunlar tanıdık, kuralları basit; ama kaybedenler elendiğinde hayatını kaybediyor. Dizinin adı da Kore’de çocukların oynadığı bir sokak oyunundan geliyor. Basit kuralların ardına saklı büyük riskler, diziyi olasılık ve oyun teorisi merakları için de ilginç bir malzeme yapıyor.

    Cam köprü oyunu

    Yedinci bölümde (“VIPS”) oyuncular iki sıra cam panelden oluşan bir köprüyü geçmek zorunda. Her adımda biri sağda biri solda iki panel var. Biri temperli cam ve bir insanı taşıyor, diğeri sıradan cam ve kırılıyor. Dışarıdan bakınca ikisi aynı görünüyor.

    Aslında bu bir yazı tura oyunu, ama bir farkla: oyuncular sırayla geçiyor ve arkadakiler öndekilerin bastığı yerleri görüyor. Önden giden biri doğru cama basarsa o adım artık herkes için güvenli. Yanlış cama basarsa düşüyor, ama o adımda diğer camın doğru olduğu da ortaya çıkıyor. Yani her bilinmeyen adım ya bir kişinin şansıyla ya da bir kişinin düşüşüyle çözülüyor.

    Modelin varsayımları

    Matematikçilerin bu oyun için kurduğu modelleri esas aldım (Chalkdust dergisindeki analiz gibi):

    • Köprü 18 adım, oyuncu sayısı 16.
    • Her adımda iki cam eşit olasılıklı: doğruyu seçme şansı %50.
    • Oyuncular camları ayırt edemiyor ve öndekilerin açtığı yolu hatasız hatırlıyor.
    • Süre sınırı, itip kakma ya da ışıkların kapatılması gibi dizideki olaylar modelde yok.

    Bu varsayımlar gerçek dünyayı basitleştiriyor. Bunun bedelini yazının sonunda, dizideki sonuçla karşılaştırırken göreceğiz.

    Simülasyonu yazmak

    Simülasyon, bir olayı bilgisayarda binlerce kez tekrar oynatıp ne sıklıkla ne olduğunu saymak demek. Gerçek hayatta bu oyunu 100.000 kez oynatamayız ama bilgisayarda birkaç saniyede yapabiliriz.

    Tek bir oyunu oynatan fonksiyon şöyle:

    import numpy as np
    def kopruyu_gec(oyuncu=16, adim=18, rng=None):
    """Bir oyunu simüle eder; hayatta kalan oyuncuların sıra numaralarını döndürür."""
    rng = rng or np.random.default_rng()
    bilinen = 0 # öndekilerin açtığı yol buraya kadar güvenli
    kalanlar = []
    for sira in range(1, oyuncu + 1):
    konum = bilinen # bilinen yolu güvenle yürü
    hayatta = True
    while konum < adim:
    konum += 1 # bir sonraki bilinmeyen adıma bas
    if rng.random() >= 0.5: # yazı tura: yanlış cam
    hayatta = False # düştü, ama bu adım artık biliniyor
    break
    bilinen = konum
    if hayatta:
    # bu oyuncu köprüyü bitirdi; arkadakiler de açılan yoldan geçer
    kalanlar = list(range(sira, oyuncu + 1))
    break
    return kalanlar

    Kodun mantığı adım adım:

    1. bilinen değişkeni, önceki oyuncuların çözdüğü son adımı tutuyor. Başta 0, yani hiçbir adım bilinmiyor.
    2. Sıradaki oyuncu bilinen yolu güvenle yürüyüp ilk bilinmeyen adımdan itibaren yazı tura atmaya başlıyor.
    3. Yanlış cama basarsa düşüyor. Ama bastığı adım da artık biliniyor, çünkü kırılan camın yanındaki doğru cam.
    4. Bir oyuncu 18. adımı geçerse köprü tamamen çözülmüş oluyor; ondan sonraki herkes güvenle geçiyor.

    rng.random() 0 ile 1 arasında rastgele bir sayı üretiyor. Sayının 0,5’ten küçük olma ihtimali tam %50, yani bu bir yazı tura.

    100.000 kez oynatmak

    rng = np.random.default_rng(42) # aynı sonucu tekrar alabilmek için tohum
    N = 100_000
    hayatta_kalma = np.zeros(17) # her sıra numarası için kaç kez hayatta kaldı
    kalan_sayilari = []
    for _ in range(N):
    kalanlar = kopruyu_gec(rng=rng)
    kalan_sayilari.append(len(kalanlar))
    for sira in kalanlar:
    hayatta_kalma[sira] += 1
    olasilik = hayatta_kalma[1:] / N # 1'den 16'ya kadar her sıranın hayatta kalma oranı
    print("Ortalama hayatta kalan:", np.mean(kalan_sayilari))

    default_rng(42) içindeki 42 bir “tohum” (seed). Rastgele sayıları her seferinde aynı sırayla üretir, böylece sen de not defterini çalıştırdığında benimle aynı sonucu alırsın.

    Sonuçlar: sıran ne kadar önemli?

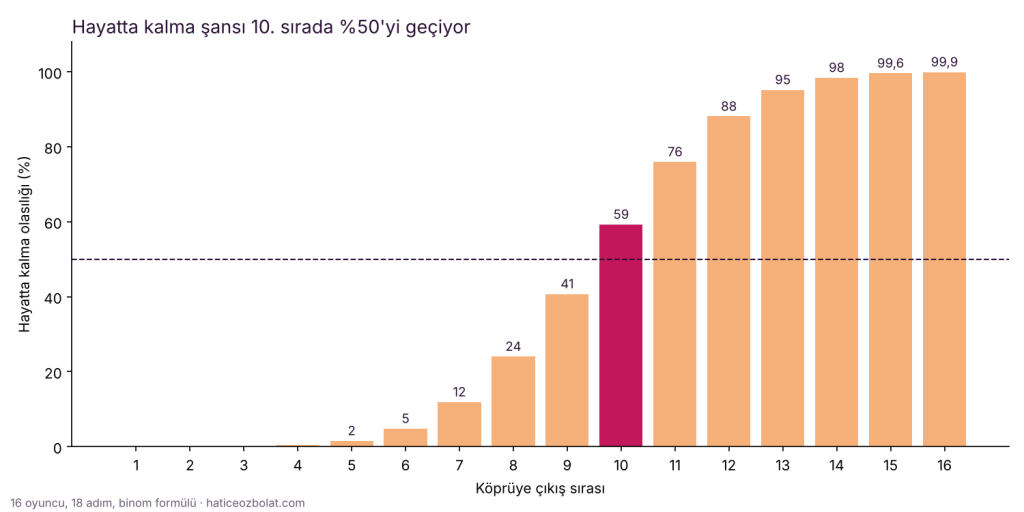
    100.000 oyunun sonunda ortalama 7,0 oyuncu köprüyü geçti. Asıl ilginç olan, bu yedi kişinin kim olduğu:

    İlk sıradaki oyuncunun köprüyü geçmesi için 18 yazı turanın hepsini bilmesi gerekiyor: yaklaşık 262.000’de 1. Son sıradaki oyuncu ise neredeyse kesin geçiyor (%99,93). Eğri ortada çok dikleşiyor: 8. sırada %24 olan şans 10. sırada %59’a, 12. sırada %88’e çıkıyor. Yani dizideki gibi sıra numarasını görmeden seçmek, bu oyundaki en büyük kumar.

    Bir de en az bir kişinin köprüyü geçme ihtimali var: simülasyonda 100.000 oyunun %99,94’ünde en az bir kişi karşıya ulaştı.

    Aynı sonucu formülle bulmak

    Simülasyon güzel ama sonucun doğru olduğundan nasıl emin olacağız? Bu oyunun aslında çok basit bir matematiksel yapısı var.

    Şöyle düşün: 18 adımın her biri bir kez, ilk basan kişi tarafından “çözülüyor”. Her çözümde %50 ihtimalle biri düşüyor. Yani köprünün tamamında toplam kaç kişinin düşeceği, 18 kez yazı tura atıp kaç kez tura geldiğini saymakla aynı şey. Bu, olasılıkta binom dağılımı denen yapı.

    k. sıradaki oyuncu, toplamda k’den az kişi düşerse hayatta kalıyor. 18 atışta tam d kez tura gelme olasılığı C(18, d) / 2¹⁸, bunları 0’dan k − 1’e kadar topladığımızda cevabı buluyoruz:

    from math import comb
    def tam_olasilik(oyuncu=16, adim=18):
    """k. oyuncunun hayatta kalma olasılığı: 18 adımda k'den az düşüş olması."""
    return [sum(comb(adim, d) for d in range(k)) / 2 ** adim for k in range(1, oyuncu + 1)]
    olasiliklar = tam_olasilik()
    print(f"Beklenen hayatta kalan: {sum(olasiliklar):.2f}") # 7.00

    comb(18, d), 18 adımın hangi d tanesinde birinin düşeceğini seçmenin kaç yolu olduğunu veriyor. Formülün sonuçları simülasyonla her sırada en fazla 0,3 puan farklı; bu fark da sadece rastgelelikten. Beklenen hayatta kalan sayısı da yine 7.

    Buradan bir sezgi daha çıkıyor: ortalamada 18 adımın yarısında, yani 9 adımda biri düşüyor. 16 kişiden 9’u düşerse geriye 7 kişi kalır.

    Peki dizide neden sadece 3 kişi kaldı?

    Dizide köprüyü yalnızca üç oyuncu tamamlayabiliyor. Modele göre 3 veya daha az kişinin kalma ihtimali sadece %4,8. Peki bu kadar kötü bir sonuç nasıl çıktı?

    Modelimizin dışarıda bıraktığı şeyler dizide yer alıyor. Bölümde ışıkların kapatılması gibi bir avantajın ortadan kaldırılması, oyuncuların birbirine karışması ve süre baskısı var. Bunların her biri, adım başına %50 olan düşme ihtimalini artırıyor ya da bilinen bir adımı tekrar bilinmez hâle getiriyor.

    Bu, her modelin taşıdığı bir uyarı: sonuç, varsayımlar kadar iyi. Matematiğin yanlış olduğunu değil, gerçek dünyanın modelden daha karmaşık olduğunu gösteriyor.

    Diziyi izlerken bu bölümde kalbim kulaklarımdaydı. O sırada aklımdan geçen de şuydu: ben olsam ya ortalardan bir numara ya da 8. sırayı seçerdim. Seçimim tamamen sezgiseldi. Şimdi matematiksel temelini bildiğim için biraz farklı bakıyorum: 8. sırada hayatta kalma şansı %24, sadece iki sıra geride, 10. sırada ise %59. Sezgim beni ortaya yakın bir yere götürmüş ama hesap, birkaç adım daha geride durmanın ne kadar fark yarattığını gösteriyor.

    Kendin dene

    Not defterinde değerleri değiştirip şu soruları cevaplayabilirsin:

    • Köprü 18 değil 30 adım olsaydı kaç kişi kalırdı? (kopruyu_gec(adim=30))
    • Oyuncular camları biraz ayırt edebilseydi, doğruyu bulma şansı %50 yerine %60 olsaydı ne değişirdi? (Fonksiyondaki 0.5‘i değiştir.)
    • 16 oyuncunun kaçının hayatta kaldığının dağılımını histogram olarak çiz. En sık görülen sonuç hangisi?

  • Kod Kartı: f-string ile Şık Çıktılar

    Kod Kartı: f-string ile Şık Çıktılar

    Ekrana metin ile değişkeni birlikte yazdırmak istediğinde artı işaretleri ve str() çağrılarıyla uğraşmana gerek yok. Metnin başına bir f koy, değişkeni süslü paranteze yaz.

    Bu konuyu videoda da anlattım. İzleyerek öğrenmeyi seviyorsan buradan başlayabilirsin 👇

    Kodları kendin çalıştırmak istersen Colab defteri burada: [Colab linki]

    Kod

    isim = "Ayşe"
    not_ortalamasi = 87.456
    # Eski yol: + ile birleştirmek, sayıyı str() ile metne çevirmek
    print("Merhaba " + isim + ", ortalaman " + str(not_ortalamasi))
    # f-string ile
    print(f"Merhaba {isim}, ortalaman {not_ortalamasi}")
    # Merhaba Ayşe, ortalaman 87.456

    Bu satır nasıl çalışıyor?

    Tırnaktan önceki f, Python’a “bu metnin içindeki süslü parantezlere bak” der. Python her {...} içindeki ifadeyi hesaplar, sonucu metne çevirir ve yerine yazar. Sayıyı kendin metne çevirmen gerekmez.

    Süslü parantezin içine sadece değişken değil, küçük bir işlem de yazabilirsin:

    print(f"Gelecek yıl {2026 + 1} olacak") # Gelecek yıl 2027 olacak
    print(f"İsmin {len(isim)} harfli") # İsmin 4 harfli

    Şık çıktılar: biçimlendirme

    Asıl gücü burada. Süslü parantezin içine iki nokta koyup bir biçim yazabilirsin.

    Virgülden sonra kaç basamak:

    print(f"Ortalaman: {not_ortalamasi:.1f}") # Ortalaman: 87.5

    .1f “virgülden sonra 1 basamak göster” demek; Python yuvarlamayı kendisi yapar.

    Yüzde:

    oran = 0.4567
    print(f"Başarı oranı: {oran:.0%}") # Başarı oranı: 46%

    Hizalı bir tablo:

    urunler = [("Kalem", 12.5), ("Defter", 45), ("Silgi", 7.25)]
    for ad, fiyat in urunler:
    print(f"{ad:<8}{fiyat:>8.2f} TL")
    # Kalem 12.50 TL
    # Defter 45.00 TL
    # Silgi 7.25 TL

    <8 metni 8 karakterlik alana sola, >8.2f sayıyı 8 karakterlik alana sağa yaslıyor ve 2 basamak gösteriyor.

    Hata ayıklama kısayolu: Değişkenin adını da görmek istersen sonuna eşittir koy.

    x = 5
    print(f"{x = }") # x = 5

    Dikkat

    Baştaki f harfini unutursan Python hata vermez ama süslü parantezleri olduğu gibi yazar:

    print("Ortalaman: {not_ortalamasi}") # Ortalaman: {not_ortalamasi}

    Çıktıda süslü parantez görüyorsan ilk bakılacak yer baştaki f.

    f-string’i Python serisinin 4. dersinde, input ve print ile kullanıcıyla konuşan bir program yazarken sık sık kullanacağız.