Etiket: #Yapayzeka

  • SQL Sorularına Hazırlık 1: SELECT, WHERE, GROUP BY ve JOIN Soru Tipleri

    SQL Sorularına Hazırlık 1: SELECT, WHERE, GROUP BY ve JOIN Soru Tipleri

    Sınav ve Mülakat Serisi 1/8

    Veri analisti, veri bilimci ya da yazılım geliştirici ilanlarının çoğunda SQL isteniyor ve teknik mülakatlarda neredeyse her zaman birkaç SQL sorusu karşına çıkıyor. Soruların biçimi farklı olsa da arkasında hep aynı birkaç kalıp var. Bu yazıda en temel dört konuyu, yani filtreleme, gruplama, tablo birleştirme ve sıralamayı, soru tiplerine ayırarak çalışacağız.

    Her soru tipinde önce kısa bir hatırlatma, sonra çözümlü bir örnek, ardından da en sık düşülen tuzak var. Yazının sonunda cevaplarıyla birlikte 10 alıştırma sorusu bulacaksın.

    Not: Buradaki soruların hiçbiri gerçek bir sınavdan ya da mülakattan alınmadı. Hepsi konuyu pekiştirmek için hazırladığım örnekler; veriler de hayali.

    SQL’in ne olduğunu ilk kez öğreniyorsan önce Veritabanı Nedir? SQL ve NoSQL Farkı yazısına göz at.

    Örnek veritabanı

    Tüm soruları iki küçük tablo üzerinden çözeceğiz. Sekiz çalışan ve dört departman var:

    calisanlar

    idaddepartman_idmaassehir
    1Ayşe152000Adana
    2Mert145000İstanbul
    3Zeynep261000İzmir
    4Can248000Adana
    5Elif339000Ankara
    6BurakNULL41000İstanbul
    7Deniz158000Ankara
    8Selin2NULLİstanbul

    departmanlar

    idad
    1Yazılım
    2Veri
    3İnsan Kaynakları
    4Pazarlama

    Dikkat: Burak’ın departmanı yok, Selin’in maaşı boş, Pazarlama’da hiç çalışan yok. Bu üç detayı bilerek koydum; soru hazırlayanlar tuzakları tam da bu tür boşluklara kurar.

    Tabloları kendin kurup sorguları denemek için bu kodu Colab’da çalıştırabilirsin. Python’un içinde gelen sqlite3 modülünü kullanıyor, kurulum gerekmiyor:

    import sqlite3
    db = sqlite3.connect(":memory:")
    db.executescript("""
    CREATE TABLE departmanlar (id INTEGER PRIMARY KEY, ad TEXT);
    CREATE TABLE calisanlar (id INTEGER PRIMARY KEY, ad TEXT, departman_id INTEGER,
    maas INTEGER, sehir TEXT);
    INSERT INTO departmanlar VALUES (1,'Yazılım'),(2,'Veri'),(3,'İnsan Kaynakları'),(4,'Pazarlama');
    INSERT INTO calisanlar VALUES
    (1,'Ayşe',1,52000,'Adana'), (2,'Mert',1,45000,'İstanbul'),
    (3,'Zeynep',2,61000,'İzmir'), (4,'Can',2,48000,'Adana'),
    (5,'Elif',3,39000,'Ankara'), (6,'Burak',NULL,41000,'İstanbul'),
    (7,'Deniz',1,58000,'Ankara'), (8,'Selin',2,NULL,'İstanbul');
    """)
    def sorgu(sql):
    for satir in db.execute(sql):
    print(satir)
    sorgu("SELECT ad, maas FROM calisanlar WHERE maas > 50000")

    Önce bir kavram: SQL hangi sırayla çalışır?

    Sorguyu SELECT ile yazmaya başlıyoruz, ama veritabanı onu başka bir sırayla çalıştırıyor:

    1. FROM ve JOIN: Hangi tablolardan?
    2. WHERE: Hangi satırlar kalsın?
    3. GROUP BY: Satırlar nasıl gruplansın?
    4. HAVING: Hangi gruplar kalsın?
    5. SELECT: Hangi sütunlar gösterilsin?
    6. ORDER BY: Nasıl sıralansın?
    7. LIMIT: Kaç satır gösterilsin?

    Bu sırayı bilmek, aşağıdaki tuzakların çoğunu açıklıyor. Örneğin WHERE gruplamadan önce çalıştığı için içinde COUNT ya da AVG kullanamazsın.

    Soru tipi 1: Filtreleme (WHERE)

    Soru: Maaşı 50.000’den yüksek olan çalışanları maaşa göre büyükten küçüğe listele.

    SELECT ad, maas
    FROM calisanlar
    WHERE maas > 50000
    ORDER BY maas DESC;
    Zeynep 61000
    Deniz 58000
    Ayşe 52000

    WHERE ile birlikte en sık kullanılanlar:

    • IN ('Adana', 'Ankara'): Listedeki değerlerden biri.
    • BETWEEN 40000 AND 55000: İki değer arasında, uçlar dahil.
    • LIKE 'A%': A ile başlayan. % herhangi sayıda karakter, _ tek bir karakter demek.
    • AND, OR, NOT: Koşulları birleştirmek. Karışık koşullarda parantez kullan.

    Tuzak: NULL eşittirle aranmaz

    Maaşı girilmemiş çalışanı bulmak isteyelim:

    SELECT ad FROM calisanlar WHERE maas = NULL; -- hiç sonuç dönmez!
    SELECT ad FROM calisanlar WHERE maas IS NULL; -- Selin

    NULL “bilinmiyor” demek. “Bilinmeyen bir şey bilinmeyen bir şeye eşit mi?” sorusunun cevabı da “bilinmiyor”, yani doğru değil. Bu yüzden NULL her zaman IS NULL ya da IS NOT NULL ile aranır. Mülakatlarda çok sevilen bir soru.

    Soru tipi 2: Gruplama (GROUP BY ve HAVING)

    Soru: Her departmandaki çalışan sayısını ve ortalama maaşı bul.

    SELECT departman_id, COUNT(*) AS kisi, ROUND(AVG(maas)) AS ort_maas
    FROM calisanlar
    GROUP BY departman_id;
    NULL 1 41000
    1 3 51667
    2 3 54500
    3 1 39000

    GROUP BY aynı departman_id‘ye sahip satırları bir araya topluyor, COUNT ve AVG gibi toplama fonksiyonları da her grup için tek bir değer hesaplıyor. Departmanı olmayan Burak, NULL adında kendi grubunu oluşturdu.

    Tuzak 1: COUNT(*) ile COUNT(sütun) aynı şey değil

    SELECT COUNT(*), COUNT(maas) FROM calisanlar; -- 8, 7

    COUNT(*) satırları sayar. COUNT(maas) ise sadece maaşı NULL olmayan satırları sayar.

    Tuzak 2: AVG boş değerleri atlar

    Veri departmanında üç kişi var ama ortalama 54.500 çıktı. Hesaplarsan: (61.000 + 48.000) / 2 = 54.500. Selin’in boş maaşı hesaba hiç katılmadı. Boş maaş sıfır sayılsaydı ortalama 36.333 olurdu. “Ortalama maaş kaç?” sorusunda bu farkı bilmek seni diğer adaylardan ayırır.

    WHERE mi, HAVING mi?

    Soru: En az 3 çalışanı olan departmanları listele.

    SELECT departman_id, COUNT(*) AS kisi
    FROM calisanlar
    GROUP BY departman_id
    HAVING COUNT(*) >= 3;
    1 3
    2 3

    Kural basit: Tek tek satırları elemek için WHERE, gruplamadan sonra grupları elemek için HAVING. WHERE COUNT(*) >= 3 yazarsan hata alırsın, çünkü WHERE çalıştığında henüz grup yok.

    Soru tipi 3: Tabloları birleştirmek (JOIN)

    Soru: Her çalışanın adını ve departmanının adını göster.

    SELECT c.ad, d.ad AS departman
    FROM calisanlar c
    INNER JOIN departmanlar d ON c.departman_id = d.id;

    Bu sorgu 7 satır döndürüyor. Burak yok! INNER JOIN sadece iki tabloda da eşleşmesi olan satırları getiriyor. Burak’ın departmanı olmadığı için elendi.

    Herkesi görmek istiyorsan LEFT JOIN kullan:

    SELECT c.ad, d.ad AS departman
    FROM calisanlar c
    LEFT JOIN departmanlar d ON c.departman_id = d.id;

    LEFT JOIN soldaki tablonun (calisanlar) bütün satırlarını getirir. Eşleşme yoksa sağdaki sütunlar NULL olur. Artık 8 satır var ve Burak’ın departmanı NULL görünüyor.

    Sorgulardaki c ve d tabloların kısa adları (alias). İki tabloda da ad sütunu olduğu için hangisini istediğimizi c.ad ve d.ad diye belirtmek zorundayız.

    Klasik soru: Eşleşmeyenleri bulmak

    Soru: Hiç çalışanı olmayan departmanları bul.

    SELECT d.ad
    FROM departmanlar d
    LEFT JOIN calisanlar c ON c.departman_id = d.id
    WHERE c.id IS NULL;
    Pazarlama

    Mülakatların en sevilen kalıplarından biri: LEFT JOIN ile her şeyi getir, sonra eşleşmesi olmayanları IS NULL ile süzgüle. “Hiç sipariş vermemiş müşteriler”, “hiç derse kaydolmamış öğrenciler” gibi soruların hepsi bu kalıpla çözülüyor.

    Tuzak: LEFT JOIN’den sonra COUNT(*)

    Her departmandaki çalışan sayısını, çalışanı olmayanlar dahil bulalım:

    -- Yanlış: Pazarlama 1 görünür
    SELECT d.ad, COUNT(*) AS kisi
    FROM departmanlar d
    LEFT JOIN calisanlar c ON c.departman_id = d.id
    GROUP BY d.ad;
    -- Doğru: Pazarlama 0 görünür
    SELECT d.ad, COUNT(c.id) AS kisi
    FROM departmanlar d
    LEFT JOIN calisanlar c ON c.departman_id = d.id
    GROUP BY d.ad;

    LEFT JOIN Pazarlama için içi NULL dolu bir satır üretiyor. COUNT(*) o satırı da sayıyor; COUNT(c.id) ise NULL olduğu için saymıyor. Tuzak 1’deki kural burada da işe yarıyor.

    Soru tipi 4: En yüksek N ve “ikinci en yüksek”

    Soru: En yüksek maaş alan 3 çalışanı bul.

    SELECT ad, maas
    FROM calisanlar
    ORDER BY maas DESC
    LIMIT 3;

    Soru: İkinci en yüksek maaşı alan çalışan kim?

    Bu sorunun iki yaygın çözümü var:

    -- 1) Sırala, birini atla, sonrakini al
    SELECT ad, maas FROM calisanlar
    ORDER BY maas DESC
    LIMIT 1 OFFSET 1;
    -- 2) En yüksekten küçük olanların en yükseği
    SELECT ad, maas FROM calisanlar
    WHERE maas < (SELECT MAX(maas) FROM calisanlar)
    ORDER BY maas DESC
    LIMIT 1;

    İkisi de Deniz’i (58.000) buluyor. Farkı şu: En yüksek maaşı iki kişi paylaşsaydı, birinci yöntem ikinci kişiyi yine en yüksek maaşla getirirdi; ikinci yöntem ise gerçekten bir alt maaş basamağını bulurdu. Mülakatta “maaşlar eşit olursa ne olur?” diye sorulması çok olası.

    İkinci yöntemdeki parantez içindeki sorguya alt sorgu deniyor. Alt sorgulara ve bu tür soruları çok daha rahat çözen pencere fonksiyonlarına serinin 5. yazısında bakacağız.

    Hepsi bir arada: çözümlü örnek

    Soru: İzmir dışındaki çalışanları dikkate al. Ortalama maaşı 45.000’den yüksek olan departmanların adını ve ortalama maaşını, büyükten küçüğe sıralayarak listele.

    Soruyu parçalara ayıralım:

    • “Departmanın adı” → iki tabloya da ihtiyacımız var: JOIN.
    • “İzmir dışındaki çalışanlar” → satır filtresi: WHERE.
    • “Departmanların ortalama maaşı” → GROUP BY ve AVG.
    • “Ortalaması 45.000’den yüksek olan” → grup filtresi: HAVING.
    • “Büyükten küçüğe” → ORDER BY ... DESC.
    SELECT d.ad, ROUND(AVG(c.maas)) AS ort
    FROM calisanlar c
    JOIN departmanlar d ON c.departman_id = d.id
    WHERE c.sehir <> 'İzmir'
    GROUP BY d.ad
    HAVING AVG(c.maas) > 45000
    ORDER BY ort DESC;
    Yazılım 51667
    Veri 48000

    Zeynep İzmir’de olduğu için WHERE onu eledi; Veri’de geriye Can ve maaşı boş Selin kaldı, ortalama 48.000 oldu. İnsan Kaynakları’nın ortalaması 39.000 olduğu için HAVING onu eledi. Burak’ın departmanı olmadığı için JOIN onu en başta dışarıda bıraktı.

    Uzun bir soruyla karşılaştığında hep böyle yap: Soruyu cümle cümle oku, her cümleyi bir SQL parçasına çevir.

    [AFFILIATE: SQL alıştırma platformu ya da SQL kursu]

    10 alıştırma sorusu

    Aynı iki tabloyu kullan. Cevaplara bakmadan önce kendin dene; Colab’daki sorgu() fonksiyonuyla sonucunu kontrol edebilirsin.

    1. İstanbul’da çalışanların adlarını listele.
    2. Maaşı 45.000 ile 55.000 arasında (uçlar dahil) olanları ada göre sırala.
    3. Adında “e” harfi geçen çalışanları bul.
    4. Departmanı olmayan kaç çalışan var?
    5. Her şehirde kaç çalışan olduğunu, kalabalıktan aza doğru sırala.
    6. En yüksek ve en düşük maaş arasındaki fark kaç?
    7. En az 2 çalışanı olan şehirlerin ortalama maaşını bul.
    8. Veri departmanındaki çalışanların adlarını listele (departman adıyla filtrele, id ile değil).
    9. Her departmandaki en yüksek maaşı departman adıyla birlikte göster.
    10. 2’den az çalışanı olan departmanları, hiç çalışanı olmayanlar dahil listele.

    Cevaplar

    -- 1) Mert, Burak, Selin
    SELECT ad FROM calisanlar WHERE sehir = 'İstanbul';
    -- 2) Ayşe 52000, Can 48000, Mert 45000
    SELECT ad, maas FROM calisanlar
    WHERE maas BETWEEN 45000 AND 55000
    ORDER BY ad;
    -- 3) Ayşe, Deniz, Elif, Mert, Selin, Zeynep
    -- Not: Elif büyük E ile başlıyor. SQLite'ta LIKE, İngilizce harflerde
    -- büyük-küçük harf ayırmaz; bazı veritabanlarında ayırır.
    SELECT ad FROM calisanlar WHERE ad LIKE '%e%';
    -- 4) 1
    SELECT COUNT(*) FROM calisanlar WHERE departman_id IS NULL;
    -- 5) İstanbul 3, Adana 2, Ankara 2, İzmir 1
    SELECT sehir, COUNT(*) AS kisi FROM calisanlar
    GROUP BY sehir
    ORDER BY kisi DESC;
    -- 6) 22000 (61000 - 39000; Selin'in boş maaşı hesaba girmez)
    SELECT MAX(maas) - MIN(maas) AS fark FROM calisanlar;
    -- 7) Adana 50000, Ankara 48500, İstanbul 43000
    -- (İstanbul'da 3 kişi var ama Selin'in maaşı boş; ortalama Mert ve Burak'tan)
    SELECT sehir, ROUND(AVG(maas)) AS ort FROM calisanlar
    GROUP BY sehir
    HAVING COUNT(*) >= 2
    ORDER BY ort DESC;
    -- 8) Can, Selin, Zeynep
    SELECT c.ad FROM calisanlar c
    JOIN departmanlar d ON c.departman_id = d.id
    WHERE d.ad = 'Veri';
    -- 9) Veri 61000, Yazılım 58000, İnsan Kaynakları 39000
    SELECT d.ad, MAX(c.maas) AS en_yuksek FROM departmanlar d
    JOIN calisanlar c ON c.departman_id = d.id
    GROUP BY d.ad
    ORDER BY en_yuksek DESC;
    -- 10) İnsan Kaynakları 1, Pazarlama 0
    SELECT d.ad, COUNT(c.id) AS kisi FROM departmanlar d
    LEFT JOIN calisanlar c ON c.departman_id = d.id
    GROUP BY d.ad
    HAVING COUNT(c.id) < 2;

    Bu yazıdan aklında kalması gerekenler

    • NULL eşittirle değil, IS NULL ile aranır.
    • COUNT(*) satırları, COUNT(sütun) dolu değerleri sayar. AVG boşları atlar.
    • Satır filtresi WHERE, grup filtresi HAVING.
    • INNER JOIN eşleşmeyenleri eler, LEFT JOIN soldaki herkesi tutar.
    • “Hiç … olmayanlar” sorusu: LEFT JOIN + IS NULL.
    • “İkinci en yüksek” sorusunda eşit değerleri düşün.

    Serinin bir sonraki yazısında başka bir konunun soru tiplerine geçiyoruz. SQL’in devamı, yani alt sorgular ve pencere fonksiyonları, 5. yazıda.
    Devamını oku

  • İlk Mini Proje: Sayı Tahmin Oyunu (Python Dersi 10)

    İlk Mini Proje: Sayı Tahmin Oyunu (Python Dersi 10)

    Dokuz derstir parça parça öğrendik: değişkenler, input, koşullar, döngüler, listeler, sözlükler ve fonksiyonlar. Bu derste yeni bir konu yok. Onun yerine hepsini bir araya getirip gerçekten oynanabilen ilk programımızı yazıyoruz: sayı tahmin oyunu.

    Kural basit: Bilgisayar 1 ile 100 arasında bir sayı tutar. Sen tahmin edersin, o da “daha büyük” ya da “daha küçük” der. Amacın sayıyı olabildiğince az denemede bulmak.

    Oyunu tek seferde yazmayacağız. Her adımda çalışan bir sürüm olacak ve bir sonraki adımda ona bir özellik ekleyeceğiz. Gerçek projeler de böyle büyür.

    Bütün kodlar Colab’da hazır: Colab’da Aç

    Adım 1: Rastgele bir sayı tutmak

    Python’un random modülü rastgele sayı üretiyor. Modül, başkalarının yazıp Python’la birlikte gelen hazır fonksiyonların bulunduğu bir dosya; import ile kullanıma açıyoruz. Modüllere Ders 15’te ayrıntılı bakacağız.

    import random
    gizli = random.randint(1, 100)
    print(gizli)

    randint(1, 100) 1 ile 100 arasında, iki uç da dahil, rastgele bir tam sayı veriyor. Hücreyi birkaç kez çalıştır; her seferinde farklı bir sayı göreceksin.

    Adım 2: Tek bir tahmin

    gizli = random.randint(1, 100)
    tahmin = int(input("1 ile 100 arasında bir sayı tuttum. Tahminin: "))
    if tahmin == gizli:
    print("Bildin!")
    elif tahmin < gizli:
    print("Daha büyük bir sayı söyle.")
    else:
    print("Daha küçük bir sayı söyle.")

    input her zaman metin döndürür; sayıyla karşılaştırmak için int ile tam sayıya çeviriyoruz (Ders 4). Ardından Ders 5’teki if, elif, else üç durumu ayırıyor. Bu sürüm çalışıyor, ama tek tahminle oyun bitiyor.

    Adım 3: Bilene kadar sormak

    Kaç tahmin gerekeceğini bilmiyoruz, o yüzden Ders 6’daki while True döngüsü tam yerinde. Bir de sayaç ekleyelim:

    gizli = random.randint(1, 100)
    deneme = 0
    while True:
    tahmin = int(input("Tahminin: "))
    deneme += 1
    if tahmin == gizli:
    print(f"Bildin! {deneme} denemede buldun.")
    break
    elif tahmin < gizli:
    print("Daha büyük.")
    else:
    print("Daha küçük.")

    Artık oynanabilir bir oyunumuz var. Şimdi bir arkadaşına oynat ve tahmin yerine yanlışlıkla abc yazsın. Program şu hatayla çöker:

    ValueError: invalid literal for int() with base 10: 'abc'

    int harfleri sayıya çeviremiyor. Kendi yazdığın programda bunu yapmazsın belki, ama kullanıcılar her şeyi yazar. Sıradaki adım bunun için.

    Adım 4: Hatalı girişe karşı korumak

    Kullanıcıdan geçerli bir sayı alana kadar soran bir fonksiyon yazalım. Ders 9’da öğrendiğimiz gibi, bu işi bir kez yazıp oyunun her yerinde kullanacağız:

    def sayi_iste(mesaj, en_az, en_cok):
    """Kullanıcıdan en_az ile en_cok arasında bir tam sayı alana kadar sorar."""
    while True:
    cevap = input(mesaj).strip()
    if not cevap.isdigit():
    print("Lütfen sadece rakam yaz.")
    continue
    sayi = int(cevap)
    if en_az <= sayi <= en_cok:
    return sayi
    print(f"Sayı {en_az} ile {en_cok} arasında olmalı.")
    Bir sayı yaz: abc
    Lütfen sadece rakam yaz.
    Bir sayı yaz: 150
    Sayı 1 ile 100 arasında olmalı.
    Bir sayı yaz: 42
    Aldığım sayı: 42

    Üç yeni detay var:

    • .strip() metnin başındaki ve sonundaki boşlukları siliyor. ” 42 ” yazan kullanıcı da kabul ediliyor.
    • .isdigit() metin sadece rakamlardan oluşuyorsa True döndürüyor. int‘e çevirmeden önce kontrol ediyoruz.
    • continue döngünün geri kalanını atlayıp başa dönüyor; return ise hem döngüyü hem fonksiyonu bitiriyor.

    Hataları yakalamanın daha genel bir yolu da var: try ve except. Onu Ders 13’te işleyeceğiz.

    Adım 5: Zorluk seviyesi ve deneme hakkı

    Oyuna seviye ve sınırlı deneme hakkı ekleyelim. Ayarları Ders 8’deki gibi bir sözlükte tutmak, hepsini tek bir yerden değiştirmemizi sağlıyor:

    ZORLUKLAR = {
    "kolay": {"ust_sinir": 50, "hak": 10},
    "orta": {"ust_sinir": 100, "hak": 7},
    "zor": {"ust_sinir": 1000, "hak": 10},
    }
    def oyna(zorluk="orta"):
    """Bir el oyun oynatır. Kazanırsa deneme sayısını, kaybederse None döndürür."""
    ayar = ZORLUKLAR[zorluk]
    ust = ayar["ust_sinir"]
    gizli = random.randint(1, ust)
    print(f"1 ile {ust} arasında bir sayı tuttum. {ayar['hak']} hakkın var.")
    for deneme in range(1, ayar["hak"] + 1):
    tahmin = sayi_iste(f"{deneme}. tahmin: ", 1, ust)
    if tahmin == gizli:
    print(f"Bildin! {deneme} denemede buldun.")
    return deneme
    elif tahmin < gizli:
    print("Daha büyük.")
    else:
    print("Daha küçük.")
    print(f"Hakların bitti. Sayı {gizli} idi.")
    return None

    Bu kez while yerine for kullandık, çünkü kaç tur süreceği artık belli: en fazla hak kadar. Sayı bulununca return döngüyü erkenden bitiriyor. Döngü sonuna kadar dönerse haklar bitmiş demektir.

    Büyük harfle yazılan ZORLUKLAR adı bir Python geleneği: “Bu değer program boyunca değişmeyecek bir ayar” anlamına geliyor.

    Adım 6: Ana program

    Son olarak seviye seçimi, tekrar oynama ve skor tablosu:

    def ana_program():
    skorlar = []
    while True:
    zorluk = input("Zorluk seç (kolay / orta / zor): ").strip().lower()
    if zorluk not in ZORLUKLAR:
    print("Bu seviyeyi tanımıyorum, orta ile başlıyoruz.")
    zorluk = "orta"
    sonuc = oyna(zorluk)
    if sonuc is not None:
    skorlar.append(sonuc)
    if input("Tekrar oynamak ister misin? (e/h): ").strip().lower() != "e":
    break
    print(f"{len(skorlar)} oyun kazandın.")
    if skorlar:
    print(f"En iyi skorun: {min(skorlar)} deneme")
    ana_program()

    ana_program neredeyse düz Türkçe gibi okunuyor: seviye sor, oyna, kazandıysan skoru kaydet, devam etmek isteyip istemediğini sor. Ayrıntılar sayi_iste ve oyna fonksiyonlarının içinde saklanıyor. Program büyüdükçe fonksiyonlara bölmenin neden bu kadar önemli olduğu burada daha net görünüyor.

    sonuc is not None satırına dikkat: oyna kaybedince None döndürüyor, sadece kazanılan oyunları skor listesine ekliyoruz.

    Bonus: Oyunu bilgisayara oynatmak

    Bu oyunun en akıllı stratejisi ne? Her seferinde kalan aralığın tam ortasını söylemek. İlk tahmin 50; “daha büyük” cevabı gelirse 51 ile 100 arasının ortası, 75. Her tahminde ihtimallerin yarısı eleniyor. Bu yönteme ikili arama (binary search) deniyor ve bilgisayar biliminin en temel algoritmalarından biri.

    def bilgisayar_oyna(gizli, ust=100):
    alt, ust_sinir = 1, ust
    deneme = 0
    while True:
    tahmin = (alt + ust_sinir) // 2
    deneme += 1
    if tahmin == gizli:
    return deneme
    elif tahmin < gizli:
    alt = tahmin + 1
    else:
    ust_sinir = tahmin - 1
    print(bilgisayar_oyna(37)) # 3
    print(bilgisayar_oyna(100)) # 7
    denemeler = [bilgisayar_oyna(s) for s in range(1, 101)]
    print("En kötü durum:", max(denemeler), "deneme") # 7
    print("Ortalama:", sum(denemeler) / len(denemeler), "deneme") # 5.8

    // bölmenin tam sayı kısmını veriyor; 75,5 yerine 75. 37’yi bulmak için bilgisayar 50, 25 ve 37 diyor, üç denemede buluyor. 1 ile 100 arasındaki hangi sayıyı tutarsan tut, en fazla 7 denemede buluyor.

    Orta seviyedeki 7 hakkı bu yüzden seçtim: Akıllı oynayan biri her zaman kazanabilir, rastgele tahmin eden ise genelde kaybeder. Zor seviyedeki 10 hak da aynı mantıkla: 1 ile 1000 arasında ikili arama en fazla 10 denemede bitiyor.

    Alıştırmalar

    1. Oyuncunun tahmini gizli sayıya 5 ya da daha yakınsa “Çok yaklaştın!” mesajı ekle.
    2. ZORLUKLAR sözlüğüne kendi seviyeni ekle (örneğin “imkansız”: 1 ile 10000 arası, 14 hak).
    3. Oyun bitince oyuncunun bütün tahminlerini bir listede tut ve sırayla yazdır.
    4. bilgisayar_oyna fonksiyonunu 1 ile 1000 arası için çalıştır. En kötü durumda kaç deneme gerekiyor?

    Cevaplar Colab not defterinin sonunda.

    Bu projede neleri birleştirdik?

    • random ile ilk modülümüzü kullandık.
    • input, int, strip ve isdigit ile kullanıcıdan güvenli giriş aldık.
    • while ve for döngülerini, break, continue ve return ile yönettik.
    • Ayarları bir sözlükte, skorları bir listede tuttuk.
    • Programı üç fonksiyona böldük.
    • İkili aramayla ilk algoritmamızı tanıdık.

    Sıradaki ders

    Python Dersi 11’de metinlerle çalışmayı öğreniyoruz: büyük-küçük harf, bölme, birleştirme ve arama.

    Devamını oku

  • Harry Potter’ın Seçmen Şapkası: Basit Bir Sınıflandırma Modeli

    Harry Potter’ın Seçmen Şapkası: Basit Bir Sınıflandırma Modeli

    Hogwarts’a gelen her öğrenci başına eski bir şapka takıyor ve şapka birkaç saniye içinde karar veriyor: Gryffindor, Ravenclaw, Hufflepuff ya da Slytherin. Bir veri bilimci gözüyle bakınca Seçmen Şapkası aslında bir sınıflandırma modeli: girdi olarak bir öğrenciyi alıyor, çıktı olarak dört etiketten birini veriyor.

    Bu yazıda kendi şapkamızı iki kez kuracağız. Önce elle yazılmış kurallarla, sonra örneklerden öğrenen bir karar ağacıyla. Yolda makine öğreniminin üç temel fikrine değeceğiz: eğitim ve test verisi, modelin nerede yanıldığını görmek ve aşırı öğrenme.

    Hogwarts Legacy oyununda şapka beni Ravenclaw’a göndermişti. Bu yazı için de aklımdaki soru şuydu: Bu kararı bir model verseydi, neye bakarak verirdi?

    Kodların hepsi Colab’da hazır, kurulum gerekmiyor: Colab’da Aç

    Veri hakkında: Yazıdaki öğrencilerin hepsi hayali. Veriyi kod kendisi üretiyor; kitaplardan ya da filmlerden hiçbir karakter, metin veya görsel kullanmıyoruz.

    Şapkaya ne soruyoruz?

    Her öğrenciyi dört özellikle tarif edelim ve her birine 0 ile 10 arasında puan verelim: cesaret, zeka, sadakat ve hırs. Her binanın öne çıkardığı bir özellik var: Gryffindor cesareti, Ravenclaw zekayı, Hufflepuff sadakati, Slytherin hırsı.

    Makine öğrenimi dilinde bu dört puan öznitelik (feature), bina adı ise etiket (label). Modelin işi özniteliklere bakıp etiketi tahmin etmek.

    1. Kural tabanlı şapka

    En akla yatkın kural: öğrencinin en yüksek özelliğine bak, o özelliğin binasına gönder.

    OZELLIKLER = ["cesaret", "zeka", "sadakat", "hirs"]
    BINALAR = {"Gryffindor": "cesaret", "Ravenclaw": "zeka",
    "Hufflepuff": "sadakat", "Slytherin": "hirs"}
    def kural_sapka(ogrenci):
    """En yüksek puanlı özelliğe bakıp binayı seçer."""
    en_guclu = max(OZELLIKLER, key=lambda o: ogrenci[o])
    for bina, ozellik in BINALAR.items():
    if ozellik == en_guclu:
    return bina
    print(kural_sapka({"cesaret": 9, "zeka": 6, "sadakat": 7, "hirs": 4}))
    # Gryffindor
    print(kural_sapka({"cesaret": 5.2, "zeka": 5.4, "sadakat": 5.1, "hirs": 5.3}))
    # Ravenclaw

    İlk öğrencide sorun yok. İkincisine bak: dört özelliği de neredeyse eşit, zekası sadece 0,1 puan önde diye Ravenclaw’a gidiyor. Kuralın bu öğrenci hakkında “emin değilim” deme imkanı yok. İnsan eliyle yazılan kuralların genel derdi bu: düşündüğün durumlarda çalışıyor, düşünmediğin durumlarda sessizce yanılıyor.

    max satırındaki key=lambda o: ogrenci[o] ifadesi, “özellik adlarını karşılaştırırken her birinin puanına bak” demek. Fonksiyonları bugünkü Python Dersi 9’da anlattım; lambda ise tek satırlık, isimsiz bir fonksiyon.

    2. Hayali öğrenciler üretmek

    Model örneklerden öğreneceği için bize etiketli veri lazım. Her binadan 60, toplam 240 hayali öğrenci üretelim. Gryffindor, Ravenclaw ve Slytherin öğrencilerinde binanın özelliği belirgin şekilde yüksek olsun.

    Hufflepuff’a bir büküm ekleyelim. Hufflepuff, kapısını herkese açan bina olarak bilinir. Bu yüzden öğrencilerin yarısında sadakat yüksek, diğer yarısında ise hiçbir özellik öne çıkmıyor. Kural tabanlı şapka bu ikinci grubu bilmiyor; bakalım model fark edebilecek mi?

    import numpy as np
    import pandas as pd
    rng = np.random.default_rng(42)
    satirlar = []
    for bina, baskin in BINALAR.items():
    for i in range(60):
    if bina == "Hufflepuff" and i % 2 == 1:
    # Dengeli öğrenci: hiçbir özellik öne çıkmıyor
    ogr = {o: rng.normal(5, 0.7) for o in OZELLIKLER}
    ogr["sadakat"] = rng.normal(5.5, 0.7)
    else:
    ogr = {o: rng.normal(4.5, 1.2) for o in OZELLIKLER}
    ogr[baskin] = rng.normal(8, 1)
    ogr = {o: float(np.clip(round(v, 1), 0, 10)) for o, v in ogr.items()}
    ogr["bina"] = bina
    satirlar.append(ogr)
    df = pd.DataFrame(satirlar)
    print(df.groupby("bina")[OZELLIKLER].mean().round(1))
                cesaret  zeka  sadakat  hirs
    bina
    Gryffindor      7.8   4.4      4.5   4.6
    Hufflepuff      4.8   4.9      6.5   4.4
    Ravenclaw       4.3   8.1      4.6   4.3
    Slytherin       4.6   4.6      4.5   7.8

    rng.normal(8, 1), ortalaması 8 olan ve çoğunlukla 7 ile 9 arasına düşen rastgele bir sayı üretiyor. np.clip puanları 0 ile 10 arasında tutuyor. default_rng(42) içindeki 42 sayesinde kodu her çalıştırdığında aynı öğrenciler üretiliyor, böylece sen de yazıdaki sonuçların aynısını görüyorsun.

    3. Eğitim ve test verisi

    Bir modeli, öğrendiği örneklerle sınamak sınavdan önce cevap anahtarını vermeye benzer. Bu yüzden veriyi ikiye ayırıyoruz: model 180 öğrenciden öğrenecek, hiç görmediği 60 öğrenciyle sınanacak.

    from sklearn.model_selection import train_test_split
    from sklearn.metrics import accuracy_score
    X = df[OZELLIKLER]
    y = df["bina"]
    X_egitim, X_test, y_egitim, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
    )
    kural_tahmin = [kural_sapka(ogr) for ogr in X_test.to_dict("records")]
    print(f"Kural tabanlı şapkanın doğruluğu: {accuracy_score(y_test, kural_tahmin):.0%}")
    # Kural tabanlı şapkanın doğruluğu: 83%

    stratify=y, test grubunda her binadan eşit sayıda (15’er) öğrenci olmasını sağlıyor. Kural tabanlı şapka 60 test öğrencisinin 50’sini doğru yerleştirdi. Kötü değil; şimdi bunu geçmeye çalışalım.

    4. Karar ağacı: şapkaya örneklerden öğretmek

    Karar ağacı, veriye bakıp kendi evet-hayır sorularını oluşturan bir model. “Zeka 6,35’ten büyük mü?” diye sorar, cevaba göre bir dala geçer, sonra yeni bir soru sorar. Yani yaptığı şey bizim if-else kuralımıza çok benziyor; farkı, kuralları bizim yerimize veriden çıkarması.

    from sklearn.tree import DecisionTreeClassifier, export_text
    model = DecisionTreeClassifier(max_depth=3, random_state=42)
    model.fit(X_egitim, y_egitim)
    tahmin = model.predict(X_test)
    print(f"Karar ağacının doğruluğu: {accuracy_score(y_test, tahmin):.0%}")
    # Karar ağacının doğruluğu: 88%

    max_depth=3, ağacın en fazla üç soru üst üste sorabileceği anlamına geliyor. fit öğrenme adımı, predict tahmin adımı. Ağaç 60 öğrencinin 53’ünü doğru yerleştirdi.

    Karar ağacının güzel tarafı, öğrendiği kuralları okuyabilmemiz:

    print(export_text(model, feature_names=OZELLIKLER))
    |--- zeka <= 6.35
    | |--- hirs <= 6.45
    | | |--- cesaret <= 5.85
    | | | |--- class: Hufflepuff
    | | |--- cesaret > 5.85
    | | | |--- class: Gryffindor
    | |--- hirs > 6.45
    | | |--- cesaret <= 8.30
    | | | |--- class: Slytherin
    | | |--- cesaret > 8.30
    | | | |--- class: Gryffindor
    |--- zeka > 6.35
    | |--- hirs <= 7.30
    | | |--- cesaret <= 7.50
    | | | |--- class: Ravenclaw
    | | |--- cesaret > 7.50
    | | | |--- class: Gryffindor
    | |--- hirs > 7.30
    | | |--- class: Slytherin

    Bu çıktıdaki en ilginç detay şu: ağaç sadakati hiç sormuyor. Hufflepuff’ı “zekası, hırsı ve cesareti yüksek olmayan öğrenci” diye tarif ediyor. Biz veriyi üretirken Hufflepuff’ın yarısını dengeli öğrencilerden oluşturmuştuk; model de bunu bulmuş ve öteki üç binaya girmeyenleri Hufflepuff’a gönderen bir kural çıkarmış. Kural tabanlı şapkanın bilmediği şeyi örneklerden öğrendi.

    5. Şapka nerede yanılıyor?

    Doğruluk tek bir sayı; hangi binaların karıştığını söylemiyor. Bunun için karışıklık matrisine (confusion matrix) bakıyoruz. Satırlar gerçek binayı, sütunlar modelin tahminini gösteriyor:

    Gerçek \ TahminGryffindorRavenclawHufflepuffSlytherin
    Gryffindor14001
    Ravenclaw11400
    Hufflepuff13110
    Slytherin00114

    Köşegendeki sayılar doğru tahminler. Hataların çoğu Hufflepuff satırında: 15 Hufflepuff öğrencisinin 3’ü Ravenclaw’a gitmiş. Bunlar büyük ihtimalle zekası biraz yüksek çıkan dengeli öğrenciler. Gerçek bir projede bir sonraki adım bu örneklere tek tek bakmak olurdu.

    6. Ağacı büyütmek her zaman iyi mi?

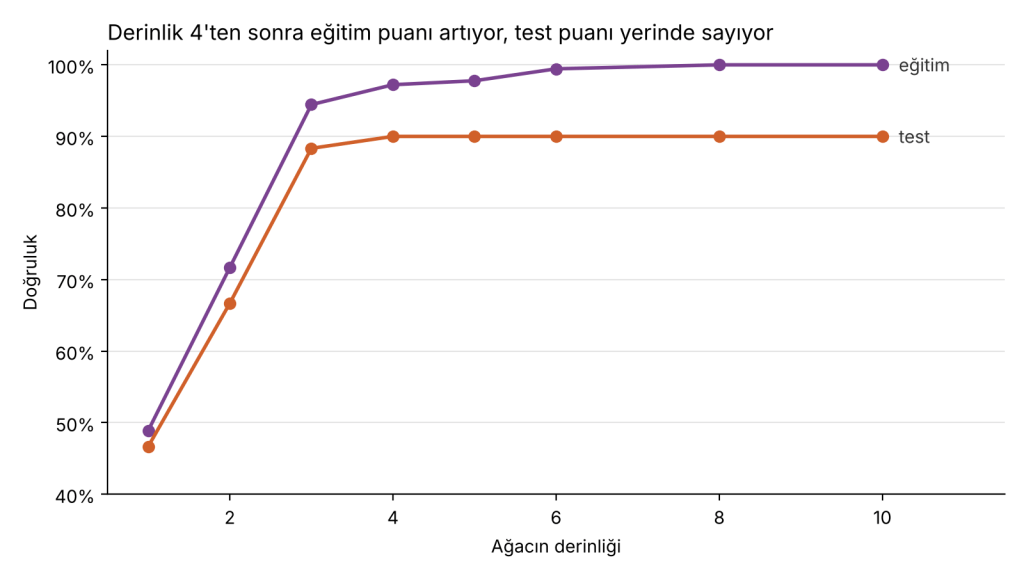
    Derinlik 3 yerine 10 olsa daha mı iyi olur? Farklı derinlikleri deneyip hem eğitim hem test doğruluğuna bakalım:

    for d in [1, 2, 3, 4, 5, 6, 8, 10]:
    m = DecisionTreeClassifier(max_depth=d, random_state=42).fit(X_egitim, y_egitim)
    egitim = accuracy_score(y_egitim, m.predict(X_egitim))
    test = accuracy_score(y_test, m.predict(X_test))
    print(f"derinlik {d:>2}: eğitim {egitim:.0%}, test {test:.0%}")
    derinlik 1: eğitim 49%, test 47%
    derinlik 2: eğitim 72%, test 67%
    derinlik 3: eğitim 94%, test 88%
    derinlik 4: eğitim 97%, test 90%
    derinlik 5: eğitim 98%, test 90%
    derinlik 6: eğitim 99%, test 90%
    derinlik 8: eğitim 100%, test 90%
    derinlik 10: eğitim 100%, test 90%

    Derinlik 8’de ağaç eğitim verisindeki her öğrenciyi doğru yerleştiriyor, ama yeni öğrencilerde derinlik 4’ten hiç daha iyi değil. Ekstra sorular genel bir kural öğrenmiyor, eğitimdeki tek tek öğrencileri ezberliyor. Buna aşırı öğrenme (overfitting) deniyor ve makine öğreniminde eğitim puanına tek başına güvenmememizin sebebi bu. Bizim örneğimizde zararı yok gibi görünüyor; daha gürültülü gerçek verilerde ise ezberleyen model test puanını da düşürebilir. Derinlik 3 de 4’e çok yakın sonuç veriyor ve kuralları bir bakışta okunabiliyor; yazıda bu yüzden onu seçtim.

    7. Berabere kalınca ne olur?

    Model, tahminin yanında her bina için bir olasılık da veriyor. Bunu bir fonksiyona saralım:

    def sapka(cesaret, zeka, sadakat, hirs):
    ogr = pd.DataFrame([{"cesaret": cesaret, "zeka": zeka, "sadakat": sadakat, "hirs": hirs}])
    olasiliklar = model.predict_proba(ogr)[0]
    for bina, p in sorted(zip(model.classes_, olasiliklar), key=lambda x: -x[1]):
    if p > 0:
    print(f"{bina:<11} {p:.0%}")
    print("Şapkanın kararı:", model.predict(ogr)[0])
    sapka(cesaret=9, zeka=5, sadakat=4, hirs=5)
    Gryffindor 89%
    Hufflepuff 9%
    Slytherin 2%
    Şapkanın kararı: Gryffindor

    Şimdi cesareti ve hırsı tam olarak eşit bir öğrenci deneyelim:

    berabere = {"cesaret": 8, "zeka": 5, "sadakat": 5, "hirs": 8}
    print("Kural tabanlı şapka:", kural_sapka(berabere))
    sapka(**berabere)
    Kural tabanlı şapka: Gryffindor
    Slytherin 98%
    Hufflepuff 2%
    Şapkanın kararı: Slytherin

    İki şapka iki farklı binayı seçti ve ikisinin de sebebi ilginç. Kural tabanlı şapka Gryffindor diyor, çünkü max eşitlikte listede önce gelen özelliği seçiyor. Yani kararı öğrenci değil, benim listeyi yazma sıram verdi. Karar ağacı ise %98 eminlikle Slytherin diyor, çünkü kurallarından biri “hırs yüksekse ve cesaret 8,30’u geçmiyorsa Slytherin”.

    Buradan çıkacak ders şu: Modelin %98 demesi gerçekten bu kadar emin olduğu anlamına gelmiyor. Karar ağacı olasılığı, öğrencinin düştüğü yapraktaki eğitim örneklerinin oranından hesaplıyor. O yaprakta neredeyse hep Slytherin öğrencileri olduğu için sayı yüksek çıkıyor. Tam sınırdaki bir öğrenci için bile. Olasılık çıktısını okurken bunu akılda tutmak gerekiyor.

    8. Kendi şapkanı tak

    Not defterinin sonunda dört soruluk küçük bir test var. Her özelliğe kendine 0 ile 10 arası puan veriyorsun, şapka da kararını ve olasılıkları yazıyor:

    puanlar = {}
    for o in OZELLIKLER:
    puanlar[o] = float(input(f"{o} (0-10): "))
    sapka(**puanlar)

    sapka(**puanlar) satırındaki iki yıldız, sözlükteki anahtarları isimli argümanlara çeviriyor. Yani sapka(cesaret=..., zeka=..., ...) yazmakla aynı şey.

    Bu projede ne öğrendik?

    • Sınıflandırma: özniteliklere bakıp bir etiket tahmin etmek.
    • Kural tabanlı sistemler düşündüğün durumlarda çalışır; örneklerden öğrenen model, senin görmediğin kalıpları bulabilir.
    • Modeli her zaman görmediği verilerle sına.
    • Karışıklık matrisi, hatanın nerede olduğunu gösterir.
    • Eğitim puanı yüzde 100 olan model iyi bir model olmayabilir; aşırı öğrenmeye dikkat.
    • Olasılık çıktısı her zaman gerçek bir eminlik ölçüsü değil.

    Kendin dene

    1. max_depth değerini 2 ve 5 yapıp kuralların nasıl değiştiğine bak.
    2. default_rng(42) içindeki 42’yi değiştir. Sonuçlar ne kadar oynuyor?
    3. Veriye beşinci bir özellik ekle (örneğin merak) ve hangi binada yüksek olacağına sen karar ver.
    4. Karar ağacı yerine KNeighborsClassifier(n_neighbors=5) dene ve olasılıkların nasıl değiştiğini karşılaştır.

    Devamını oku

  • Kod Kartı: Sözlükte Olmayan Anahtar: get() Kullan

    Kod Kartı: Sözlükte Olmayan Anahtar: get() Kullan

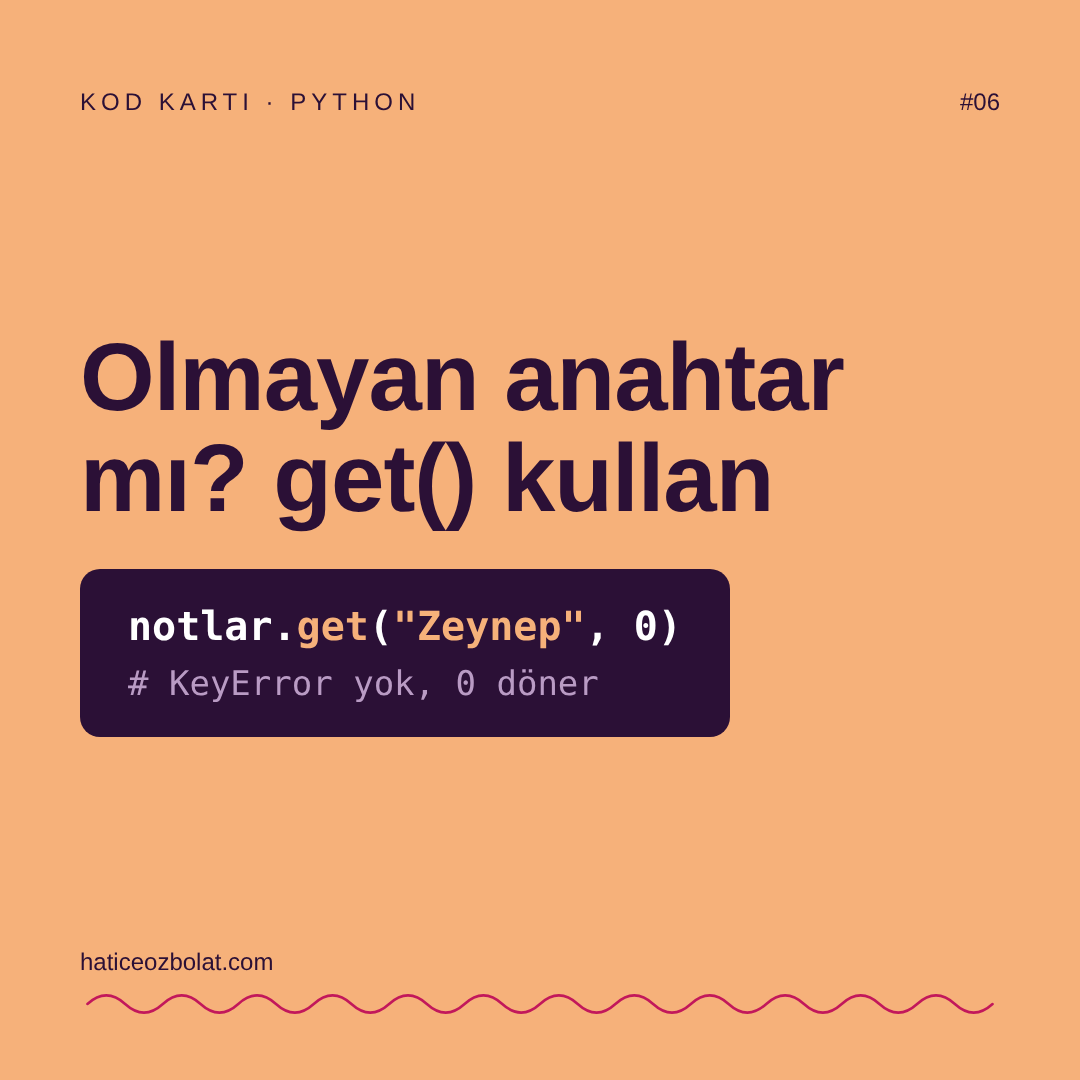
    Sözlükte olmayan bir anahtarı köşeli parantezle istersen Python programı durdurur: KeyError. Kullanıcıdan gelen bir isim, bir dosyadan okunan bir sütun ya da bir API’den dönen bir alan; hepsi “bu anahtar orada olmayabilir” durumları. get() bu durumda programı durdurmak yerine sana bir varsayılan değer verir.

    Kod

    notlar = {"Ayşe": 85, "Mert": 45}
    print(notlar["Zeynep"]) # KeyError: 'Zeynep'
    print(notlar.get("Zeynep")) # None
    print(notlar.get("Zeynep", 0)) # 0
    print(notlar) # {'Ayşe': 85, 'Mert': 45}

    get iki şey alıyor: aranan anahtar ve anahtar yoksa dönecek değer. İkincisini yazmazsan None döner. Son satıra dikkat: get sözlüğe hiçbir şey eklemiyor, sadece okuyor.

    En sık kullanımı: sayaç

    Python Dersi 8’deki kelime sayacını hatırla:

    oylar = ["elma", "muz", "elma"]
    sayac = {}
    for oy in oylar:
    sayac[oy] = sayac.get(oy, 0) + 1
    print(sayac) # {'elma': 2, 'muz': 1}

    Bir meyve ilk kez görüldüğünde sözlükte yok, get 0 veriyor, üstüne 1 ekleniyor. Sonraki seferlerde mevcut sayı geliyor. get olmasaydı her seferinde if oy in sayac: diye kontrol etmek gerekirdi.

    Dikkat: anahtar var ama değeri None

    Varsayılan değer sadece anahtar hiç yoksa devreye girer. Anahtar varsa, değeri None bile olsa o döner:

    ayarlar = {"tema": None}
    print(ayarlar.get("tema", "açık")) # None, "açık" değil!
    print(ayarlar.get("dil", "tr")) # tr

    Veriyi bir yerden okurken boş alanlar sık sık None olarak gelir. “Yoksa ya da boşsa varsayılanı kullan” demek istiyorsan bunu ayrıca kontrol etmen gerekiyor.

    Ne zaman get(), ne zaman köşeli parantez?

    • Anahtarın mutlaka olması gerekiyorsa sözlük[anahtar] kullan. Yoksa ortada bir hata vardır ve KeyError bunu sana hemen söyler.
    • Anahtarın olmaması normalse get kullan ve mantıklı bir varsayılan ver.

    get her hatayı susturmak için değil. Yanlış yazılmış bir anahtarı ("Ayse" yerine "Ayşe") sessizce 0’a çevirirse hatayı bulmak çok daha zorlaşır.

    Sözlükleri Python Dersi 8’de, fonksiyonları ve varsayılan değerleri Python Dersi 9’da anlattım.

  • Fonksiyonlar (Python Dersi 9)

    Fonksiyonlar (Python Dersi 9)

    Şimdiye kadar yazdığımız kodlar yukarıdan aşağıya akan tek parça metinlerdi. Aynı işi üç farklı yerde yapman gerekince aynı satırları üç kez kopyaladın. Bu derste o kopyalamayı bitiriyoruz: bir işi bir kez tanımlayıp istediğin kadar kullanmanı sağlayan fonksiyonları öğreneceğiz.

    Bence fonksiyonları anlamanın en kolay yolu, okulda matematikte gördüğümüz fonksiyonlarla bağlantı kurmak. Bir fabrika gibi düşün: makineye meyve verirsin, makine sana meyve suyu verir. Python’daki fonksiyonlar da tam olarak böyle çalışıyor.

    Bu dersin tüm kodları Colab’da hazır: Colab’da Aç

    Aynı kodu üç kez yazmak

    Üç öğrencinin not ortalamasını hesaplayalım:

    ayse = [80, 70, 90]
    mert = [45, 60, 51]
    zeynep = [90, 88, 95]
    print("Ayşe:", sum(ayse) / len(ayse))
    print("Mert:", sum(mert) / len(mert))
    print("Zeynep:", sum(zeynep) / len(zeynep))
    # Ayşe: 80.0
    # Mert: 52.0
    # Zeynep: 91.0

    Çalışıyor. Ama ortalama hesabını değiştirmek istersen (mesela en düşük notu atmak) üç satırı da tek tek düzeltmen gerekecek. Otuz öğrencin olsa otuz satır. Fonksiyon tam bu sorunu çözüyor.

    İlk fonksiyonun: def

    Fonksiyon, bir isim verdiğin kod bloğu. def ile tanımlanıyor:

    def selamla():
    print("Merhaba!")
    print("Python Dersi 9'a hoş geldin.")
    selamla()
    selamla()

    Parçalarına bakalım:

    • def: “bir fonksiyon tanımlıyorum” demek.
    • selamla: fonksiyonun adı. Değişken adlarındaki kurallar burada da geçerli.
    • (): parantezler. Birazdan içine bir şeyler koyacağız.
    • : ve girinti: if ve for‘da olduğu gibi, girintili satırlar fonksiyonun gövdesi.

    Tanımlamak, çalıştırmak demek değil. def satırı Python’a sadece tarifi öğretir; tarif ancak selamla() diye çağırdığında çalışır. Bu örnekte iki kez çağırdığımız için mesaj iki kez yazılıyor.

    Parametre: fonksiyona bilgi vermek

    Her seferinde aynı mesajı yazan bir fonksiyon pek işe yaramaz. Parantezlerin içine bir parametre koyarsan fonksiyon her çağrıda farklı bir değerle çalışır:

    def selamla(isim):
    print(f"Merhaba {isim}!")
    selamla("Ayşe") # Merhaba Ayşe!
    selamla("Mert") # Merhaba Mert!

    isim, fonksiyonun içinde kullanılan bir değişken. Çağırırken parantezin içine yazdığın değer ("Ayşe") o değişkene yerleşiyor. Çağırırken verdiğin bu değere argüman deniyor.

    return: fonksiyondan sonuç almak

    Asıl güç burada. return, fonksiyonun hesapladığı değeri çağırdığın yere geri gönderir:

    def ortalama(notlar):
    return sum(notlar) / len(notlar)
    print(ortalama(ayse)) # 80.0
    mert_ort = ortalama(mert)
    print(mert_ort + 5) # 57.0

    Artık ortalama hesabı tek bir yerde. Hesabı değiştirmek istersen sadece fonksiyonun içini düzeltiyorsun, her çağrı otomatik olarak yeni hesabı kullanıyor.

    print ile return aynı şey değil

    Yeni başlayanların en sık karıştırdığı konu bu. Şu fonksiyona bak:

    def yazdir_ortalama(notlar):
    print(sum(notlar) / len(notlar))
    sonuc = yazdir_ortalama(mert) # ekrana 52.0 yazar
    print(sonuc) # None

    print sonucu sadece ekrana yazar; değer kaybolur. return ise değeri sana verir, sen de onu bir değişkene koyabilir, başka bir hesapta kullanabilirsin. return yazmayan bir fonksiyon None döndürür, yani “hiçbir şey”. Kural basit: sonucu kullanacaksan return, sadece göstereceksen print.

    Varsayılan değer ve isimli argüman

    Bir parametreye varsayılan değer verebilirsin. Çağırırken o argümanı yazmazsan varsayılan kullanılır:

    def gecti_mi(puan, sinir=50):
    return puan >= sinir
    print(gecti_mi(55)) # True (sınır 50)
    print(gecti_mi(55, 60)) # False (sınır 60)
    print(gecti_mi(sinir=40, puan=45)) # True

    Son satırdaki gibi argümanları adlarıyla da verebilirsin. O zaman sıranın bir önemi kalmaz ve kodu okuyan kişi hangi sayının ne olduğunu hemen anlar.

    Birden fazla sonuç döndürmek

    Bir fonksiyon aynı anda birkaç değer döndürebilir. Python bunları bir demet (tuple) içinde gönderir; Ders 8’de öğrendiğimiz paket açmayla da tek tek değişkenlere dağıtabilirsin:

    def istatistik(notlar):
    return min(notlar), max(notlar), sum(notlar) / len(notlar)
    en_dusuk, en_yuksek, ort = istatistik(zeynep)
    print(en_dusuk, en_yuksek, ort) # 88 95 91.0
    print(istatistik(mert)) # (45, 60, 52.0)

    Kapsam: fonksiyonun içi ve dışı

    Fonksiyonun içinde oluşturduğun değişkenler sadece içeride yaşar. Fonksiyon bitince silinir:

    def hesapla():
    ara_toplam = 10 + 20
    return ara_toplam
    print(hesapla()) # 30
    print(ara_toplam) # NameError: name 'ara_toplam' is not defined

    Bu bir hata değil, bir güvenlik önlemi. Her fonksiyonun kendi küçük çalışma alanı var; içeride kullandığın i, toplam gibi isimler dışarıdaki aynı isimli değişkenleri bozmuyor. Bir değeri dışarı çıkarmak istiyorsan yolu return.

    Docstring: fonksiyona açıklama yazmak

    Fonksiyonun ilk satırına üç tırnak arasında bir açıklama yazabilirsin. Buna docstring deniyor ve help() ile okunabiliyor:

    def harf_notu(puan):
    """Puanı harf notuna çevirir: 85+ AA, 70+ BA, 50+ CC, altı FF."""
    if puan >= 85:
    return "AA"
    elif puan >= 70:
    return "BA"
    elif puan >= 50:
    return "CC"
    return "FF"
    print(harf_notu(92), harf_notu(73), harf_notu(50), harf_notu(30))
    # AA BA CC FF
    help(harf_notu)

    Bir detaya dikkat: return çalıştığı anda fonksiyon biter. Bu yüzden son satırdaki return "FF" için else yazmaya gerek yok; oraya ancak yukarıdaki koşulların hiçbiri tutmazsa gelinir.

    Mini program: sınıf defteri, fonksiyonlarla

    Ders 8’deki sınıf defterini hatırla. Şimdi aynı işi yazdığımız fonksiyonları birleştirerek yapıyoruz:

    def rapor(sinif):
    """Her öğrencinin ortalamasını, harf notunu ve durumunu yazdırır."""
    for isim, notlar in sinif.items():
    ort = ortalama(notlar)
    durum = "Geçti" if gecti_mi(ort) else "Kaldı"
    print(f"{isim:<8} {ort:5.1f} {harf_notu(ort)} {durum}")
    sinif = {"Ayşe": ayse, "Mert": mert, "Zeynep": zeynep, "Can": [30, 55, 41]}
    rapor(sinif)

    Çıktı:

    Ayşe 80.0 BA Geçti
    Mert 52.0 CC Geçti
    Zeynep 91.0 AA Geçti
    Can 42.0 FF Kaldı

    rapor fonksiyonunu oku: neredeyse bir Türkçe cümle gibi. “Her öğrenci için ortalamayı al, geçti mi bak, harf notunu yaz.” Fonksiyonların asıl faydası bu: büyük bir problemi isimleri olan küçük parçalara bölüyorsun, sonra o parçaları birleştiriyorsun.

    f"{isim:<8}" ve {ort:5.1f} ifadeleri çıktıyı hizalamak için. İsmi 8 karakterlik alana sola yaslıyor, ortalamayı 5 karakterlik alanda tek ondalıkla yazıyor.

    Alıştırmalar

    1. Bir sayının karesini döndüren kare(x) fonksiyonu yaz ve kare(7) sonucunu yazdır.
    2. Celsius’u Fahrenheit’a çeviren fahrenheit(c) fonksiyonu yaz (formül: c * 9 / 5 + 32). 0, 25 ve 100 için dene.
    3. Bir listedeki çift sayıların sayısını döndüren cift_say(liste) fonksiyonu yaz.
    4. indirim(fiyat, oran=10) fonksiyonu yaz: indirimli fiyatı döndürsün. indirim(200) ve indirim(200, 25) sonuçlarını yazdır.

    Cevaplar Colab not defterinin sonunda.

    Bu derste ne öğrendik?

    • def fonksiyonu tanımlar; fonksiyon ancak adıyla çağrılınca çalışır.
    • Parametreler fonksiyona bilgi taşır; varsayılan değer verilebilir, argümanlar adlarıyla yazılabilir.
    • return sonucu geri verir; print sadece ekrana yazar.
    • Fonksiyonun içindeki değişkenler dışarıdan görünmez.
    • Büyük bir programı küçük, isimli fonksiyonlara bölmek kodu okunur yapar.

    Sıradaki ders

    Python Dersi 10’da şimdiye kadar öğrendiğimiz her şeyi ilk mini projede birleştiriyoruz: Sayı Tahmin Oyunu.

  • Black Mirror’daki Teknolojiler: Hangileri Gerçek Oldu?

    Black Mirror’daki Teknolojiler: Hangileri Gerçek Oldu?

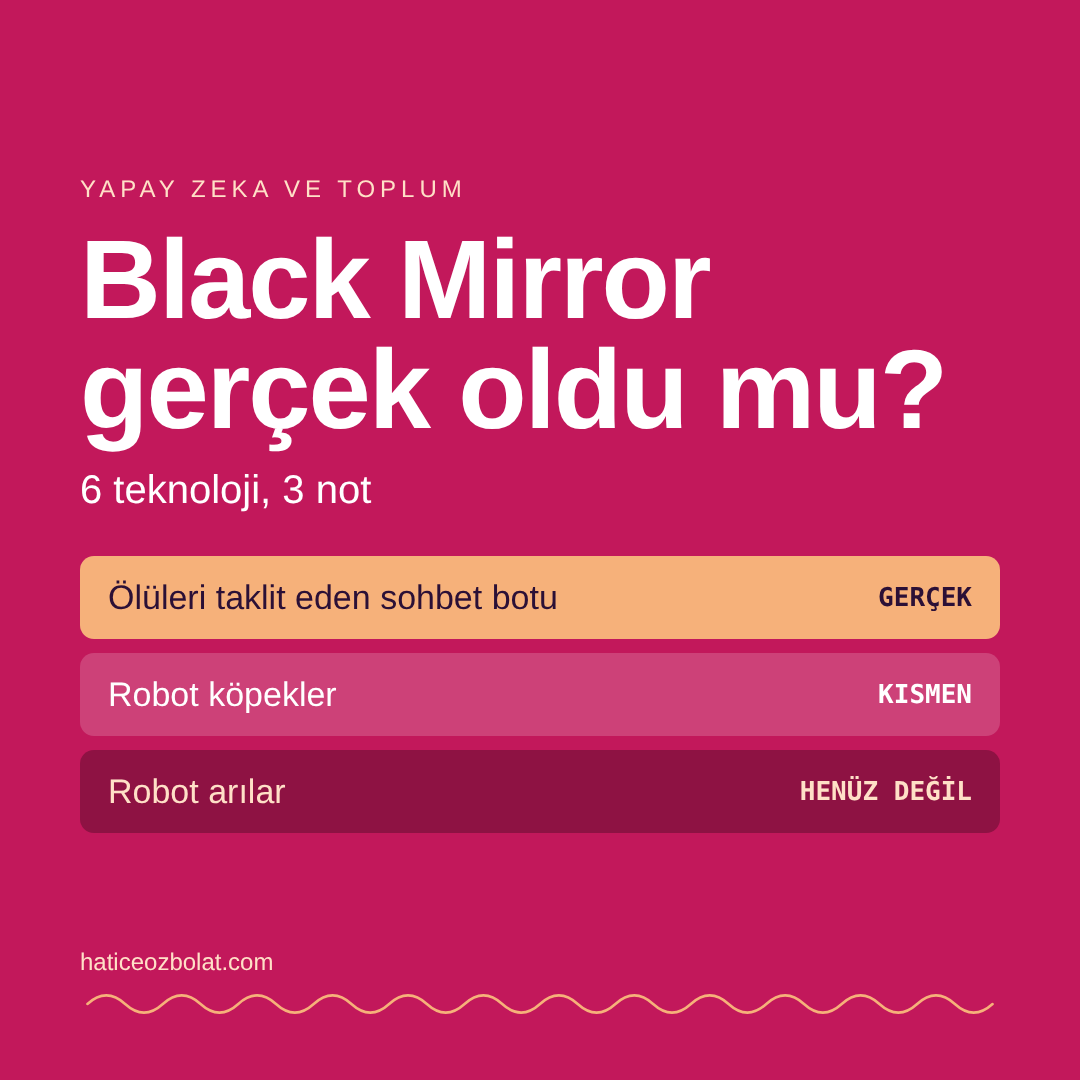
    Black Mirror’ın her bölümü aynı soruyla biter: “Bu teknoloji gerçek olsa ne olurdu?” Dizinin ilk bölümlerinin üzerinden on yıldan fazla geçti ve bu sorunun cevabı bazı bölümler için artık bir tahmin değil, haber başlığı. Bu yazıda dizinin altı teknolojisini gerçek dünyadaki karşılıklarıyla yan yana koydum ve her birine bir not verdim: gerçek oldu, kısmen gerçek ya da henüz değil.

    Spoiler uyarısı: Bölümlerin ana fikirlerinden bahsediyorum ama sonlarını anlatmıyorum.

    1. Ölen birini yapay zekâyla geri getirmek (“Be Right Back”)

    Dizide: Sevgilisini kaybeden bir kadın, onun sosyal medya paylaşımlarından ve mesajlarından öğrenen bir yazılımla konuşmaya başlıyor.

    Gerçekte: Yazılımcı Eugenia Kuyda, yakın arkadaşı Roman bir trafik kazasında hayatını kaybettikten sonra, onunla yaptığı mesajlaşmaları bir yapay zekâ programına verdi ve onun konuşma tarzını taklit eden bir sohbet botu yaptı. Bu deneyim, bugün milyonlarca kullanıcısı olan sohbet arkadaşı uygulaması Replika’nın başlangıç noktası oldu. Büyük dil modelleriyle birlikte “kaybettiğin kişiyle konuş” iddiasındaki uygulamalar da çoğaldı.

    Not: Gerçek oldu. Teknik olarak dizideki sohbet aşaması bugün mümkün. Ama bölümün asıl sorduğu soru, yani bunun yas sürecine iyi mi geleceği yoksa onu uzatacağı mı, hâlâ cevapsız.

    2. Robot köpekler (“Metalhead”)

    Dizide: İnsanları durmaksızın takip eden dört bacaklı robotlar.

    Gerçekte: Dizinin yaratıcısı Charlie Brooker, bölümün Boston Dynamics’in robot köpeklerinden etkilendiğini söyledi. Aynı şirketin Spot adlı robotu bugün fabrikalarda, enerji tesislerinde ve tehlikeli alanlarda denetim için kullanılıyor. New York polisi 2020’de “Digidog” adını verdiği bir Spot kiraladı; ama robotun bir rehine olayında ve bir gözaltıda kullanılması büyük tepki çekti ve sözleşme Nisan 2021’de erken bitirildi.

    Not: Kısmen gerçek. Robot köpekler var ve gerçek işlerde kullanılıyor. Dizideki gibi kendi başına avlanan, silahlı bir robot ise yok. New York örneği, toplumun bu çizgiyi ne kadar hassas bulduğunu gösteriyor.

    3. Robot arılar (“Hated in the Nation”)

    Dizide: Arı nüfusu çöktüğü için tozlaşmayı yapan küçük dronlar.

    Gerçekte: Harvard’daki araştırmacılar yıllardır RoboBee adını verdikleri böcek boyutunda uçan robotlar üzerinde çalışıyor. 2018’de perakende devi Walmart’ın “insansız araçlarla tarım ürünlerini tozlaştırma” için patent başvurusu yaptığı ortaya çıktı.

    Not: Henüz değil. Patent başvurusu ve laboratuvar prototipleri var ama tarlada çalışan robot arı sürüleri yok. Gerçek arıların yaptığı işi bu ölçekte taklit etmek hâlâ çok zor.

    4. Her şeyi kaydeden gözler (“The Entire History of You”)

    Dizide: Kulağın arkasına takılan bir çip, yaşadığın her anı kaydediyor; istediğin anı geri sarıp tekrar izleyebiliyorsun.

    Gerçekte: Beyne takılan bir hafıza çipi yok. Ama kamera ve mikrofonlu akıllı gözlükler artık bir tüketici ürünü: gözlüğünle gördüğünü kaydedip paylaşabiliyorsun. Telefonundaki fotoğraf arşivi de yıllarını tarih ve yere göre geri sarmanı sağlıyor.

    Not: Kısmen gerçek. Kayıt kısmı büyük ölçüde var; vücuda yerleştirilmiş ve her şeyi sürekli kaydeden kısım değil. Bölümün uyardığı şey, yani her tartışmada “kayda bakalım” demenin ilişkilere etkisi, artık çok daha tanıdık geliyor.

    5. Puanlanan hayatlar (“Nosedive”)

    Dizide: Herkes karşılaştığı herkese 1’den 5’e kadar puan veriyor. Puanın düşükse ev kiralayamıyor, uçağa binemiyorsun.

    Gerçekte: Bu bölüm sık sık Çin’in sosyal kredi sistemiyle karşılaştırılıyor. Ama bu karşılaştırmanın abartılı olduğunu söyleyen pek çok analiz var: Gerçekteki sistem, dizideki gibi herkesin herkese puan verdiği tek bir uygulama değil; farklı kurumların ve şirketlerin kendi kayıtlarından oluşan, parçalı ve tartışmalı bir yapı. Öte yandan günlük hayatımızda puanlar her yerde: sürücüler yolcuya, ev sahipleri misafire, satıcılar alıcıya puan veriyor.

    Not: Kısmen gerçek. Tek bir süper puan yok; ama birbirine puan verdiğimiz düzinelerce küçük sistem var. Bölümün asıl eleştirdiği şey, puan için rol yapmak, belki de en gerçek olan kısmı.

    6. Bilinci dijital dünyaya taşımak (“San Junipero”)

    Dizide: İnsanların bilinci, ölümden sonra da yaşayabilecekleri bir sanal dünyaya aktarılıyor.

    Gerçekte: Sanal gerçeklik gözlükleri ve sanal dünyalar var. Ama bir insanın bilincini kopyalayıp bilgisayara aktarmak, bugünün bilimiyle mümkün değil; bilincin ne olduğunu bile tam olarak bilmiyoruz.

    Not: Henüz değil. Ve belki de hiç olmayacak. Ama bölüm teknolojiden çok bir aşk hikâyesi olduğu için bu, onu daha az etkileyici yapmıyor.

    Özet

    BölümTeknolojiDurum
    Be Right BackÖlen birini taklit eden sohbet botuGerçek oldu
    MetalheadRobot köpeklerKısmen gerçek
    The Entire History of YouHer şeyi kaydeden cihazKısmen gerçek
    NosediveHerkesin herkese puan verdiği dünyaKısmen gerçek
    Hated in the NationTozlaşma yapan robot arılarHenüz değil
    San JuniperoBilinci dijital dünyaya aktarmakHenüz değil

    Asıl mesele teknoloji değil

    Bu listeyi yaparken fark ettiğim şey şu oldu: Black Mirror’ın korkutucu tarafı hiçbir zaman teknolojinin kendisi değildi. Bir sohbet botu, bir robot ya da bir puanlama sistemi tek başına iyi ya da kötü değil. Dizinin asıl sorduğu şey, insanların bu araçlarla ne yaptığı. Teknolojiyi üreten taraftaysan bu soru daha da önemli hale geliyor: Bir ürünü yaparken sadece “yapabilir miyiz?” diye değil, “yapmalı mıyız?” diye de sormak gerekiyor.

    Benim yorumum

    Black Mirror’ı izlerken her bölümde hem şaşırıyorum hem de içimden “Ben de bu teknolojilerin bir parçası olayım” diyorum. Dizi ne kadar karanlık olursa olsun, ekranda gördüğüm her yeni fikir beni heyecanlandırıyor. Bu listeyi hazırlarken de bir kez daha seçtiğim meslekle gurur duydum: Bu teknolojileri izleyen değil, onları üreten tarafta olmak; üstelik yukarıdaki “yapmalı mıyız?” sorusunu da sorabilen biri olarak.

  • Netflix İzleme Geçmişi Panosu 2: Streamlit ile Panoya Dönüştürmek

    Netflix İzleme Geçmişi Panosu 2: Streamlit ile Panoya Dönüştürmek

    İlk bölümde Netflix izleme geçmişimi indirip temizledim ve not defterinde ona sorular sordum: En çok hangi diziyi izlemişim, hangi günler daha çok izliyorum, maraton günüm hangisi? Ama not defteri, cevabı görmek için her seferinde kod çalıştırmayı gerektiriyor. Bu bölümde aynı kodu, tıklayıp filtreleyebileceğin bir web panosuna çeviriyoruz. Hem de HTML ya da JavaScript bilmeden, sadece Python ile.

    Uygulamanın tüm kodu GitHub’da: pop-kultur-kodluyorum / netflix-pano.

    Streamlit nedir?

    Streamlit, Python koduyla web uygulaması yapmayı sağlayan açık kaynak bir kütüphane. Veri bilimcilerin en sevdiği araçlardan biri, çünkü mantığı çok basit: Bir Python dosyası yazıyorsun, st.title("Merhaba") dersen sayfada başlık, st.bar_chart(veri) dersen grafik çıkıyor. Biri bir düğmeye bastığında ya da bir filtreyi değiştirdiğinde Streamlit dosyayı yukarıdan aşağı yeniden çalıştırır ve sayfayı günceller.

    Bu “her etkileşimde yeniden çalıştır” fikri başta garip gelebilir, ama işi çok kolaylaştırıyor: Kodu not defterinde yazar gibi yukarıdan aşağı yazıyorsun, gerisini Streamlit hallediyor.

    Kurulum

    Streamlit kendi bilgisayarında çalışır (Colab’da doğrudan çalışmaz). Terminalde:

    pip install streamlit pandas altair

    Kurulumu denemek için streamlit hello yazabilirsin; tarayıcında bir örnek uygulama açılır.

    Uygulamanın parçaları

    Uygulama tek bir dosya: app.py. Altı bölümden oluşuyor. Tamamı GitHub’da; burada her bölümün önemli satırlarını anlatıyorum.

    1. Temizleme fonksiyonları: ilk bölümden aynen

    Tarihleri çözen tarihi_coz ve diziyi filmden ayıran ayir fonksiyonlarını ilk bölümden hiç değiştirmeden taşıdım. Hepsini tek bir fonksiyonda topladım:

    @st.cache_data
    def veriyi_hazirla(ham):
    df = ham.rename(columns={"Title": "baslik", "Date": "tarih"})
    df["tarih"] = tarihi_coz(df["tarih"])
    df = df.dropna(subset=["tarih"])
    df[["isim", "tur"]] = df["baslik"].apply(lambda b: pd.Series(ayir(b)))
    # ... ikinci adım: tekrar eden ön ekleri dizi say
    return df

    @st.cache_data satırı bir dekoratör: fonksiyonun üstüne yapışan bir etiket gibi düşün. Streamlit’e “bu fonksiyonu aynı veriyle tekrar çağırırlarsa baştan hesaplama, önceki sonucu ver” diyor. Her filtre değişikliğinde dosya yeniden çalıştığı için bu önemli; yoksa binlerce satırı her tıklamada yeniden temizlerdik.

    2. Dosyayı almak

    dosya = st.file_uploader("NetflixViewingHistory.csv dosyanı yükle", type="csv")
    if dosya is None:
    st.info("Henüz dosya yüklemedin. Aşağıda hayali bir örnek veriyle gösteriyorum.")
    df = veriyi_hazirla(ornek_veri())
    else:
    df = veriyi_hazirla(pd.read_csv(dosya))

    st.file_uploader sayfaya bir dosya yükleme kutusu koyar. Kullanıcı henüz dosya seçmediyse None döner; o zaman pano boş kalmasın diye hayali bir örnek veri gösteriyoruz. Bu örnek veri tamamen uydurma dizi isimlerinden oluşuyor.

    3. Filtreler: kenar çubuğu

    with st.sidebar:
    yillar = sorted(df["tarih"].dt.year.unique())
    secilen_yillar = st.multiselect("Yıl", yillar, default=yillar)
    tur = st.radio("Tür", ["Hepsi", "Dizi", "Film"], horizontal=True)
    f = df[df["tarih"].dt.year.isin(secilen_yillar)]
    if tur != "Hepsi":
    f = f[f["tur"] == tur]

    with st.sidebar: bloğunun içine yazılan her şey sol taraftaki kenar çubuğuna gider. st.multiselect birden fazla yıl seçmeye, st.radio türlerden birini seçmeye yarıyor. Seçimler sıradan Python değişkenlerine düşüyor; sonra pandas ile tabloyu filtreliyoruz. Sayfanın geri kalanı hep bu filtrelenmiş f tablosunu kullanıyor, böylece bir filtre değişince tüm pano birlikte değişiyor.

    4. Özet kartları

    k1, k2, k3, k4 = st.columns(4)
    k1.metric("Toplam kayıt", len(f))
    k2.metric("Farklı dizi", f.loc[f["tur"] == "Dizi", "isim"].nunique())
    k3.metric("Film", int((f["tur"] == "Film").sum()))
    k4.metric("Maraton günü", f"{gunluk.max()} kayıt")

    st.columns(4) sayfayı dört eşit sütuna böler, metric da her sütuna büyük bir sayı koyar. Panonun en üstündeki özet buradan geliyor.

    5. Grafikler

    Streamlit’in kendi st.bar_chart fonksiyonu hızlı ama günlerin sırasını alfabetik yapıyor (Cuma, Cumartesi, Çarşamba…). Haftanın günlerini doğru sırada göstermek ve renkleri seçmek için Streamlit’le birlikte gelen Altair kütüphanesini kullandım. Aynı çubuk grafiği üç yerde kullanacağım için küçük bir fonksiyon yazdım:

    def cubuk(veri, x, y, renk=BOGURTLEN, sira=None, x_baslik="", y_baslik="Kayıt"):
    return (
    alt.Chart(veri)
    .mark_bar(color=renk, cornerRadiusEnd=4)
    .encode(
    x=alt.X(x, sort=sira, title=x_baslik),
    y=alt.Y(y, title=y_baslik),
    tooltip=[x, y],
    )
    )

    sort=sira parametresine ["Pazartesi", "Salı", ...] listesini verince günler doğru sıraya diziliyor. tooltip da fareyle çubuğun üzerine gelince sayıyı gösteriyor. Grafiği sayfaya koymak için st.altair_chart(grafik) yeterli. (GitHub’daki tam sürümde eksen biçimleri için birkaç ayar daha var.)

    En çok izlenen 10 dizi ise grafik değil tablo: st.dataframe(ilk10, hide_index=True). Uzun dizi isimleri tabloda daha rahat okunuyor.

    6. Bir diziye yakından bak

    diziler = f.loc[f["tur"] == "Dizi", "isim"].value_counts().index.tolist()
    secilen = st.selectbox("Dizi seç", diziler)
    d = f[f["isim"] == secilen]

    st.selectbox bir açılır menü koyar. Liste en çok izlenenden en aza doğru sıralı. Bir dizi seçince ilk ve son izleme tarihini ve o dizinin aylara göre grafiğini gösteriyoruz. Bir diziyi birkaç haftada bitirip bitirmediğini ya da yıllara yayıp yaymadığını bu grafikte görebiliyorsun.

    Çalıştırmak

    1. GitHub’dan netflix-pano klasörünü indir (ya da depoyu klonla).
    2. Terminalde o klasöre gir ve pip install -r requirements.txt yaz.
    3. streamlit run app.py yaz. Tarayıcında pano açılır.
    4. Netflix’ten indirdiğin NetflixViewingHistory.csv dosyasını yükleme kutusuna sürükle.

    Dosyayı Netflix’ten nasıl indireceğini ilk bölümde adım adım anlattım.

    Panoyu internete koymak

    Panoyu arkadaşlarınla paylaşmak istersen Streamlit Community Cloud’u kullanabilirsin: GitHub hesabınla giriş yapıp deponu ve app.py dosyasını seçiyorsun, uygulama birkaç dakika içinde bir web adresinde yayına giriyor. Uygulama kimsenin verisini kendi içinde taşımıyor; her ziyaretçi kendi dosyasını yüklüyor.

    Gizlilik notu: Uygulama yüklenen dosyayı hiçbir yere kaydetmiyor, sadece açık olan oturumda işliyor. Yine de ham CSV dosyanı GitHub gibi herkese açık bir yere koyma. İzleme geçmişi, ne zaman uyanık olduğuna kadar çok şey anlatır. Paylaşırken sadece toplamları ve grafikleri paylaş; ben de bu yazıda öyle yaptım.

    Panoda ne gördüm?

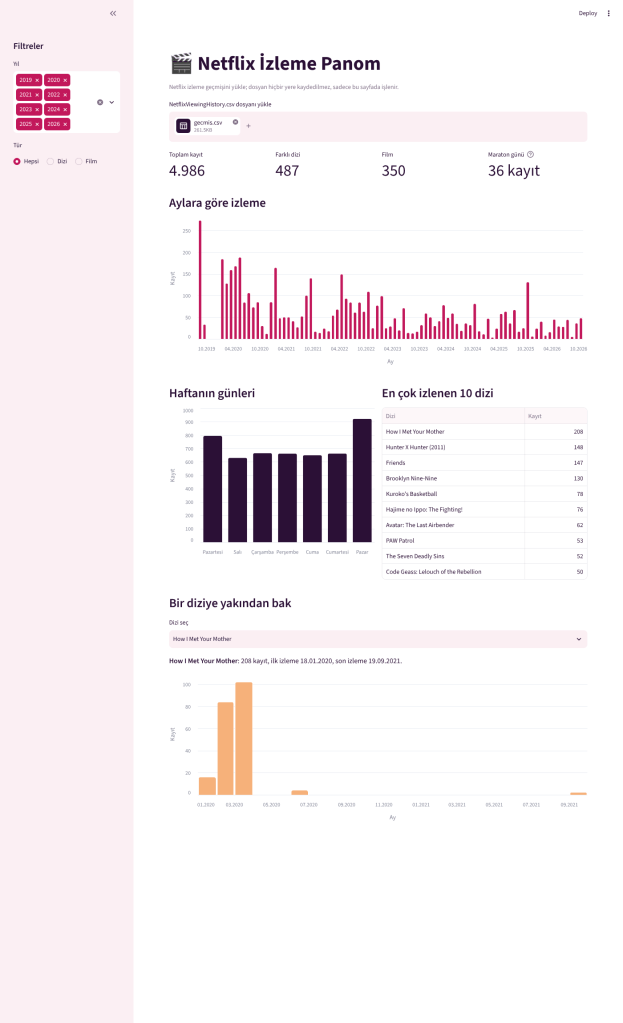
    Kendi verimi yükleyince pano şunları gösterdi:

    • Ağustos 2019’dan bu yana toplam 4.986 kayıt, 487 farklı dizi ve 350 film.
    • Haftanın en çok izlediğim günü Pazar, ikinci sırada Pazartesi. Hafta içinin diğer günleri birbirine çok yakın.
    • Maraton günümde 36 kayıt var.

    Kendin dene

    • Kenar çubuğuna bir saat filtresi ekleyemezsin, çünkü Netflix dosyasında saat yok. Ama bir ay filtresi ekleyebilirsin: st.slider ile 1-12 arası seçim yap.
    • “En çok izlenen 10 dizi” yerine kullanıcının kaç dizi görmek istediğini seçmesini sağla: st.number_input("Kaç dizi?", 5, 30, 10).
    • Bir arkadaşınla karşılaştır: İki dosya yükletip iki kişinin haftalık çubuklarını yan yana göster.

    Bir sonraki pop kültür projesinde Netflix verisini bir adım daha ileri taşıyıp basit bir öneri sistemi yazacağız: “Netflix’te Ne İzlesem?”