Bir banka, müşterilerini telefonla arayıp vadeli mevduat hesabı açmalarını teklif ediyor. On kişiyi arasın, dokuzu “hayır” diyor. Peki kimi aramalı? Bu hafta sonu projesinde gerçek bir banka kampanyasının verisiyle bu soruya cevap arıyoruz.
Yol boyunca veri biliminin üç klasik tuzağına da basacağız: gizli eksik değerler, yanıltıcı bir başarı ölçüsü ve modelin gelecekten haber alması.
Tüm kodlar Google Colab’da çalışıyor. Colab tarayıcıda açılıyor ve kodu Google’ın sunucularında çalıştırıyor; bu projede kullandığımız pandas, scikit-learn ve matplotlib orada hazır geliyor. Yani bilgisayarına hiçbir şey kurman gerekmiyor, bir Google hesabı yeterli: Colab’da aç
Veri seti
Veri, bir Portekiz bankasının 2008-2010 yılları arasındaki telefonla pazarlama kampanyalarından geliyor ve UCI Machine Learning Repository’de CC BY 4.0 lisansıyla paylaşılıyor. Her satır anonim bir müşteriyle yapılan bir görüşme; isim ya da kimlik bilgisi yok.
Sütunlar dört gruba ayrılıyor:
- Müşteri: yaş, meslek, medeni durum, eğitim, kredi durumu
- Bu kampanyadaki görüşme: ay, gün, iletişim türü, görüşme süresi, kaçıncı arama olduğu
- Geçmiş: önceki kampanyada aranıp aranmadığı ve sonucu
- Ekonomi: istihdam, enflasyon endeksi, faiz gibi o döneme ait göstergeler
Hedef sütun y: müşteri vadeli mevduat açtı mı (yes), açmadı mı (no)?
Veriyi indirmek
UCI dosyayı iç içe iki zip olarak veriyor. Diske tek tek açmak yerine bellekte açıyoruz:
import ioimport osimport zipfileimport numpy as npimport pandas as pdimport requestsDOSYA = "bank-additional-full.csv"URL = "https://archive.ics.uci.edu/static/public/222/bank+marketing.zip"def veriyi_indir(): dis = zipfile.ZipFile(io.BytesIO(requests.get(URL, timeout=60).content)) ic_adi = [a for a in dis.namelist() if a.endswith("bank-additional.zip")][0] ic = zipfile.ZipFile(io.BytesIO(dis.read(ic_adi))) csv_adi = [a for a in ic.namelist() if a.endswith(DOSYA)][0] with open(DOSYA, "wb") as f: f.write(ic.read(csv_adi))if not os.path.exists(DOSYA): veriyi_indir()df = pd.read_csv(DOSYA, sep=";")print(df.shape)
(41188, 21)
sep=";" kısmına dikkat et. Bu dosyada ayırıcı virgül değil, noktalı virgül. Vermezsen pandas her satırı tek bir uzun sütun sanır.
İlk bakış: on kişiden biri
print("Tekrarlanan satır:", df.duplicated().sum())df = df.drop_duplicates().reset_index(drop=True)df["hedef"] = (df["y"] == "yes").astype(int)print(f"Vadeli mevduat açanların oranı: %{df['hedef'].mean() * 100:.1f}")
Tekrarlanan satır: 12Vadeli mevduat açanların oranı: %11.3
12 tekrar eden satırı sildikten sonra elimizde 41.176 görüşme kalıyor ve bunların yalnızca yüzde 11,3’ü “evet” ile bitmiş. Bir sınıfın diğerinden çok daha az olduğu bu duruma dengesiz sınıf deniyor. Aklında tut, birazdan canımızı sıkacak.
Gizli eksikler: unknown ve 999
df.isna().sum() bu veride her sütun için sıfır gösterir. Ama bu, eksik veri olmadığı anlamına gelmiyor. Eksikler iki kılıkta saklanıyor:
- Kategorik sütunlarda
"unknown"yazısı. En çokdefaultsütununda (kredi borcunu ödememiş mi?): 8.596 satır, yani neredeyse her beş kişiden biri. pdayssütununda999değeri. Müşterinin daha önce hiç aranmadığı anlamına geliyor ve satırların yüzde 96’sında bu değer var.
Bu satırları silmiyoruz. “Bu soruya cevap vermemiş olmak” da bir bilgi; unknown kendi başına bir kategori olarak kalıyor. 999’u ise ortalamaya katılırsa sonucu saçma bir yere çekecek sıradan bir sayı gibi değil, “hiç” anlamında okuyoruz.
Yeni bir veri setine başlarken
isna()ile yetinme. Her kategorik sütununvalue_counts()çıktısına bir kez göz at; eksikler genelde orada saklanır.
Keşif: hangi grupta evet oranı yüksek?
Aynı hesabı birçok sütun için yapacağımızdan küçük bir fonksiyon yazıyoruz:
def oran_tablosu(sutun, sira=None): t = df.groupby(sutun, observed=True)["hedef"].agg(gorusme="size", evet_orani="mean") if sira is not None: t = t.reindex(sira) t["evet_orani"] = (t["evet_orani"] * 100).round(1) return toran_tablosu("poutcome")
| Önceki kampanyanın sonucu | Görüşme | Evet oranı |
|---|---|---|
| Başarılı (evet demiş) | 1.373 | %65,1 |
| Başarısız | 4.252 | %14,2 |
| Daha önce aranmamış | 35.551 | %8,8 |
Geçen sefer “evet” diyen müşterilerin üçte ikisi bu sefer de evet demiş. Tek bir sütun, ortalamanın neredeyse altı katı bir oran gösteriyor.
Aynı fonksiyonla baktığımız diğer gruplardan öne çıkanlar:
- İletişim türü: Cep telefonundan aranan müşterilerde oran %14,7, sabit hattan arananlarda %5,2.
- Yaş: 66 yaş ve üstünde %46,9, 17-25 arasında %21,0. Aradaki yaş grupları %8-15 arasında kalıyor. Ama 66+ grubunda sadece 618 görüşme var.
- Arama sayısı: İlk aramada oran %13,0; altı ve daha fazla aranmış kişilerde %5,5. Aynı müşteriyi ısrarla aramak işe yaramıyor gibi.
Ay tablosu ve korelasyon tuzağı
AYLAR = ["mar", "apr", "may", "jun", "jul", "aug", "sep", "oct", "nov", "dec"]oran_tablosu("month", AYLAR)
Mart, eylül, ekim ve aralıkta evet oranı %44 ile %51 arasında. Mayıs’ta ise %6,4. “Demek ki martı beklemek lazım” demek çok cazip.
Ama görüşme sayılarına bak: mayısta 13.767 görüşme var, aralıkta 182. Az aranan aylarda banka belki de zaten ilgili olduğunu bildiği müşterileri aradı. Bu tablo ayın sonucu değiştirdiğini göstermiyor; sadece ikisinin birlikte hareket ettiğini gösteriyor. Korelasyon, nedensellik değildir.
duration tuzağı: veri sızıntısı
duration, görüşmenin saniye cinsinden süresi:
df.groupby("y")["duration"].median()
yno 164.0yes 449.0
Evet diyenlerle görüşme, ortanca değere göre neredeyse üç kat uzun sürmüş. Doğal: ikna olan müşteriyle hesap açmanın detaylarını konuşuyorsun. Bu sütun modele girerse sonucu çok iyi tahmin eder.
Sorun şu: bankanın asıl sorusu “kimi arayalım?” ve bu soru arama yapılmadan önce soruluyor. O anda görüşmenin ne kadar süreceğini bilemezsin. Tahmin anında elinde olmayacak bir bilgiyi modele vermeye veri sızıntısı (data leakage) deniyor. Veri setinin kendi açıklaması da gerçekçi bir model için bu sütunun çıkarılmasını öneriyor. Biz de çıkarıyoruz.
Model: lojistik regresyon
from sklearn.compose import ColumnTransformerfrom sklearn.linear_model import LogisticRegressionfrom sklearn.model_selection import train_test_splitfrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import OneHotEncoder, StandardScalerCIKAR = ["y", "hedef", "duration", "yas_grubu", "arama_sayisi"]X = df.drop(columns=CIKAR)y = df["hedef"]X_egitim, X_test, y_egitim, y_test = train_test_split( X, y, test_size=0.25, stratify=y, random_state=42)kategorik = X.select_dtypes(exclude="number").columns.tolist()sayisal = X.select_dtypes(include="number").columns.tolist()def model_kur(kategorik, sayisal): hazirlik = ColumnTransformer([ ("kategorik", OneHotEncoder(handle_unknown="ignore"), kategorik), ("sayisal", StandardScaler(), sayisal), ]) return Pipeline([ ("hazirlik", hazirlik), ("model", LogisticRegression(max_iter=2000, class_weight="balanced")), ])model = model_kur(kategorik, sayisal)model.fit(X_egitim, y_egitim)olasilik = model.predict_proba(X_test)[:, 1]tahmin = (olasilik >= 0.5).astype(int)
(yas_grubu ve arama_sayisi, keşif bölümünde tablolar için eklediğimiz yardımcı sütunlar; not defterinde oluşturuluyorlar.)
Satır satır ne yaptık:
stratify=y: Eğitim ve test setinde evet oranı aynı kalsın. Dengesiz veride bunu unutursan test setine şans eseri çok az “evet” düşebilir.OneHotEncoder: “meslek = öğrenci” gibi metin değerlerini 0-1 sütunlarına çevirir. Model sadece sayılarla çalışır.StandardScaler: Yaş (17-98) ile faiz oranı (0-5) gibi farklı ölçekteki sayıları aynı ölçeğe getirir.class_weight="balanced": Az olan “evet” sınıfındaki hataları daha ağır cezalandır. Bunu yazmazsan model, hemen herkese “hayır” demenin kolay yolunu seçer.Pipeline: Hazırlık ve modeli tek bir nesnede toplar. Böylece test verisine eğitimde öğrenilen dönüşümün aynısı uygulanır.
Accuracy neden yanıltır?
Hiçbir şey öğrenmemiş, herkese “hayır” diyen bir model düşün:
from sklearn.metrics import accuracy_scoreherkese_hayir = np.zeros(len(y_test), dtype=int)print(f"Herkese 'hayır' diyen model accuracy: %{accuracy_score(y_test, herkese_hayir) * 100:.1f}")print(f"Bizim modelin accuracy'si: %{accuracy_score(y_test, tahmin) * 100:.1f}")
Herkese 'hayır' diyen model accuracy: %88.7Bizim modelin accuracy'si: %83.3
Hiçbir şey öğrenmemiş model daha “başarılı” görünüyor. Oysa bankaya tek bir müşteri kazandırmaz. Dengesiz veride accuracy, çoğunluk sınıfını ne kadar iyi tahmin ettiğini ölçer; bizi ilgilendiren azınlık sınıfı ise kaybolur.
Bu yüzden başka ölçülere bakıyoruz. Test setindeki 10.294 görüşmede bizim model:
| Sayı | |
|---|---|
| Doğru yakalanan “evet” | 742 |
| Kaçırılan “evet” | 418 |
| Boşa aranan (evet tahmin edildi, hayır dedi) | 1.300 |
| Doğru “hayır” | 7.834 |
- Recall (duyarlılık): Gerçekten evet diyenlerin yüzde kaçını yakaladık? 742 / 1.160 = %64
- Precision (kesinlik): Evet dediğimiz kişilerin yüzde kaçı gerçekten evet dedi? 742 / 2.042 = %36
- ROC-AUC: Model, rastgele seçilmiş bir “evet”i rastgele seçilmiş bir “hayır”ın önüne ne sıklıkla koyuyor? 0,5 yazı tura, 1 kusursuz. Bizim model: 0,80
Precision’ın %36 olması kötü gibi görünebilir. Ama rastgele arasan bu oran %11 olurdu; model aynı emekle üç kattan fazla müşteri buluyor.
Asıl soru: kimi önce aramalı?
Banka herkesi arayamaz. Modelin verdiği olasılığa göre müşterileri sıralayıp onluk dilimlere ayıralım. 1. dilim, modelin en umutlu bulduğu yüzde 10.
sirali = pd.DataFrame({"gercek": y_test.to_numpy(), "olasilik": olasilik})sirali = sirali.sort_values("olasilik", ascending=False).reset_index(drop=True)sirali["dilim"] = sirali.index * 10 // len(sirali) + 1dilimler = sirali.groupby("dilim")["gercek"].agg(kisi="size", evet="sum", evet_orani="mean")
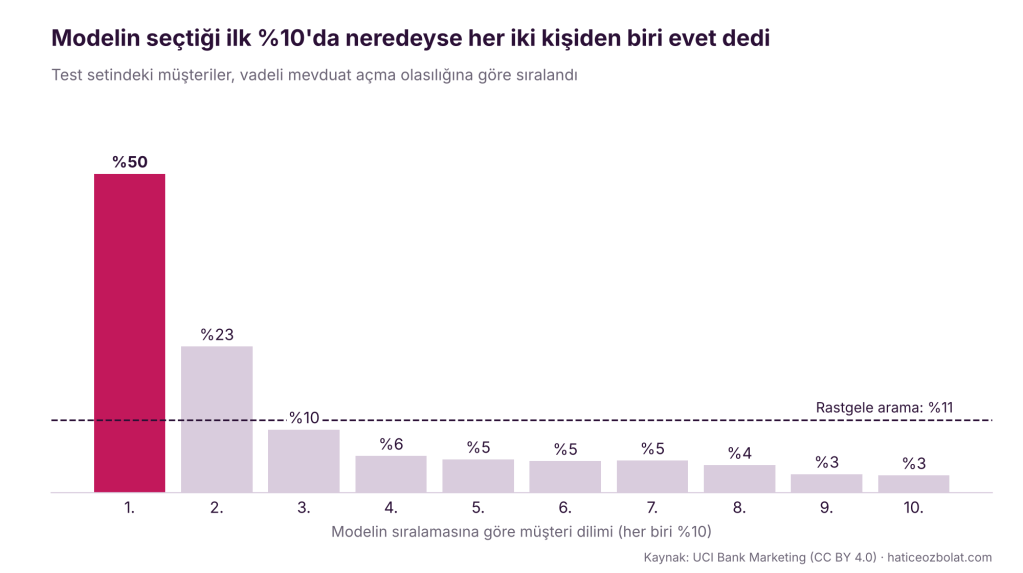
Modelin en umutlu bulduğu yüzde 10’luk dilimde 1.030 kişiden 510’u evet demiş: yaklaşık her iki kişiden biri. Bu dilim, test setindeki tüm evetlerin yüzde 44’ünü tek başına yakalıyor. Yani banka, listenin sadece onda birini arayarak müşterilerin neredeyse yarısına ulaşabilir.
Bir model, her şeyi doğru tahmin etmek zorunda değil. Bazen tek işi doğru sıralamaktır.
Sızıntılı model ne kadar iyi görünürdü?
Aynı modeli bir de duration dahil kurduğumuzda (not defterinin 10. bölümü):
duration olmadan ROC-AUC: 0.802duration ile ROC-AUC: 0.940
0,94 çok daha parlak duruyor ve bir sunumda insanları kolayca etkiler. Ama gerçek hayatta kullanılamaz. Bir model fazla iyi çıktığında ilk soracağın soru şu olmalı: Bu bilgi, tahmin anında elimde olacak mı?
Bu projeden kalanlar
- Eksik veri her zaman
NaNolarak gelmez;unknownve999gibi kılıklara bak. - Grup oranlarına bakarken görüşme sayısını da yaz. Küçük gruplardaki uç oranlar akıl karıştırır.
- Dengesiz veride accuracy’ye güvenme; recall, precision ve ROC-AUC’ye bak.
- Modeli işin sorusuna göre değerlendir. Burada soru “kimi önce arayalım?” olduğu için sıralama kalitesi asıl ölçü.
- “Fazla iyi” sonuçlarda veri sızıntısından şüphelen.
Kendin dene
class_weight="balanced"parametresini sil. Recall ve precision nasıl değişti?- Eşiği 0,5 yerine 0,3 ve 0,7 yap. Yakalanan ve boşa aranan kişi sayıları nasıl değişiyor?
LogisticRegressionyerineRandomForestClassifierdene. ROC-AUC artıyor mu?educationsütunu içinoran_tablosuçalıştır. Ne görüyorsun?
Kaynak ve lisans
Moro, S., Cortez, P. ve Rita, P. (2014). A Data-Driven Approach to Predict the Success of Bank Telemarketing. Decision Support Systems, 62, 22-31. Veri: UCI Machine Learning Repository, Bank Marketing, CC BY 4.0.